Ejecuta cargas de trabajo cuánticas con QRMI
Estimación de uso: menos de un minuto en hardware de IBM Quantum® para la sección de SQD. Esta estimación excluye el tiempo de cola y el procesamiento clásico; el tiempo de ejecución puede variar.
Resultados de aprendizaje
-
El papel que desempeña QRMI como middleware entre los planificadores de HPC y el hardware de IBM Quantum
-
Cómo usar el ciclo de vida principal de QRMI (
acquire→task_start→task_status→task_result→release) con un backend real de IBM® -
Cómo usar los wrappers de más alto nivel
SamplerV2yQRMIServicede Qiskit sobre QRMI -
Cómo los planificadores de HPC (Slurm) inyectan recursos cuánticos mediante variables de entorno y cómo las aplicaciones los consumen
-
Cómo ejecutar un flujo de trabajo completo de química SQD (Diagonalización Cuántica Basada en Muestreo) en N usando hardware de IBM a través de QRMI
Requisitos previos
-
Familiaridad básica con entornos virtuales de Python y química cuántica
Contexto
El desafío de integración cuántica-HPC
Los flujos de trabajo de computación de alto rendimiento (HPC) a menudo requieren una coordinación fluida entre los clústeres de computación clásica y las unidades de procesamiento cuántico (QPUs). Los diferentes Backends y servicios de hardware cuántico exponen mecanismos de autenticación, formatos de transmisión de datos y APIs de ciclo de vida de trabajos distintos. Integrar los sistemas de IBM Quantum en los gestores de cargas de trabajo HPC (como Slurm) requiere una interfaz limpia y estándar para la adquisición de recursos, la ejecución de trabajos y la gestión de sesiones.
Qué es QRMI
La Quantum Resource Management Interface (QRMI) es una biblioteca de middleware escrita en Rust que estandariza el acceso al hardware cuántico desde los planificadores HPC y las aplicaciones clásicas. Expone una única API de ciclo de vida unificada:
┌─────────────────────────────────────────────────────────────────┐
│                     HPC Application Layer                       │
│          (Slurm job script / Python workflow / CUDA-Q)          │
└───────────────────────────┬─────────────────────────────────────┘
                            │  QRMI API
                            │  acquire() / task_start() / task_result() / release()
┌───────────────────────────▼─────────────────────────────────────┐
│                        QRMI Core (Rust)                         │
│            Python bindings · C bindings · Lua bindings          │
└───────────────────────────┬─────────────────────────────────────┘
                            │
               IBM Quantum Compute Service / IBM Quantum System
QRMI se publica como un proyecto de código abierto en github.com/qiskit-community/qrmi y se describe en el artículo de resumen arXiv:2506.10052.
Decisiones clave de diseño
Ciclo de vida de recursos, no compilación de circuitos. QRMI gestiona el ciclo de vida de adquisición/envío/sondeo/liberación y nada más. La compilación, optimización y transpilación de circuitos permanecen en la capa de aplicación (por ejemplo, Qiskit). Esto mantiene la interfaz mínima y componible.
Modelo de portabilidad entre proveedores. Si bien QRMI proporciona llamadas comunes de gestión de trabajos (acquire, task_start, task_status, task_result, release) en los distintos Backends de hardware compatibles, cambiar de proveedor también requiere diferentes pasadas de compilación, la construcción de payloads específicos del proveedor y la decodificación de resultados en la capa de aplicación.
Formato de payload nativo de IBM. Para los Backends de IBM Quantum, QRMI utiliza payloads JSON de OpenQASM 3 (QiskitPrimitive) que se ajustan al esquema de Qiskit Runtime.
Configuración mediante variables de entorno. Las credenciales y las URLs de los endpoints se leen desde variables de entorno en tiempo de ejecución. En un clúster HPC, el plugin QRMI SPANK de Slurm las configura automáticamente cuando se despacha un trabajo. En un notebook o sesión interactiva, las cargas desde un archivo .env. El código de la aplicación nunca contiene credenciales ni URLs de endpoints codificadas de forma fija.
Integración con el planificador HPC mediante GRES. Cuando un trabajo de Slurm solicita recursos cuánticos utilizando la interfaz del plugin QRMI SPANK (#SBATCH --gres=qpu:1 y #SBATCH --qpu=ibm_kingston), el plugin inyecta QRMI_JOB_QPU_RESOURCES y QRMI_JOB_QPU_TYPES en el entorno del trabajo. Las aplicaciones llaman a get_job_qpu_resources_and_types() para descubrir qué recursos se asignaron — sin necesidad de nombres de Backend codificados de forma fija. QRMIService envuelve este patrón para los usuarios de Qiskit.
Las llamadas API principales
| Llamada | Propósito |
|---|---|
qrmi.acquire() | Adquiere acceso al recurso (por ejemplo, abre una sesión dedicada); devuelve un token de bloqueo |
qrmi.target() | Recupera las capacidades del Backend (Qubits, puertas, mapa de acoplamiento) como JSON |
qrmi.task_start(payload) | Envía un trabajo cuántico; devuelve un ID de trabajo |
qrmi.task_status(job_id) | Sondea el estado del trabajo (Queued, Running, Completed, Failed) |
qrmi.task_result(job_id) | Recupera los resultados del trabajo completado como una cadena JSON sin procesar |
qrmi.task_stop(job_id) | Cancela o limpia un trabajo |
qrmi.release(lock) | Libera el bloqueo del recurso (por ejemplo, cierra la sesión) |
Qué cubre este tutorial
Este tutorial está estructurado en dos partes:
Pasos 1–3 (ejemplos a pequeña escala): Presentan la API de QRMI con una demostración sencilla de un circuito de estado de Bell en hardware de IBM Quantum, abarcando tanto el uso directo de primitivas de bajo nivel como la integración de alto nivel con QRMIService y SamplerV2.
Ejemplo de hardware a gran escala: Un flujo de trabajo SQD completo para la molécula N a una distancia de enlace de 1.0 (espacio activo de la base cc-pVDZ, 26 orbitales espaciales / 52 Qubits), ejecutado en hardware de IBM Quantum a través de QRMI. SQD combina el muestreo cuántico de un ansatz LUCJ construido con ffsim y la recuperación de configuración autoconsistente con qiskit-addon-sqd.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"dotenv": "python-dotenv", "ffsim": "ffsim", "matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit": "qiskit", "qiskit_addon_sqd": "qiskit-addon-sqd", "qrmi": "qrmi"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
Requisitos
Antes de comenzar este tutorial, asegúrate de tener instalado lo siguiente.
Configuración del entorno de Python
Hay wheels binarios precompilados disponibles para Linux en PyPI, por lo que el pip install estándar funciona directamente en sistemas Linux/HPC.
python3 -m venv ~/.venvs/qrmi-ibm
source ~/.venvs/qrmi-ibm/bin/activate
python -m pip install "qrmi[ibm]" python-dotenv pyscf ffsim qiskit-addon-sqd matplotlib ipykernel
python -m ipykernel install --user --name qrmi-ibm --display-name "QRMI IBM"
Si pip compila QRMI desde el código fuente, asegúrate de tener una toolchain de Rust moderna (Rust ≥ 1.91.1 instalado mediante rustup desde rustup.rs).
Selecciona el kernel QRMI IBM en Jupyter, luego reinícialo y ejecuta las celdas del notebook en orden. Los resultados guardados provienen de la ejecución en hardware del colaborador; los comandos de instalación no especifican las versiones exactas utilizadas en esa ejecución.
Credenciales necesarias
- IBM Quantum: clave de API de IAM y CRN de servicio de IBM Quantum Platform
Para una ejecución independiente, crea un archivo .env junto a este notebook con los siguientes valores, reemplazando los marcadores de posición de las credenciales. Mantén este archivo privado. Si seleccionas un Backend diferente, actualiza tanto su nombre como los prefijos de las variables de entorno.
ibm_kingston_QRMI_IBM_QCS_ENDPOINT=https://quantum.cloud.ibm.com/api/v1
ibm_kingston_QRMI_IBM_QCS_IAM_ENDPOINT=https://iam.cloud.ibm.com
ibm_kingston_QRMI_IBM_QCS_IAM_APIKEY=<your-iam-api-key>
ibm_kingston_QRMI_IBM_QCS_SERVICE_CRN=<your-crn-starting-with-crn:v1:>
ibm_kingston_QRMI_IBM_QCS_SESSION_MODE=dedicated
ibm_kingston_QRMI_IBM_QCS_SESSION_MAX_TTL=28800
QRMI_JOB_QPU_RESOURCES=ibm_kingston
QRMI_JOB_QPU_TYPES=ibm-quantum-compute-service
Para una asignación de Slurm, utiliza la configuración de recursos y las credenciales proporcionadas por el clúster. El notebook conserva los valores de entorno existentes.
Configuración
Importa las dependencias y carga la configuración de los recursos.
import os
import time
import json
import numpy as np
from dotenv import load_dotenv

from qrmi import (
    QuantumResource,
    ResourceType,
    Payload,
    TaskStatus,
    get_job_qpu_resources_and_types,
)
from qrmi.primitives import QRMIService
from qrmi.primitives.ibm import SamplerV2, get_target

from qiskit import QuantumCircuit, qasm3
from qiskit.circuit.library import efficient_su2
from qiskit.primitives.containers.sampler_pub import SamplerPub
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# Load credentials from .env without overriding already-set scheduler environment variables
load_dotenv(override=False)

# Preserve resources if injected by Slurm SPANK plugin; fallback to default for interactive run
BACKEND_NAME = os.environ.get("QRMI_JOB_QPU_RESOURCES", "ibm_kingston")
os.environ.setdefault("QRMI_JOB_QPU_RESOURCES", BACKEND_NAME)
os.environ.setdefault("QRMI_JOB_QPU_TYPES", "ibm-quantum-compute-service")

print(f"Backend: {BACKEND_NAME}")
print("Environment ready.")
Backend: ibm_kingston
Environment ready.
Ejemplos a pequeña escala
Los pasos 1–3 presentan la API de QRMI mediante circuitos sencillos. Cada paso corresponde a una fase central del ciclo de vida de QRMI frente al hardware de IBM Quantum.
El payload para estos pasos iniciales es un pequeño circuito de estado de Bell elegido para que sea rápido y económico de ejecutar.
Estos ejemplos utilizan hardware porque demuestran la asignación remota de recursos y la gestión de trabajos. Un simulador de circuitos local no valida el servicio de QRMI ni la integración con el planificador. Ejecutar este notebook envía trabajos de IBM Quantum y requiere acceso al Backend configurado.
Paso 1: Asignar el problema clásico a un recurso cuántico
El primer paso en cualquier flujo de trabajo de QRMI es crear un objeto QuantumResource y verificar que sea accesible.
get_target() recupera la descripción del hardware del Backend (número de Qubits, puertas base, mapa de acoplamiento) y la empaqueta como un objeto Target de Qiskit, que el transpilador utiliza en el paso 2.
Paso 2: Optimizar el problema para la ejecución en hardware cuántico
Antes del envío, utiliza Qiskit para transpilar el circuito a la arquitectura de conjunto de instrucciones (ISA) del Backend, utilizando el objeto Target recuperado en el paso 1.
A continuación, el ejemplo construye un Payload.QiskitPrimitive, que envuelve la cadena del circuito en OpenQASM 3 y los metadatos del trabajo en el esquema de primitivas de IBM.
Paso 3: Ejecutar utilizando primitivas de QRMI
Una vez construido el payload, el ejemplo envía el trabajo y sondea hasta su finalización. task_start() devuelve un ID de trabajo de inmediato; task_status() se sondea hasta que el estado deja de ser Queued/Running. Los resultados se recuperan como una cadena JSON sin procesar y se analizan para extraer las muestras de medición.
La siguiente celda mantiene juntos la adquisición, la ejecución y la limpieza, de modo que los fallos posteriores a la adquisición sigan liberando una sesión propiedad del notebook.
# ── IBM Quantum ───────────────────────────────────────────────────────
qrmi = QuantumResource(BACKEND_NAME, ResourceType.IBMQuantumComputeService)
# ResourceType.IBMQuantumSystem is the alternative for directly provisioned systems

print(f"Resource id:   {qrmi.resource_id()}")
print(f"Resource type: {qrmi.resource_type()}")
print(f"Accessible:    {qrmi.is_accessible()}")

# Acquire exclusive access — open try/finally immediately so every
# subsequent failure (target retrieval, transpilation, submission) is covered.
# Release is skipped when running under Slurm: the SPANK plugin owns the
# session lifecycle and will release it when the job finishes.
lock = qrmi.acquire()
print(f"Lock token:    {lock}")
try:
    # Retrieve backend capabilities
    transpiler_target = get_target(
        qrmi
    )  # calls qrmi.target() and parses the JSON
    target_json = json.loads(qrmi.target().value)
    config = target_json.get("configuration", {})
    print(f"\nBackend: {config.get('backend_name', 'unknown')}")
    print(f"Qubits:  {config.get('n_qubits', 'unknown')}")
    print(f"Gates:   {config.get('basis_gates', [])}")

    # ── IBM Quantum ───────────────────────────────────────────────────

    # Build a Bell state circuit
    qc = QuantumCircuit(2)
    qc.h(0)
    qc.cx(0, 1)
    qc.measure_all()
    print(qc.draw("text"))

    # Transpile to ISA using the target retrieved in Step 1
    pm = generate_preset_pass_manager(
        optimization_level=1, target=transpiler_target
    )
    isa_circuit = pm.run(qc)
    print(f"\nTranspiled gate counts: {isa_circuit.count_ops()}")

    # Build the QRMI payload
    # Payload.QiskitPrimitive wraps the IBM SamplerV2 input schema:
    #   pubs: list of [qasm3_string, parameter_values]  (shots goes at top level)
    #   program_id: "sampler" or "estimator"
    shots = 1024
    pub = SamplerPub.coerce((isa_circuit,), shots)
    qasm3_str = qasm3.dumps(
        pub.circuit,
        disable_constants=True,
        allow_aliasing=True,
        experimental=qasm3.ExperimentalFeatures.SWITCH_CASE_V1,
    )
    # Parameter values as a flat list (empty for non-parametric circuits)
    param_array = pub.parameter_values.as_array(
        pub.circuit.parameters
    ).tolist()

    input_json = {
        "pubs": [
            [qasm3_str, param_array]
        ],  # list-of-lists; shots at top level
        "version": 2,
        "support_qiskit": False,  # True returns binary-encoded Qiskit result
        "shots": shots,
    }
    payload = Payload.QiskitPrimitive(
        input=json.dumps(input_json), program_id="sampler"
    )
    print("Payload ready")

    # ── IBM Quantum ───────────────────────────────────────────────────

    # Submit the job
    job_id = qrmi.task_start(payload)
    print(f"Job submitted: {job_id}")

    # Poll until complete
    while True:
        status = qrmi.task_status(job_id)
        print(f"  Status: {status}")
        if status not in [TaskStatus.Running, TaskStatus.Queued]:
            break
        time.sleep(5)

    print(f"\nFinal status: {status}")

    # Retrieve results
    # support_qiskit=False → plain JSON; parse directly without ResultDecoder
    if status == TaskStatus.Completed:
        raw = qrmi.task_result(job_id).value
        result = json.loads(raw)
        # IBM QCS plain-JSON result shape: {"results": [{"data": {"meas": {"samples": [...]}}}]}
        # samples is a list of hex-encoded integers; decode to zero-padded bitstrings
        samples = result["results"][0]["data"]["meas"]["samples"]
        num_bits = sum(reg.size for reg in isa_circuit.cregs)
        from collections import Counter

        counts = Counter(format(int(s, 16), f"0{num_bits}b") for s in samples)
        print(f"\nMeasurement counts: {dict(counts.most_common(8))}")
        qrmi.task_stop(job_id)
    else:
        print(f"Job did not complete. Logs:\n{qrmi.task_logs(job_id)}")

finally:
    # Release only in interactive sessions; under Slurm the SPANK plugin
    # manages the session lifecycle and calling release() here would
    # prematurely close a session it does not own.
    if not os.environ.get("SLURM_JOB_ID"):
        qrmi.release(lock)
        print("\nSession released.")
Resource id:   ibm_kingston
Resource type: ResourceType.IBMQuantumComputeService
Accessible:    True
Lock token:    2ff43011-aed1-4436-a4df-40f37ec588b7

Backend: ibm_kingston
Qubits:  156
Gates:   ['cz', 'id', 'rx', 'rz', 'rzz', 'sx', 'x', 'xslow']
        ┌───┐      ░ ┌─┐
   q_0: ┤ H ├──■───░─┤M├───
        └───┘┌─┴─┐ ░ └╥┘┌─┐
   q_1: ─────┤ X ├─░──╫─┤M├
             └───┘ ░  ║ └╥┘
meas: 2/══════════════╩══╩═
                      0  1

Transpiled gate counts: OrderedDict([('rz', 6), ('sx', 3), ('measure', 2), ('cz', 1), ('barrier', 1)])
Payload ready
Job submitted: dai43g8mhr3c73e7a7o0
  Status: TaskStatus.Queued
  Status: TaskStatus.Running
  Status: TaskStatus.Completed

Final status: TaskStatus.Completed

Measurement counts: {'11': 487, '00': 254, '01': 177, '10': 106}

Session released.
Interfaz de Qiskit de alto nivel: QRMIService y SamplerV2
El ciclo de vida de bajo nivel anterior ofrece un control explícito sobre cada llamada. Para los flujos de trabajo estándar de Qiskit, QRMI proporciona una primitiva SamplerV2 que implementa BaseSamplerV2.
SamplerV2 gestiona la serialización del payload, el envío (task_start), el sondeo y la decodificación de resultados. En un entorno por lotes de HPC (por ejemplo, con Slurm), la asignación y la liberación son gestionadas por el planificador y el plugin SPANK. En una sesión de Python interactiva que utiliza directamente objetos de la API de bajo nivel, acquire() y release() se pueden usar para gestionar explícitamente sesiones dedicadas.
# QRMIService reads QRMI_JOB_QPU_RESOURCES / QRMI_JOB_QPU_TYPES set in Setup or Slurm
service = QRMIService()
qrmi_svc = service.resources()[0]
print(f"Using: {qrmi_svc.resource_id()} ({qrmi_svc.resource_type()})")

# Build an EfficientSU2 circuit
circuit = efficient_su2(5, entanglement="linear")
circuit.measure_all()
param_values = np.random.rand(circuit.num_parameters)

pm = generate_preset_pass_manager(
    optimization_level=1, target=get_target(qrmi_svc)
)
isa_circuit = pm.run(circuit)

# SamplerV2 executes jobs against the QRMI resource and decodes results into primitive containers
sampler = SamplerV2(qrmi_svc, options={"default_shots": 1024})
job = sampler.run([(isa_circuit, param_values)])
print(f"Job ID: {job.job_id()} | Status: {job.status()}")

# Poll with retry — re-raise immediately on permanent failures;
# only retry on transient network/timeout errors (connection resets, 503s).
_TRANSIENT = (
    "503",
    "Service Unavailable",
    "ConnectionError",
    "TimeoutError",
    "timed out",
    "Connection reset",
)
result = None
for attempt in range(60):
    try:
        result = job.result()  # blocks until complete
        break
    except Exception as e:
        if not any(tok in str(e) for tok in _TRANSIENT):
            raise
        print(f"  Transient error on attempt {attempt + 1}: {e}")
        time.sleep(10)

if result is not None:
    counts = result[0].data.meas.get_counts()
    print(f"Counts (first 5): {dict(list(counts.items())[:5])}")
else:
    print("Job did not complete after retries.")

if job.errored():
    print(f"Logs:\n{job.logs()}")
Using: ibm_kingston (ResourceType.IBMQuantumComputeService)
Job ID: dai43jj9k43c73afhrhg | Status: JobStatus.QUEUED
Counts (first 5): {'00010': 66, '00100': 28, '11000': 71, '00110': 23, '10100': 14}
Contexto de HPC: inyección de recursos de Slurm
En un clúster HPC, los usuarios solicitan recursos cuánticos utilizando la sintaxis GRES de Slurm junto con las opciones del plugin QRMI SPANK. El plugin gestiona la inyección de credenciales y recursos de forma automática:
#SBATCH --gres=qpu:1
#SBATCH --qpu=ibm_kingston
python my_workflow.py   # QRMI_JOB_QPU_RESOURCES and QRMI_JOB_QPU_TYPES are already set
El código de la aplicación descubre sus recursos asignados en tiempo de ejecución — sin nombres de Backend codificados de forma fija:
# get_job_qpu_resources_and_types() reads QRMI_JOB_QPU_RESOURCES / QRMI_JOB_QPU_TYPES
# set by the Slurm SPANK plugin (or manually above in Setup)
qpus, qpu_types = get_job_qpu_resources_and_types()
print("Resources allocated by scheduler:")
for qpu, qpu_type in zip(qpus, qpu_types):
    print(f"  {qpu}  ({qpu_type})")

# QRMIService wraps this into a list of ready QuantumResource objects
for r in QRMIService().resources():
    print(
        f"\nQRMIService found: {r.resource_id()}  accessible={r.is_accessible()}"
    )
Resources allocated by scheduler:
  ibm_kingston  (ibm-quantum-compute-service)

QRMIService found: ibm_kingston  accessible=True
Ejemplo de hardware a gran escala: SQD en N
Aquí reunimos todos los componentes en un flujo de trabajo completo de química cuántica a mayor escala, ejecutado en hardware real de IBM Quantum a través de QRMI.
SQD combina lo siguiente:
- Muestreo cuántico de un ansatz Local Unitary Cluster Jastrow (LUCJ) construido mediante
ffsime inicializado a partir de amplitudes CCSD - Transpilación consciente del hardware que coincide con la topología de red heavy-hex mediante
generate_lucj_pass_manager - Ejecución de muestreo en hardware de IBM Quantum gestionado a través de
QRMIServicey QRMISamplerV2 - Postprocesamiento clásico: recuperación de configuración autoconsistente y diagonalización iterativa de subespacios utilizando
qiskit-addon-sqd
Aplicamos SQD a N a una distancia de enlace de 1.0 con un espacio activo derivado del conjunto de base cc-pVDZ (26 orbitales espaciales, correspondientes a 52 espín-orbitales/Qubits).
Energía de referencia para el espacio activo N /cc-pVDZ (distancia de enlace 1.0 ):
- Energía de referencia (cálculo SCI independiente): −109.22802922 Ha
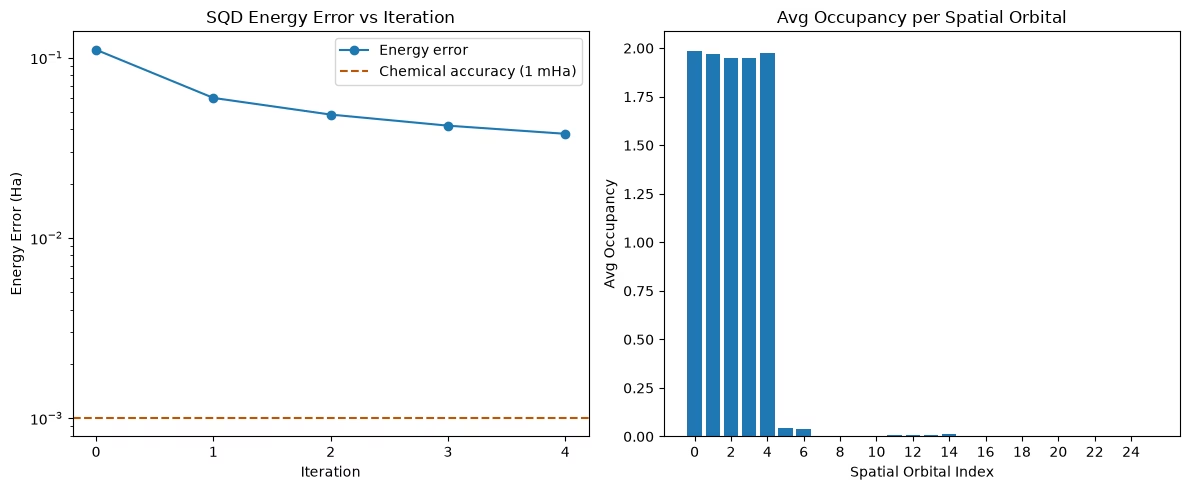
La ejecución de SQD que se muestra a continuación demuestra una ejecución de QRMI de extremo a extremo exitosa en hardware de IBM Quantum. Con una única repetición de LUCJ y 100,000 shots, el resultado termina aproximadamente 23.7 kcal/mol por encima de la energía de referencia y no alcanza la precisión química (≤ 1 kcal/mol). Cambiar n_reps, el número de shots o el número de iteraciones de SQD podría mejorar la precisión, pero requiere más pruebas.
En la ejecución guardada, el pass manager de ffsim eliminó las interacciones de espín opuesto (24, 24) y (20, 20) porque el Backend no pudo admitirlas. Los resultados reportados utilizan este circuito ajustado.
from qrmi.primitives.ibm import get_backend
import math
import os
import time
from functools import partial
from dotenv import load_dotenv
import numpy as np
import matplotlib.pyplot as plt

import pyscf
import pyscf.gto
import pyscf.scf
import pyscf.cc
import pyscf.mcscf
import pyscf.ao2mo

import ffsim
import ffsim.qiskit
from qiskit import QuantumCircuit, QuantumRegister
from qiskit_addon_sqd.fermion import (
    SCIResult,
    diagonalize_fermionic_hamiltonian,
    solve_sci_batch,
)
from qrmi.primitives import QRMIService
from qrmi.primitives.ibm import SamplerV2, get_target

load_dotenv(override=False)
os.environ.setdefault("QRMI_JOB_QPU_RESOURCES", "ibm_kingston")
os.environ.setdefault("QRMI_JOB_QPU_TYPES", "ibm-quantum-compute-service")

# ── Step 1: Map classical inputs to a quantum problem ─────────────────

# Build N2 molecule at 1.0 Å bond distance
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="cc-pvdz",
    symmetry="Dooh",
)

# Define active space: freeze 2 core orbitals
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
norb = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
n_alpha = (n_electrons + mol.spin) // 2
n_beta = (n_electrons - mol.spin) // 2
nelec = (n_alpha, n_beta)

cas = pyscf.mcscf.CASCI(scf, norb, nelec)
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), norb)

# Reference energy from external SCI calculation
reference_energy = -109.22802921665716

print(
    f"N₂/cc-pVDZ active space: {norb} orbitals ({2 * norb} qubits), {nelec} electrons"
)
print(f"SCF energy:       {scf.e_tot:.8f} Ha")
print(f"Reference energy: {reference_energy:.8f} Ha")

# Get CCSD amplitudes for initializing the LUCJ ansatz
ccsd = pyscf.cc.CCSD(
    scf, frozen=[i for i in range(mol.nao_nr()) if i not in active_space]
).run()
t1 = ccsd.t1
t2 = ccsd.t2
print(f"CCSD energy:      {ccsd.e_tot:.8f} Ha")

# Discover backend via QRMIService (QRMI_JOB_QPU_RESOURCES set in Setup)
service = QRMIService()
qrmi_sqd = service.resources()[0]
print(f"Using QRMI resource: {qrmi_sqd.resource_id()}")

# get_backend() wraps the QRMI resource as a Qiskit backend for layout synthesis

backend = get_backend(qrmi_sqd)

# Set ansatz properties
n_reps = 1
pairs_aa = [(p, p + 1) for p in range(norb - 1)]
pairs_ab = None

# Create pass manager adapted to hardware heavy-hex topology
pass_manager, pairs_ab = ffsim.qiskit.generate_lucj_pass_manager(
    backend=backend,
    norb=norb,
    connectivity="heavy-hex",
    interaction_pairs=(pairs_aa, pairs_ab),
    optimization_level=3,
)

# Create the compressed LUCJ ansatz operator
ucj_op = ffsim.UCJOpSpinBalanced.from_t_amplitudes(
    t2=t2,
    t1=t1,
    n_reps=n_reps,
    interaction_pairs=(pairs_aa, pairs_ab),
    optimize=True,
    options=dict(maxiter=1000),
)

# Assemble the circuit
qubits = QuantumRegister(2 * norb, name="q")
circuit = QuantumCircuit(qubits)
circuit.append(ffsim.qiskit.PrepareHartreeFockJW(norb, nelec), qubits)
circuit.append(ffsim.qiskit.UCJOpSpinBalancedJW(ucj_op), qubits)
circuit.measure_all()
print(f"LUCJ circuit: {circuit.num_qubits} qubits, depth {circuit.depth()}")

# ── Step 2: Optimize for quantum hardware execution ───────────────────

isa_circuit = pass_manager.run(circuit)
print(f"Transpiled gate counts: {isa_circuit.count_ops()}")

# ── Step 3: Execute using Qiskit primitives (QRMI SamplerV2) ─────────

sampler = SamplerV2(qrmi_sqd, options={"default_shots": 100_000})
# sampler.options.environment.job_tags = ["TUT_SQD"]
job = sampler.run([(isa_circuit,)])
print(f"Job submitted via QRMI: {job.job_id()} | Status: {job.status()}")
print("Waiting for results from hardware...")

_TRANSIENT = (
    "503",
    "Service Unavailable",
    "ConnectionError",
    "TimeoutError",
    "timed out",
    "Connection reset",
)
primitive_result = None
for attempt in range(120):
    try:
        primitive_result = job.result()
        break
    except Exception as e:
        if not any(tok in str(e) for tok in _TRANSIENT):
            raise
        print(f"  Transient error on attempt {attempt + 1}: {e}")
        time.sleep(10)

if primitive_result is None:
    raise RuntimeError("Job did not complete after retries")

pub_result = primitive_result[0]
bit_array = pub_result.data.meas
print(f"Total shots collected: {bit_array.num_shots}")

# ── Step 4: Post-process and return result in classical format ────────

def is_valid_bitstring(
    bitstring: str, norb: int, nelec: tuple[int, int]
) -> bool:
    n_a, n_b = nelec
    return (
        len(bitstring) == 2 * norb
        and bitstring[norb:].count("1") == n_a
        and bitstring[:norb].count("1") == n_b
    )

num_valid = sum(
    is_valid_bitstring(b, norb, nelec) for b in bit_array.get_bitstrings()
)
valid_fraction = num_valid / bit_array.num_shots
expected_random = (
    math.comb(norb, n_alpha) * math.comb(norb, n_beta) / (2 ** (2 * norb))
)
print(f"Fraction of valid configurations sampled: {valid_fraction:.5f}")
print(f"Expected fraction from uniform random:     {expected_random:.4e}")

# Configure SQD eigensolver
energy_tol = 1e-3
occupancies_tol = 1e-3
max_iterations = 5
num_batches = 3
samples_per_batch = 300
symmetrize_spin = True
carryover_threshold = 1e-4
max_cycle = 200

# Hartree-Fock initial occupancy guess
initial_occupancies = (
    np.array([1] * n_alpha + [0] * (norb - n_alpha)),
    np.array([1] * n_beta + [0] * (norb - n_beta)),
)

sci_solver = partial(solve_sci_batch, spin_sq=0.0, max_cycle=max_cycle)
result_history = []

def callback(results: list[SCIResult]):
    result_history.append(results)
    iteration = len(result_history)
    print(f"Iteration {iteration}")
    for i, res in enumerate(results):
        subspace_dim = np.prod(res.sci_state.amplitudes.shape)
        print(
            f"  Subsample {i}: Energy = {res.energy + nuclear_repulsion_energy:.8f} Ha | Subspace dim = {subspace_dim}"
        )

print("\nRunning SQD post-processing...")
rng = np.random.default_rng(42)
sqd_result = diagonalize_fermionic_hamiltonian(
    hcore,
    eri,
    bit_array,
    samples_per_batch=samples_per_batch,
    norb=norb,
    nelec=nelec,
    num_batches=num_batches,
    energy_tol=energy_tol,
    occupancies_tol=occupancies_tol,
    max_iterations=max_iterations,
    sci_solver=sci_solver,
    symmetrize_spin=symmetrize_spin,
    initial_occupancies=initial_occupancies,
    carryover_threshold=carryover_threshold,
    callback=callback,
    seed=rng,
)

final_energy = sqd_result.energy + nuclear_repulsion_energy
energy_error = final_energy - reference_energy

print("\n=== Energy Summary (N₂/cc-pVDZ active space) ===")
print(f"SCF energy:       {scf.e_tot:.8f} Ha")
print(f"Reference energy: {reference_energy:.8f} Ha")
print(f"Final SQD energy: {final_energy:.8f} Ha")
print(
    f"Energy error:     {energy_error:.8f} Ha ({abs(energy_error) * 627.5:.4f} kcal/mol)"
)

# ── Visualization ─────────────────────────────────────────────────────

x1 = range(len(result_history))
min_e = [
    min(res, key=lambda r: r.energy).energy + nuclear_repulsion_energy
    for res in result_history
]
e_diff = [abs(e - reference_energy) for e in min_e]
chem_accuracy = 0.001  # ~1 mHa / ~0.6 kcal/mol

y2 = np.sum(sqd_result.orbital_occupancies, axis=0)
x2 = range(len(y2))

fig, axs = plt.subplots(1, 2, figsize=(12, 5))

# Energies convergence plot
axs[0].plot(x1, e_diff, label="Energy error", marker="o")
axs[0].set_xticks(list(x1))
axs[0].set_xticklabels(list(x1))
axs[0].set_yscale("log")
axs[0].axhline(
    y=chem_accuracy,
    color="#BF5700",
    linestyle="--",
    label="Chemical accuracy (1 mHa)",
)
axs[0].set_title("SQD Energy Error vs Iteration")
axs[0].set_xlabel("Iteration")
axs[0].set_ylabel("Energy Error (Ha)")
axs[0].legend()

# Spatial orbital occupancy plot
axs[1].bar(x2, y2, width=0.8)
axs[1].set_xticks(list(x2)[::2])
axs[1].set_xticklabels(list(x2)[::2])
axs[1].set_title("Avg Occupancy per Spatial Orbital")
axs[1].set_xlabel("Spatial Orbital Index")
axs[1].set_ylabel("Avg Occupancy")

plt.tight_layout()
plt.show()
WARN: Unable to to identify input symmetry using original axes.
Different symmetry axes will be used.

converged SCF energy = -108.929838385609
N₂/cc-pVDZ active space: 26 orbitals (52 qubits), (5, 5) electrons
SCF energy:       -108.92983839 Ha
Reference energy: -109.22802922 Ha
E(CCSD) = -109.2177884185545  E_corr = -0.2879500329450047
CCSD energy:      -109.21778842 Ha
Using QRMI resource: ibm_kingston
LUCJ circuit: 52 qubits, depth 3
Transpiled gate counts: OrderedDict([('sx', 7041), ('rz', 6969), ('cz', 1858), ('measure', 52), ('x', 47), ('barrier', 1)])
Job submitted via QRMI: dai43o0mhr3c73e7a81g | Status: JobStatus.QUEUED
Waiting for results from hardware...
Total shots collected: 100000
Fraction of valid configurations sampled: 0.00319
Expected fraction from uniform random:     9.6079e-07

Running SQD post-processing...
Iteration 1
  Subsample 0: Energy = -109.09341960 Ha | Subspace dim = 208849
  Subsample 1: Energy = -109.11738590 Ha | Subspace dim = 204304
  Subsample 2: Energy = -109.09947704 Ha | Subspace dim = 212521
Iteration 2
  Subsample 0: Energy = -109.16015998 Ha | Subspace dim = 332929
  Subsample 1: Energy = -109.16823702 Ha | Subspace dim = 319225
  Subsample 2: Energy = -109.16189785 Ha | Subspace dim = 336400
Iteration 3
  Subsample 0: Energy = -109.17759299 Ha | Subspace dim = 471969
  Subsample 1: Energy = -109.17937442 Ha | Subspace dim = 512656
  Subsample 2: Energy = -109.17970409 Ha | Subspace dim = 504100
Iteration 4
  Subsample 0: Energy = -109.18410905 Ha | Subspace dim = 608400
  Subsample 1: Energy = -109.18265405 Ha | Subspace dim = 636804
  Subsample 2: Energy = -109.18608430 Ha | Subspace dim = 657721
Iteration 5
  Subsample 0: Energy = -109.18870837 Ha | Subspace dim = 846400
  Subsample 1: Energy = -109.18890818 Ha | Subspace dim = 848241
  Subsample 2: Energy = -109.19022232 Ha | Subspace dim = 804609

=== Energy Summary (N₂/cc-pVDZ active space) ===
SCF energy:       -108.92983839 Ha
Reference energy: -109.22802922 Ha
Final SQD energy: -109.19022232 Ha
Energy error:     0.03780690 Ha (23.7238 kcal/mol)
Próximos pasos
Si te pareció interesante este trabajo, quizás te interese el siguiente material:
-
Tutorial de diagonalización cuántica basada en muestreo — el flujo de trabajo completo de química SQD en IBM Quantum Platform, incluyendo moléculas y conjuntos de base más grandes
-
Diagonalización cuántica de Krylov basada en muestreo — un método relacionado que utiliza circuitos de evolución temporal para modelos de red fermiónicos
-
Documentación de
qiskit-addon-sqd— referencia completa de la API y tutoriales adicionales para la biblioteca de postprocesamiento de SQD -
Repositorio de GitHub de QRMI — código fuente, ejemplos adicionales de Backend (CUDA-Q, C, Lua)
-
Artículo de resumen de QRMI — descripción técnica de la arquitectura de QRMI y la integración con HPC
-
Guía de sesiones de IBM Quantum Compute Service — cómo se relacionan las sesiones con el ciclo de vida
acquire/releasede QRMI para los Backends de IBM