Optimización multiobjetivo aproximada cuántica
Estimación de uso: 10 minutos en un procesador Heron r2 (NOTA: Es solo una estimación. Tu tiempo de ejecución puede variar.)
Resultados de aprendizaje
Este tutorial resuelve un problema de optimización de carteras con restricción de cardinalidad: dada la restricción de mantener exactamente activos, se equilibran los objetivos de riesgo, rentabilidad y diversificación para encontrar el conjunto de carteras óptimas.
Después de completar este tutorial, podrás comprender:
-
Cómo expresar un problema de selección de carteras con tres objetivos en conflicto — bajo riesgo, alta rentabilidad y buena diversificación — como un problema de optimización cuántica.
-
Cómo un único circuito QAOA, barrido sobre un conjunto de pesos de objetivos, traza un frente de Pareto de carteras óptimas de compromiso.
-
Cómo un mezclador XY mantiene la búsqueda dentro del subespacio "elegir exactamente K activos", de modo que no se necesita ningún término de penalización y la factibilidad se garantiza mediante la posselección de las cadenas de bits medidas.
-
Cómo entrenar los ángulos del circuito con un simulador de estados de producto de matrices a una escala demasiado grande para optimizar de forma exacta, siguiendo a Kotil et al. (arXiv:2503.22797).
Requisitos previos
Se recomienda que estés familiarizado con:
-
El flujo de trabajo de los patrones de Qiskit (mapear, optimizar, ejecutar, posprocesar).
-
Los fundamentos de QAOA.
Antecedentes
Un gestor de carteras rara vez optimiza un solo número. Quiere que las rentabilidades sean altas, que el riesgo (la varianza de esas rentabilidades) sea bajo y que las posiciones estén repartidas entre sectores para que la cartera no esté sobreexpuesta a una sola parte del mercado. Estos objetivos se contraponen: los activos de mayor rentabilidad suelen ser los más volátiles, y concentrarse en un sector de moda perjudica la diversificación.
No existe una única cartera "mejor". En su lugar existe un frente de Pareto: el conjunto de carteras para las que no se puede mejorar un objetivo sin renunciar a otro. Nuestro objetivo es trazar ese frente para que quien toma las decisiones pueda elegir el compromiso que prefiera.
Planteamos el problema como la elección de exactamente activos de entre (cada activo está dentro o fuera: un qubit por activo). Tres hamiltonianos codifican los tres objetivos. Los combinamos con pesos que viven en un símplex (suman uno), y un Sampler QAOA devuelve buenas carteras para cada elección de pesos. Barrer los pesos barre la importancia relativa del riesgo frente a la rentabilidad y a la diversificación, y la unión de todas las carteras muestreadas traza el frente de Pareto.
Primero recorremos todo el flujo de trabajo con un pequeño ejemplo de ocho activos que podemos verificar por fuerza bruta y después ejecutamos el mismo método en una instancia de 40 activos dimensionada para hardware cuántico.
Este tutorial enseña el flujo de trabajo (mapeo, entrenamiento de ángulos, muestreo con restricciones y posprocesamiento de Pareto), en lugar de demostrar ventaja cuántica. A la escala de 40 activos usada aquí, el muestreo aleatorio uniforme rinde aproximadamente igual que el Sampler QAOA, y mostramos esa comparación de forma explícita.
Requisitos
Antes de comenzar este tutorial, asegúrate de tener instalado lo siguiente:
-
Qiskit SDK v2.0 o posterior, con compatibilidad con visualización
-
Qiskit Runtime v0.22 o posterior (
pip install qiskit-ibm-runtime) -
Qiskit Aer (
pip install qiskit-aer) -
El addon de Qiskit Optimization mapper (
pip install qiskit-addon-opt-mapper) y el pipeline de entrenamiento de QAOA, fijado a la etiquetav0.1.0:pip install "git+https://github.com/qiskit-community/qaoa_training_pipeline.git@v0.1.0" -
moocorepara los cálculos del frente de Pareto y del hipervolumen (pip install moocore)
Configuración
Importa las bibliotecas que se usan a lo largo del tutorial y fija una semilla aleatoria para garantizar la reproducibilidad.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "moocore": "moocore", "numpy": "numpy", "qaoa_training_pipeline": "qaoa-training-pipeline", "qiskit": "qiskit", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
import matplotlib.pyplot as plt
from math import comb
from moocore import hypervolume, filter_dominated, is_nondominated

from qiskit import QuantumCircuit
from qiskit.circuit import ParameterVector
from qiskit.circuit.library import qaoa_ansatz
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import SamplerV2 as AerSampler
from qiskit_addon_opt_mapper.problems import OptimizationProblem
from qaoa_training_pipeline.training import ScipyTrainer
from qaoa_training_pipeline.evaluation import (
    StatevectorEvaluator,
    MPSAerEvaluator,
)

np.random.seed(42)
sampler = AerSampler(seed=42)  # local simulator for the small-scale example
print("Setup complete.")
Setup complete.
Ejemplo a pequeña escala en simulador
Empezamos con ocho activos procedentes de seis sectores y seleccionamos exactamente de ellos. Con solo ocho activos hay únicamente carteras válidas, por lo que más adelante podemos comprobar el resultado cuántico con una búsqueda exhaustiva.
Paso 1: Mapear las entradas clásicas a un problema cuántico
Cada activo es un qubit; una cadena de bits como 10110010 es una cartera (los 1 son los activos que mantenemos). Necesitamos tres ingredientes: los datos de mercado, los tres hamiltonianos de los objetivos y un circuito que solo proponga carteras con exactamente activos.
# --- Small-scale universe: 8 assets across 6 sectors ---
tickers = ["AAPL", "XOM", "JPM", "JNJ", "KO", "AMT", "AMZN", "SLB"]
sectors = [
    "Tech",
    "Energy",
    "Finance",
    "Health",
    "Staples",
    "REIT",
    "Tech",
    "Energy",
]
n_assets = len(tickers)
K = 4  # choose exactly K assets
n_obj = 3  # risk, return, diversification

# Annualized expected returns
mu = np.array([0.28, 0.12, 0.22, 0.05, 0.08, 0.10, 0.32, 0.15])

# Annualized covariance matrix (the "risk" model)
sigma = np.array(
    [
        [0.070, 0.010, 0.020, 0.008, 0.005, 0.012, 0.045, 0.011],
        [0.010, 0.065, 0.015, 0.006, 0.004, 0.008, 0.009, 0.050],
        [0.020, 0.015, 0.055, 0.010, 0.007, 0.015, 0.018, 0.014],
        [0.008, 0.006, 0.010, 0.030, 0.012, 0.009, 0.007, 0.005],
        [0.005, 0.004, 0.007, 0.012, 0.025, 0.006, 0.004, 0.003],
        [0.012, 0.008, 0.015, 0.009, 0.006, 0.045, 0.011, 0.007],
        [0.045, 0.009, 0.018, 0.007, 0.004, 0.011, 0.085, 0.010],
        [0.011, 0.050, 0.014, 0.005, 0.003, 0.007, 0.010, 0.072],
    ]
)

# Diversification score: number of cross-sector pairs in the portfolio.
# D[i,j] = 0.5 when assets i and j are in different sectors, so x^T D x counts
# the cross-sector pairs. More cross-sector pairs = better diversified.
D = np.array(
    [
        [1.0 if sectors[i] != sectors[j] else 0.0 for j in range(n_assets)]
        for i in range(n_assets)
    ]
)
np.fill_diagonal(D, 0.0)
D = D / 2

print(f"{n_assets} assets, choose K={K}, {n_obj} objectives")
for t, s, m in zip(tickers, sectors, mu):
    print(f"  {t:5s} ({s:8s})  expected return {m:5.0%}")
8 assets, choose K=4, 3 objectives
  AAPL  (Tech    )  expected return   28%
  XOM   (Energy  )  expected return   12%
  JPM   (Finance )  expected return   22%
  JNJ   (Health  )  expected return    5%
  KO    (Staples )  expected return    8%
  AMT   (REIT    )  expected return   10%
  AMZN  (Tech    )  expected return   32%
  SLB   (Energy  )  expected return   15%
# Each objective becomes a Hamiltonian whose lowest-energy bitstrings are the
# best portfolios for that objective. The opt-mapper turns a plain
# min/max problem over binary variables into the equivalent Ising operator.
def build_risk_hamiltonian(sigma, n):
    """Minimize portfolio variance x^T sigma x  (quadratic -> ZZ terms)."""
    prob = OptimizationProblem("risk")
    prob.binary_var_list(n)
    prob.minimize(quadratic=sigma)
    op, _ = prob.to_ising()
    return op.simplify()

def build_return_hamiltonian(mu, n):
    """Maximize expected return mu . x  (linear -> Z terms)."""
    prob = OptimizationProblem("return")
    prob.binary_var_list(n)
    prob.maximize(linear=mu)
    op, _ = prob.to_ising()
    return op.simplify()

def build_diversity_hamiltonian(D, n):
    """Maximize cross-sector pairs x^T D x  (quadratic -> ZZ terms)."""
    prob = OptimizationProblem("diversity")
    prob.binary_var_list(n)
    prob.maximize(quadratic=D)
    op, _ = prob.to_ising()
    return op.simplify()

H_risk = build_risk_hamiltonian(sigma, n_assets)
H_return = build_return_hamiltonian(mu, n_assets)
H_diversity = build_diversity_hamiltonian(D, n_assets)
cost_ops = [H_risk, H_return, H_diversity]

for name, op in zip(["risk", "return", "diversity"], cost_ops):
    print(f"H_{name:10s}: {op.size} Pauli terms")
H_risk      : 36 Pauli terms
H_return    : 8 Pauli terms
H_diversity : 34 Pauli terms
Imponer "exactamente K activos" sin penalización. Un truco habitual es añadir un término de penalización que castigue las carteras de tamaño incorrecto, pero eso acopla cada qubit con todos los demás, lo que da lugar a circuitos mucho más profundos tras la transpilación. En su lugar usamos un mezclador XY, que solo mueve el estado QAOA entre cadenas de bits del mismo peso de Hamming. Si partimos de un estado que ya tiene activos seleccionados, toda cartera que explore el circuito también tiene exactamente activos. La restricción está integrada en la estructura del circuito en lugar de imponerse mediante un término de penalización.
Preparamos el estado inicial de forma económica: rotamos cada qubit para que esté "activo" con probabilidad . Restringido a los resultados con activos, esto reproduce el estado ideal de pesos iguales (de Dicke), por lo que simplemente conservamos las cadenas de bits medidas que tienen exactamente unos, un paso llamado posselección.
def xy_mixer(n):
    """Line XY mixer: couples neighboring qubits with XX+YY. Conserves the number
    of selected assets (Hamming weight), so cardinality is preserved automatically.
    Using a line (not a full ring) keeps the circuit shallow and hardware-friendly."""
    terms = [
        (pauli, [i, i + 1], 1) for i in range(n - 1) for pauli in ("XX", "YY")
    ]
    return SparsePauliOp.from_sparse_list(terms, n)

def product_init(n, k):
    """Cheap initial state: each qubit rotated so P(selected) = k/n. Zero two-qubit
    gates. Post-selecting its weight-k outcomes reproduces the ideal Dicke state."""
    qc = QuantumCircuit(n)
    theta = 2 * np.arcsin(np.sqrt(k / n))
    for q in range(n):
        qc.ry(theta, q)
    return qc

# Combine the three objectives with weights c (bound later, at sampling time).
p_layers = 1
c = ParameterVector("c", n_obj)
# Negate the objective so the sampling phase separator matches the sign the angles
# were trained under (the trainer maximizes the negated sum); binding below keeps +gamma.
combined_cost_op = sum(
    -c[k] * H_k for k, H_k in enumerate(cost_ops)
).simplify()

ansatz = qaoa_ansatz(
    combined_cost_op,
    reps=p_layers,
    initial_state=product_init(n_assets, K),
    mixer_operator=xy_mixer(n_assets),
)
ansatz.measure_all()

betas = [p for p in ansatz.parameters if p.name.startswith("β")]
gammas = [p for p in ansatz.parameters if p.name.startswith("γ")]
print(f"Qubits: {ansatz.num_qubits} | QAOA layers: {p_layers}")
print(
    f"Tunable angles: {len(betas)} beta + {len(gammas)} gamma, plus {n_obj} objective weights"
)
Qubits: 8 | QAOA layers: 1
Tunable angles: 1 beta + 1 gamma, plus 3 objective weights
Paso 2: Optimizar el problema para su ejecución en hardware cuántico
Antes de ejecutar, el circuito abstracto se transpila a puertas nativas del hardware. A esta pequeña escala solo inspeccionamos el coste: ¿qué profundidad tiene el circuito y cuántas puertas de dos qubits utiliza? (Las puertas de dos qubits son la principal fuente de ruido en los dispositivos reales.)
# Bind dummy angle values so we can transpile and measure the circuit's size.
dummy = {p: 0.1 for p in ansatz.parameters}
test_pm = generate_preset_pass_manager(optimization_level=1)
test_qc = test_pm.run(ansatz.assign_parameters(dummy))

print(f"Circuit depth          : {test_qc.depth()}")
print(
    f"Two-qubit gate depth   : {test_qc.depth(lambda x: len(x.qubits) > 1)}"
)
print(f"Two-qubit gate count   : {test_qc.num_nonlocal_gates()}")
Circuit depth          : 25
Two-qubit gate depth   : 23
Two-qubit gate count   : 42
Paso 3: Ejecutar con las primitivas de Qiskit
Dos etapas. Primero entrenamos los ángulos de QAOA una vez, con pesos de objetivos iguales, usando un simulador exacto de vector de estado para encontrar buenos valores de . Después barremos muchos vectores de pesos por el símplex y muestreamos el circuito en cada uno, reuniendo carteras candidatas. Como entre barridos solo cambian los pesos de los objetivos (no los ángulos entrenados), todos los vectores de pesos se envían en un único trabajo por lotes.
# Train the angles with equal objective weights.
# The trainer maximizes energy, so we negate the (to-be-minimized) objective sum.
training_op = sum(-1.0 / n_obj * H_k for H_k in cost_ops).simplify()

# Linear-ramp initialization (Sack and Serbyn, arXiv:2101.05742)
dt = 0.75
grid = np.arange(1, p_layers + 1) - 0.5
init_params = np.concatenate((1 - grid * dt / p_layers, grid * dt / p_layers))

trainer = ScipyTrainer(
    StatevectorEvaluator(), minimize_args={"options": {"maxiter": 300}}
)
print("Training QAOA angles (exact statevector)...")
result_train = trainer.train(
    cost_op=training_op,
    mixer=xy_mixer(n_assets),
    initial_state=product_init(n_assets, K),
    params0=init_params,
)
opt = result_train["optimized_params"]
opt_betas, opt_gammas = opt[:p_layers], opt[p_layers:]
print(f"Trained beta : {opt_betas}")
print(f"Trained gamma: {opt_gammas}")
Training QAOA angles (exact statevector)...
Trained beta : [3.329186967386619]
Trained gamma: [3.4449804324291033]
def random_uniform_simplex(n_samples, n_obj=3):
    """n_samples weight vectors spread uniformly over the (n_obj-1)-simplex."""
    s = np.zeros((n_samples, n_obj + 1))
    s[:, 1:-1] = np.random.rand(n_samples, n_obj - 1)
    s[:, -1] = 1
    s = np.sort(s, axis=1)
    return np.diff(s, axis=1)

# Bind the trained angles, leaving the objective weights c free for the sweep.
param_map = {betas[i]: opt_betas[i] for i in range(p_layers)}
param_map.update({gammas[i]: opt_gammas[i] for i in range(p_layers)})
ansatz_bound = ansatz.assign_parameters(param_map)

n_samples, shots = 200, 500
c_vecs = random_uniform_simplex(n_samples, n_obj)

print(f"Sampling {n_samples} weight vectors x {shots} shots...")
result = sampler.run([(ansatz_bound, c_vecs)], shots=shots).result()

# Collect every distinct bitstring seen across all weight vectors.
all_bitstrings = set()
for s in range(n_samples):
    for bs in result[0].data.meas.get_counts(s):
        # get_counts is little-endian; reverse so bit i = asset i
        all_bitstrings.add(bs.replace(" ", "")[::-1])
print(f"Distinct portfolios sampled: {len(all_bitstrings)}")
Sampling 200 weight vectors x 500 shots...
Distinct portfolios sampled: 256
Paso 4: Posprocesar y devolver el resultado en el formato clásico deseado
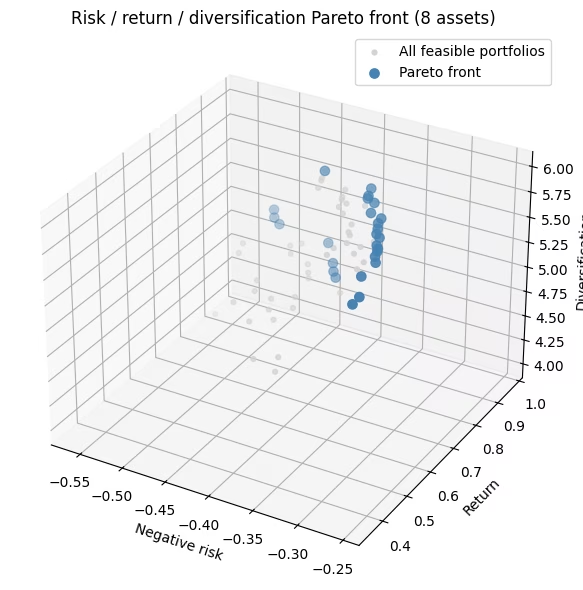
Conservamos solo las carteras factibles (exactamente activos según el paso de posselección), puntuamos cada una en los tres objetivos y extraemos el frente de Pareto: las carteras que no son superadas en todos los objetivos a la vez. El hipervolumen es un único número que resume cuánto espacio de objetivos domina el frente, y cuanto mayor, mejor.
Con 100 000 shots sobre solo 256 cadenas de bits, esta ejecución ve las 70 carteras válidas, de modo que a este tamaño es en la práctica una comprobación por fuerza bruta de que el pipeline está bien conectado, y no una prueba de que QAOA haya encontrado el frente.
def evaluate_portfolio(bitstring, sigma, mu, D):
    """Score one portfolio on all three objectives (all framed as 'bigger is better')."""
    x = np.array([int(b) for b in bitstring])
    # negative risk, return, diversification (cross-sector pairs)
    return np.array([-(x @ sigma @ x), x @ mu, x @ D @ x])

# Post-select feasible portfolios, then score them.
feasible = [bs for bs in all_bitstrings if bs.count("1") == K]
fis = np.array([evaluate_portfolio(bs, sigma, mu, D) for bs in feasible])

pareto_front = filter_dominated(fis, maximise=True)
ref_point = fis.min(axis=0)
qmoo_hv = hypervolume(fis, ref=ref_point, maximise=True)

print(
    f"Feasible portfolios found : {len(feasible)} of {comb(n_assets, K)} possible"
)
print(f"Pareto-front portfolios   : {len(pareto_front)}")
print(f"Hypervolume               : {qmoo_hv:.4f}")
Feasible portfolios found : 70 of 70 possible
Pareto-front portfolios   : 26
Hypervolume               : 0.2487
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection="3d")
ax.scatter(
    fis[:, 0],
    fis[:, 1],
    fis[:, 2],
    c="lightgray",
    s=12,
    label="All feasible portfolios",
)
ax.scatter(
    pareto_front[:, 0],
    pareto_front[:, 1],
    pareto_front[:, 2],
    c="steelblue",
    s=45,
    label="Pareto front",
)
ax.set_xlabel("Negative risk")
ax.set_ylabel("Return")
ax.set_zlabel("Diversification")
ax.set_title("Risk / return / diversification Pareto front (8 assets)")
ax.legend()
plt.tight_layout()
plt.show()
Ejemplo a gran escala en hardware
Ahora el mismo flujo de trabajo con 40 activos (8 sectores × 5), eligiendo . Cuarenta qubits son demasiados para simularlos de forma exacta (un vector de estado de amplitudes), por lo que los ángulos no se pueden optimizar como con ocho activos, y un circuito denso sería demasiado profundo para el hardware actual. Las M carteras válidas siguen siendo lo bastante pocas como para enumerarlas de forma clásica, lo que usamos al final como referencia exacta. Cambian varias cosas, y nada más del método cambia:
-
Entrenar los ángulos con un simulador de estados de producto de matrices (MPS), no con vector de estado exacto. Siguiendo la referencia (Kotil et al.), fijamos los pesos de los objetivos a valores iguales, optimizamos un único β, γ en el simulador MPS y los reutilizamos para cada vector de pesos del barrido. (Entrenamos con el tamaño con el que ejecutamos, sin transferencia de ángulos de pequeña a gran escala.)
-
Hacer dispersa el modelo de riesgo para ajustarlo al hardware. Una covarianza completa acopla los 780 pares de activos. Conservamos solo los acoplamientos más fuertes y más baratos de enrutar mediante un truncamiento QAP sensible a la importancia, y acoplamos cada sector en un anillo ligero para el término de diversidad. Esto mantiene los objetivos significativos y limita el circuito a un tamaño adecuado para el hardware.
-
Mantener el circuito poco profundo y puntuar con honestidad. El enrutamiento es estocástico, así que transpilamos con varias semillas y conservamos el menos profundo (y no se gasta tiempo cuántico). Las carteras siempre se puntúan con los objetivos completos y verdaderos. La dispersión solo da forma al circuito, no a cómo se juzgan las carteras.
Conservar únicamente los mayores acoplamientos de cada activo por magnitud puede dar un circuito disperso pero aun así difícil de enrutar. El truncamiento QAP, en cambio, conserva los acoplamientos que son a la vez grandes y físicamente cercanos en el chip, de modo que el mismo presupuesto de puertas permite un circuito menos profundo y más adecuado para el hardware.
Paso 1: Mapear las entradas (dispersas para el hardware)
import csv
import urllib.request

# Download the committed market-data snapshot from the repo.
# --- 40-asset universe: 8 GICS sectors x 5 tickers (real market data) ---
# Load the committed market-data snapshot (real annualized returns and covariance).
# Values are stored at the precision used to train the shipped QAOA angles
# (mu: 3 dp, sigma: 4 dp), so the pre-trained parameters in instances/ stay exactly valid.

url = "https://raw.githubusercontent.com/Qiskit/documentation/main/datasets/tutorials/qmoo/market_data.csv"
urllib.request.urlretrieve(url, "market_data.csv")

with open("market_data.csv", newline="") as _f:
    _rows = list(csv.reader(_f))

# Covariance column order
_tickers_csv = _rows[0][2:]
# Asset tickers
tickers_40 = [r[0] for r in _rows[1:]]
# Annualized expected returns
mu_40 = np.array([float(r[1]) for r in _rows[1:]])
# Covariance (risk model)
sigma_40 = np.array([[float(v) for v in r[2:]] for r in _rows[1:]])

sectors_40 = [
    "Tech",
    "Tech",
    "Tech",
    "Tech",
    "Tech",
    "Energy",
    "Energy",
    "Energy",
    "Energy",
    "Energy",
    "Finance",
    "Finance",
    "Finance",
    "Finance",
    "Finance",
    "Health",
    "Health",
    "Health",
    "Health",
    "Health",
    "Staples",
    "Staples",
    "Staples",
    "Staples",
    "Staples",
    "Industrials",
    "Industrials",
    "Industrials",
    "Industrials",
    "Industrials",
    "Utilities",
    "Utilities",
    "Utilities",
    "Utilities",
    "Utilities",
    "REIT",
    "REIT",
    "REIT",
    "REIT",
    "REIT",
]
n_assets_40 = len(tickers_40)
K_40 = 6  # choose exactly K assets

sector_names_40 = list(dict.fromkeys(sectors_40))
sect_idx_40 = np.array([sector_names_40.index(s) for s in sectors_40])
# True cross-sector diversification matrix (used for scoring)
D_40 = np.array(
    [
        [
            0.5 if sectors_40[i] != sectors_40[j] else 0.0
            for j in range(n_assets_40)
        ]
        for i in range(n_assets_40)
    ]
)
np.fill_diagonal(D_40, 0.0)
print(
    f"{n_assets_40} assets, {len(sector_names_40)} sectors, choose K={K_40}"
)
40 assets, 8 sectors, choose K=6
# Sparsify the covariance so the risk circuit fits on hardware. A small diagonal
# shift (added after truncation) keeps the risk model positive semidefinite; at fixed
# K it adds the same constant to every portfolio, so it never changes the ranking.
# Importance-aware QAP truncation (Kotil et al. style): place the qubits on a line
# and use a Quadratic Assignment Problem to choose the layout that keeps the
# strongest covariance couplings within routing distance k of the swap network,
# then drop the rest. Unlike a fixed top-k cap, it keeps couplings that are both
# large AND cheap to route.
from scipy.optimize import quadratic_assignment as qap
from qiskit.transpiler.passes.routing.commuting_2q_gate_routing import (
    SwapStrategy,
)

# Truncation level: larger k keeps more couplings (deeper circuit)
k_truncate = 2
_dist = np.array(
    SwapStrategy.from_line(list(range(n_assets_40))).distance_matrix
)

def qap_truncate(Q, k):
    w = np.abs(Q.copy())
    np.fill_diagonal(w, 0.0)
    mask = (_dist <= k).astype(float)
    # Seed the QAP solver explicitly (by default it draws from NumPy's global
    # RNG, which SciPy is deprecating) so the truncation is reproducible.
    perm = qap(-w, mask, options={"rng": np.random.default_rng(42)}).col_ind
    keep = mask[np.ix_(perm, perm)]
    Qt = Q * keep
    np.fill_diagonal(Qt, np.diag(Q))
    return Qt

sigma_sparse = qap_truncate(sigma_40, k_truncate)
print(
    f"QAP truncation (k={k_truncate}): risk edges kept = "
    f"{(np.count_nonzero(sigma_sparse) - n_assets_40) // 2}"
)
ridge = max(0.0, -np.linalg.eigvalsh(sigma_sparse)[0]) + 1e-6
sigma_sparse = sigma_sparse + ridge * np.eye(n_assets_40)

# Diversity: couple each sector's assets in a ring (sparse stand-in for the
# same-sector pair count). Scoring still uses the true cross-sector matrix D_40.
def build_same_sector_hamiltonian(D_same, n):
    prob = OptimizationProblem("diversity_sparse")
    prob.binary_var_list(n)
    prob.minimize(quadratic=D_same)
    op, _ = prob.to_ising()
    return op.simplify()

D_ring = np.zeros((n_assets_40, n_assets_40))
for s in set(sect_idx_40):
    members = np.where(sect_idx_40 == s)[0]
    for k in range(len(members)):
        i, j = members[k], members[(k + 1) % len(members)]
        D_ring[i, j] = D_ring[j, i] = 0.5

H_risk_40 = build_risk_hamiltonian(sigma_sparse, n_assets_40)
H_return_40 = build_return_hamiltonian(mu_40, n_assets_40)
H_diversity_40 = build_same_sector_hamiltonian(D_ring, n_assets_40)
cost_ops_40 = [H_risk_40, H_return_40, H_diversity_40]
n_zz = sum(
    1 for p in sum(cost_ops_40).simplify().paulis if str(p).count("Z") == 2
)
print(
    f"Cost-layer interactions: {n_zz} (dense would be {n_assets_40*(n_assets_40-1)//2})"
)
QAP truncation (k=2): risk edges kept = 78
Cost-layer interactions: 102 (dense would be 780)
Pasos 2-3: entrenar los ángulos y luego construir y enviar el trabajo al hardware
Cuarenta qubits son demasiados para optimizar los ángulos de forma exacta, así que entrenamos un único en un simulador de estados de producto de matrices con pesos de objetivos iguales y lo reutilizamos en todo el barrido. La celda siguiente carga valores preentrenados desde un archivo. El ángulo entrenado de la capa de coste es pequeño (), por lo que el circuito aplica un sesgo suave en lugar de una proyección marcada.
import json
from qiskit_ibm_runtime import QiskitRuntimeService, SamplerV2

# Pre-trained angles loaded from a file (training is slow; QDC pattern).
# Set load_params_file = False to retrain in-notebook.
load_params_file = True
params_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/datasets/tutorials/qmoo/qaoa_params.json"
params_path = "qaoa_params.json"
if load_params_file:
    urllib.request.urlretrieve(params_url, params_path)
    qaoa_params = json.load(open(params_path))
    p_layers_hw = qaoa_params["p_layers"]
    opt_betas_40, opt_gammas_40 = qaoa_params["betas"], qaoa_params["gammas"]
else:
    # Same workflow as the small-scale example: qaoa_training_pipeline's MPSAerEvaluator
    # evaluates the QAOA energy on Aer's MPS simulator and supports the XY mixer.
    # As in the small-scale example the trainer maximizes energy, so we negate the
    # (to-be-minimized) objective sum; the 1/n_obj scaling matches the equal-weight
    # point of the sweep, so the trained gamma transfers directly to the weighted circuits.
    p_layers_hw = 1
    training_op_40 = sum(-1.0 / n_obj * H_k for H_k in cost_ops_40).simplify()

    dt = 0.75
    grid = np.arange(1, p_layers_hw + 1) - 0.5
    init_params_40 = np.concatenate(
        (1 - grid * dt / p_layers_hw, grid * dt / p_layers_hw)
    )

    trainer_40 = ScipyTrainer(
        MPSAerEvaluator({"matrix_product_state_max_bond_dimension": 24}),
        minimize_args={"options": {"maxiter": 80}},
    )
    print("Training QAOA angles (MPS simulator)...")
    result_train_40 = trainer_40.train(
        cost_op=training_op_40,
        mixer=xy_mixer(n_assets_40),
        initial_state=product_init(n_assets_40, K_40),
        params0=init_params_40,
    )
    opt_40 = result_train_40["optimized_params"]
    opt_betas_40, opt_gammas_40 = (
        list(opt_40[:p_layers_hw]),
        list(opt_40[p_layers_hw:]),
    )
    import os

    os.makedirs(os.path.dirname(params_path) or ".", exist_ok=True)
    json.dump(
        {
            "p_layers": p_layers_hw,
            "betas": opt_betas_40,
            "gammas": opt_gammas_40,
        },
        open(params_path, "w"),
        indent=2,
    )
    print(
        f"Trained angles saved to {params_path} (set load_params_file=True to reuse)."
    )

c40 = ParameterVector("c", n_obj)
# Negated to match the trained angles' sign, as in the small-scale cell; binding keeps +gamma.
combined_cost_op_40 = sum(
    -c40[k] * H_k for k, H_k in enumerate(cost_ops_40)
).simplify()
qc_40 = qaoa_ansatz(
    combined_cost_op_40,
    reps=p_layers_hw,
    initial_state=product_init(n_assets_40, K_40),
    mixer_operator=xy_mixer(n_assets_40),
)
qc_40.measure_all()
b40 = [p for p in qc_40.parameters if p.name.startswith("β")]
g40 = [p for p in qc_40.parameters if p.name.startswith("γ")]
pmap = {b40[i]: opt_betas_40[i] for i in range(p_layers_hw)}
pmap.update({g40[i]: opt_gammas_40[i] for i in range(p_layers_hw)})
ansatz_qc_40 = qc_40.assign_parameters(pmap)

service = QiskitRuntimeService()

# only use Heron devices
backend = service.least_busy(min_num_qubits=156)

# SABRE routing is stochastic: different seeds give different depths. Transpilation
# is classical (it costs no QPU time), so we transpile many seeds and keep only the
# shallowest circuit -- a free reduction in two-qubit depth before anything is sent
# to hardware. Only this single best circuit is ever executed.
n_seeds = 24
best = None
depths = []
for seed in range(n_seeds):
    pm = generate_preset_pass_manager(
        optimization_level=3, backend=backend, seed_transpiler=seed
    )
    qc = pm.run(ansatz_qc_40)
    d2 = qc.depth(lambda x: len(x.qubits) > 1)
    depths.append(d2)
    if best is None or d2 < best[0]:
        best = (d2, seed, qc)
isa_qc = best[2]
sd = sorted(depths)
print(
    f"Backend: {backend.name} | {n_seeds} seeds | two-qubit depth "
    f"best/median/worst = {sd[0]}/{sd[len(sd)//2]}/{sd[-1]} (best seed {best[1]})"
)
print(
    f"Selected circuit -> two-qubit gates: {isa_qc.num_nonlocal_gates()}, "
    f"two-qubit depth: {isa_qc.depth(lambda x: len(x.qubits) > 1)}"
)
Backend: ibm_kingston | 24 seeds | two-qubit depth best/median/worst = 220/261/300 (best seed 22)
Selected circuit -> two-qubit gates: 787, two-qubit depth: 220
# Submit one batched job (job mode; a single batch needs no Session).
# Extra shots: noise lowers the post-selection yield
n_samples_40, shots_40 = 24, 1500
c_vecs_40 = random_uniform_simplex(n_samples_40, n_obj)
sampler_hw = SamplerV2(mode=backend)
# Tag hardware jobs for tracking
sampler_hw.options.environment.job_tags = ["TUT_QAMOO"]
# Seconds; guard against runaway jobs
sampler_hw.options.max_execution_time = 600

# The QAOA angles are already bound; only the objective weights c remain free.
# Assign each weight vector to get one concrete circuit per point on the simplex.
bound_circuits_40 = [
    isa_qc.assign_parameters({c40[k]: cv[k] for k in range(n_obj)})
    for cv in c_vecs_40
]
job_hw = sampler_hw.run([(qc,) for qc in bound_circuits_40], shots=shots_40)
print(
    f"Submitted to {backend.name}: job id {job_hw.job_id()} ({len(bound_circuits_40)} circuits)"
)
Submitted to ibm_kingston: job id darcaalvr3kc73einokg (24 circuits)
Paso 4: Posprocesar hasta obtener el frente de Pareto y leer las carteras óptimas
result_hw = job_hw.result()

# Post-select feasible portfolios (exactly K assets), score on the TRUE objectives.
feasible_40 = set()
for s in range(n_samples_40):
    for bs in result_hw[s].data.meas.get_counts():
        # get_counts is little-endian; reverse so bit i = asset i
        bs = bs.replace(" ", "")[::-1]
        if bs.count("1") == K_40:
            feasible_40.add(bs)

def score_40(P):
    """Score portfolios given as an (n, K) array of asset indices.

    Returns an (n, 3) array of [negative risk, return, diversification], all framed
    as 'bigger is better'. This is the single definition of the true objectives,
    used for the hardware samples, the exact enumeration, and the random baseline.
    Looping over the K x K index pairs keeps memory O(n) even for millions of rows.
    """
    risk = np.zeros(len(P))
    div = np.zeros(len(P))
    for a in range(P.shape[1]):
        for b in range(P.shape[1]):
            risk += sigma_40[P[:, a], P[:, b]]
            div += D_40[P[:, a], P[:, b]]
    return np.column_stack([-risk, mu_40[P].sum(1), div])

def evaluate_40(bs):
    """Score one bitstring (bit i = asset i) with score_40."""
    idx = np.flatnonzero([b == "1" for b in bs])
    return score_40(idx[None, :])[0]

fis_40 = np.array([evaluate_40(bs) for bs in feasible_40])
pareto_40 = filter_dominated(fis_40, maximise=True)
print(f"Feasible portfolios collected : {len(feasible_40)}")
print(f"Pareto-front portfolios       : {len(pareto_40)}")
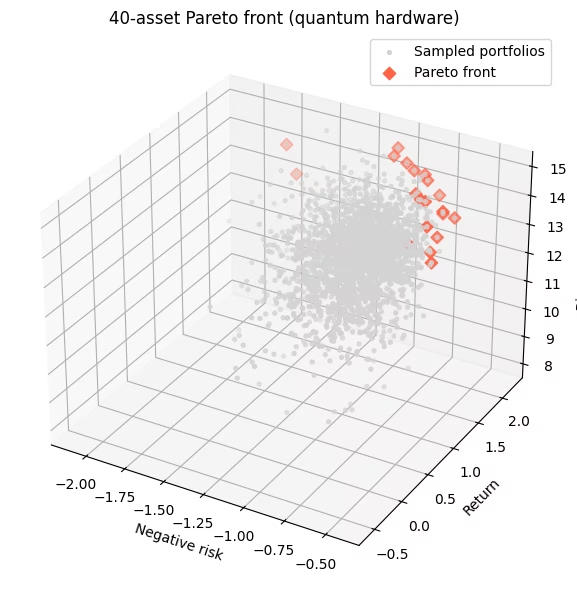
Feasible portfolios collected : 2359
Pareto-front portfolios       : 20
# --- Honest benchmark: QAOA and random vs the EXACT Pareto front ---
# 40 choose 6 = 3,838,380 feasible portfolios -- few enough to enumerate exactly, score
# every one on the TRUE objectives, and get the exact Pareto front. That front is an
# absolute ceiling, and its feasible nadir is a FIXED hypervolume reference point, so the
# numbers are comparable across runs instead of depending on what happened to be sampled.
import itertools

# Stream the combinations straight into an (n, K) index array, without first
# building millions of Python tuples.
combos = np.fromiter(
    itertools.chain.from_iterable(
        itertools.combinations(range(n_assets_40), K_40)
    ),
    dtype=np.int16,
).reshape(-1, K_40)
fis_exact = score_40(combos)
front_exact = filter_dominated(fis_exact, maximise=True)

# Fixed reference = worst value of each objective over ALL feasible portfolios (the nadir).
ref_fixed = fis_exact.min(axis=0)
# The hypervolume of a point set equals the hypervolume of its front.
hv_ceiling = hypervolume(front_exact, ref=ref_fixed, maximise=True)
hv_qaoa = hypervolume(fis_40, ref=ref_fixed, maximise=True)

def random_feasible_hv(n_draw, seed):
    """Hypervolume of n_draw uniformly-random feasible portfolios, same fixed reference."""
    rng = np.random.default_rng(seed)
    picks = set()
    while len(picks) < n_draw:
        picks.add(tuple(sorted(rng.choice(n_assets_40, K_40, replace=False))))
    P = np.array(list(picks))
    return hypervolume(score_40(P), ref=ref_fixed, maximise=True)

hv_rand = np.array(
    [random_feasible_hv(len(feasible_40), seed) for seed in range(20)]
)

print(f"Exact Pareto front            : {len(front_exact)} portfolios")
print(f"Hypervolume ceiling (optimum) : {hv_ceiling:.3f}")
print(
    f"QAOA (hardware)               : {100 * hv_qaoa / hv_ceiling:5.1f}% of optimum"
)
print(
    f"Random ({len(feasible_40)} draws, 20 seeds) : "
    f"{100 * hv_rand.mean() / hv_ceiling:5.1f}% +/- {100 * hv_rand.std() / hv_ceiling:.1f}% of optimum"
)
Exact Pareto front            : 61 portfolios
Hypervolume ceiling (optimum) : 64.211
QAOA (hardware)               :  85.5% of optimum
Random (2359 draws, 20 seeds) :  84.4% +/- 1.3% of optimum
Con este tamaño de problema, QAOA rinde aproximadamente igual que el muestreo aleatorio uniforme. Ambos recuperan una gran fracción del hipervolumen del óptimo exacto, y ninguno va claramente por delante. Este resultado es el esperado para una única capa QAOA poco profunda con un operador de coste muy truncado en hardware con ruido; el valor de este ejemplo es el flujo de trabajo multiobjetivo de extremo a extremo (mapeo, entrenamiento de ángulos, muestreo con restricciones y posprocesamiento de Pareto), no una aceleración cuántica. Reducir la distancia al óptimo requeriría circuitos más profundos (más capas QAOA), un truncamiento más suave o hardware con menos ruido.
# The best trade-offs found by the sampler: no other sampled portfolio beats these
# on every objective. They approximate the exact front computed above; a
# decision-maker picks the trade-off they prefer.
bs_list = list(feasible_40)
# Boolean mask over fis_40; keep_weakly=True also keeps portfolios whose
# objective values tie with a front point (what the strict filter would drop).
mask = is_nondominated(fis_40, maximise=True, keep_weakly=True)
front_bs = [b for b, m in zip(bs_list, mask) if m]
front_f = fis_40[mask]
order = np.argsort(-front_f[:, 1])  # show a span sorted by return
print(
    f"{mask.sum()} non-dominated sampled portfolios. A representative span:\n"
)
print(
    f"{'tickers held':40s} {'risk':>7s} {'return':>7s} {'cross-sector':>12s}"
)
for idx in order[:: max(1, len(order) // 12)]:
    held = [tickers_40[i] for i, b in enumerate(front_bs[idx]) if b == "1"]
    print(
        f"{', '.join(held):40s} {-front_f[idx,0]:7.3f} {front_f[idx,1]:7.2f} {int(front_f[idx,2]):12d}"
    )

fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection="3d")
ax.scatter(
    fis_40[:, 0],
    fis_40[:, 1],
    fis_40[:, 2],
    c="lightgray",
    s=8,
    label="Sampled portfolios",
)
ax.scatter(
    pareto_40[:, 0],
    pareto_40[:, 1],
    pareto_40[:, 2],
    c="tomato",
    marker="D",
    s=40,
    label="Pareto front",
)
ax.set_xlabel("Negative risk")
ax.set_ylabel("Return")
ax.set_zlabel("Diversification")
ax.set_title("40-asset Pareto front (quantum hardware)")
ax.legend()
plt.tight_layout()
plt.show()
20 non-dominated sampled portfolios. A representative span:

tickers held                                risk  return cross-sector
AAPL, NVDA, XOM, GS, BLK, CAT              1.715    2.22           13
NVDA, GS, MS, PFE, CAT, PLD                1.772    2.20           14
NVDA, MS, PFE, WMT, CAT, DUK               1.040    2.14           15
NVDA, CVX, GS, JNJ, KO, WMT                0.737    2.01           14
NVDA, COP, GS, JNJ, WMT, EQIX              1.014    1.98           15
NVDA, ABT, WMT, CAT, AEP, EQIX             0.913    1.92           15
NVDA, CVX, WMT, RTX, D, EQIX               0.835    1.82           15
NVDA, XOM, GS, JNJ, DUK, EQIX              0.763    1.80           15
AAPL, NVDA, JNJ, KO, RTX, SO               0.621    1.71           14
NVDA, CVX, BLK, JNJ, RTX, AEP              0.719    1.71           15
NVDA, JNJ, KO, COST, RTX, AEP              0.545    1.69           14
NVDA, CVX, ABT, WMT, HON, AEP              0.702    1.43           15
AAPL, GS, JNJ, PEP, AEP, EQIX              0.645    1.34           15
MSFT, XOM, BLK, JNJ, CAT, SO               0.617    1.34           15
MSFT, KO, WMT, RTX, SO, SPG                0.526    1.29           14
MSFT, XOM, BLK, JNJ, WMT, DUK              0.483    1.25           15
MSFT, CVX, JNJ, RTX, DUK, D                0.482    1.02           14
MSFT, XOM, JNJ, KO, HON, EQIX              0.479    0.93           15
MSFT, JNJ, PG, KO, RTX, DUK                0.423    0.86           14
MSFT, XOM, JNJ, PEP, DUK, AMT              0.476    0.57           15
Próximos pasos
Si este tutorial te ha parecido interesante, considera lo siguiente:
-
Sustituye los datos de mercado descargados (
market_data.csv) por tus propias estimaciones de rentabilidades y covarianza a partir de un historial de precios real. -
Aumenta el número de capas QAOA, o entrena con 12–16 activos y transfiere esos ángulos, para acercar más el frente en hardware al óptimo.
-
Lee a Kotil et al., Quantum Approximate Multi-Objective Optimization (Nature Computational Science, 2025), el estudio de max-cut que este tutorial adapta a las carteras.
Referencias
-
Kotil et al., "Quantum Approximate Multi-Objective Optimization," Nature Computational Science (2025). arXiv:2503.22797
-
S. H. Sack and M. Serbyn, "Quantum annealing initialization of the quantum approximate optimization algorithm," Quantum 5, 491 (2021). arXiv:2101.05742