Ruido y errores
Esta lección presentará el ruido y los errores cuánticos, incluyendo muchas de sus fuentes, y estableciendo analogías con los errores clásicos. Comprender los tipos de errores que pueden ocurrir, así como la capacidad de modelar el ruido mediante canales cuánticos, será fundamental para entender las lecciones futuras. De hecho, la mayoría de los métodos de gestión de errores requieren que sepamos algo sobre el tipo de ruido o errores que buscamos reducir o corregir.
Este video ofrece una visión general del ruido y los errores, y destaca algunos resultados computacionales. El texto a continuación añade más detalle y explora algunos tipos de errores usando Qiskit.
Causas
Ruido y errores clásicos
Para comprender los errores y el ruido cuánticos, comencemos con el análogo clásico. Los errores ocurren en las computadoras clásicas por diversas razones, incluyendo múltiples mecanismos de acumulación espuria de carga, alteraciones de evento único y una degradación lenta del material. Algunos de estos mecanismos (no todos) tienen análogos en la computación cuántica y serán fundamentales para comprender los errores y el ruido cuánticos. Repasamos brevemente algunos de ellos y luego pasamos a los análogos cuánticos.
Ruido térmico:
A medida que los componentes de una computadora se calientan, el movimiento térmico de los átomos y los portadores de carga cambia la resistividad del material (normalmente aumentándola). Esto significa que la resistencia en el circuito puede variar. Aunque es poco frecuente, esto puede provocar una transición lógica espuria en un transistor. Aunque las variaciones menores son inevitables, un enfriamiento adecuado de los componentes es clave para evitar estos efectos.
Daño y degradación térmica:
El calentamiento y enfriamiento repetidos de los materiales puede provocar una migración muy lenta de los elementos conductores (metales). En el mejor de los casos, esto cambia la resistencia o la capacitancia (o ambas) de los elementos del circuito y produce una temporización imprecisa en el funcionamiento del circuito. En el peor de los casos, provoca un cortocircuito o un fallo grave. De nuevo, un control adecuado de la temperatura es clave para prevenir este tipo de degradación.
Efectos inducidos por radiación (alteraciones de evento único, SEU):
A veces, las partículas de alta energía pueden ionizar átomos dentro de un procesador y producir una carga espuria. Si esto ocurre en el lugar y el momento equivocados, puede provocar errores lógicos. La fuente de estas partículas de alta energía (incluyendo radiación electromagnética y neutrones) suele ser interacciones de alta energía en la atmósfera superior. Por ello, estas alteraciones son más frecuentes en entornos de gran altitud, incluido el espacio. Se abordan mediante códigos de corrección de errores y diseños resistentes a la radiación.
Interferencia electromagnética:
Los errores también pueden ser causados por campos electromagnéticos (EM) externos provenientes de líneas eléctricas de conmutación, transmisores de radio u otros componentes del sistema. Esto es diferente de la radiación de alta energía del fenómeno anterior. Aquí, campos EM parásitos dependientes del tiempo inducen corriente y voltaje en los componentes informáticos (a diferencia de ionizar un átomo particular en un solo evento). Dado que la dependencia temporal de los campos es un factor determinante en los voltajes inducidos, este tipo de interferencia es especialmente importante en sistemas de alta frecuencia. Estos errores pueden combatirse mediante blindaje y puesta a tierra, entre otras cosas.
Diafonía entre interconexiones:
El acoplamiento capacitivo o inductivo entre conductores adyacentes, especialmente en circuitos integrados a escala nanométrica, puede producir señales espurias. Esto está relacionado con la interferencia electromagnética, pero es diferente porque la fuente del campo perturbador es otro componente dentro del circuito de la computadora. Piensa en dos cables muy cercanos entre sí. Si el cable A experimenta una transición repentina (cambio de voltaje), puede inducir corrientes en el cable adyacente B. La dirección y magnitud exactas dependen del diseño del circuito; podría ser un flujo neto coherente de carga o algo más cercano a corrientes parásitas de carga. Pero en algunos casos esto puede provocar transiciones lógicas no deseadas. Estos efectos de diafonía pueden mitigarse mediante un espaciado óptimo del diseño, blindaje y tiempos de subida de señal controlados.
Esta no es una lista completa, pero es suficiente para empezar a ver paralelismos con la computación cuántica. Ten en cuenta que, en todos los tipos de interacciones no deseadas anteriores, la manifestación del ruido como error lógico solo puede tomar la forma de un 0 que se convierte en 1, o un 1 que se convierte en 0. Esto es todo lo que se permite en el espacio de estados de los bits clásicos.
Ruido y errores cuánticos
En la computación cuántica, el ruido y los errores suelen discutirse conjuntamente, pero es importante reconocer la diferencia. El ruido cuántico se refiere a la perturbación física subyacente que afecta a los qubits y a los sistemas cuánticos. Incluye todas las formas de interacciones o fluctuaciones no deseadas provenientes del entorno, controles imperfectos o defectos de hardware que hacen que el estado cuántico se desvíe del ideal. Los errores cuánticos son las desviaciones o fallos específicos en la información cuántica que resultan del ruido cuántico. Los errores cuánticos son las manifestaciones medibles u operativas del ruido, e incluyen inversiones de bit (bit-flips), inversiones de fase (phase-flips), amortiguamiento de amplitud y más. Tanto el ruido como los errores pueden ocurrir de forma continua. Por ejemplo, el campo utilizado en una puerta cuántica podría estar desviado en un 0.1%, un 0.15%, o cualquier otra fracción. Esto podría resultar en una fase incorrecta en un qubit, también en cualquier cantidad continua. Pero verás que, en la práctica y especialmente en la corrección de errores, es común ver los errores tratados como si fueran discretos: agrupando los efectos acumulados en una inversión de bit discreta o una única rotación de fase. Esto es útil para corregir errores y caracterizarlos, pero no significa que el efecto del ruido sobre un qubit sea únicamente un conjunto discreto de errores.
Hay muchos tipos de ruido que afectan a las computadoras cuánticas. Algunos pueden resultar en múltiples tipos de errores, mientras que otros están asociados con manifestaciones de error específicas. Una lista completa está fuera del alcance de esta lección; aquí hay una lista parcial relevante para el resto de este curso, algunos con paralelismos con el ruido de la computación clásica.
Thermal:
Los dos estados de base computacional y de un qubit están separados por una cantidad de energía muy pequeña. El valor exacto depende, por supuesto, del hardware cuántico. Para qubits de estado sólido (transmón de frecuencia fija) como los utilizados por IBM Quantum®, la brecha de energía entre estos estados es del orden de J, o unos pocos microelectronvoltios. Esta escala de energía se puede relacionar con la frecuencia mediante o con una temperatura característica. Dado que la temperatura está relacionada con la energía cinética promedio de las partículas en una muestra, podemos usar la constante de Boltzmann para obtener una estimación de la temperatura a la cual las partículas promedio tendrían suficiente energía para causar una transición:
Para reducir la probabilidad de que las interacciones térmicas causen transiciones de un estado de base computacional del qubit a otro, la temperatura de los qubits debe mantenerse sustancialmente por debajo de 100 mK, idealmente más cerca de 15-25 mK. Cualquier aumento significativo de la temperatura por encima de estos umbrales resultaría en una ocupación de estados totalmente aleatoria y una pérdida total de la información cuántica.
Esto es análogo a los errores térmicos que pueden ocurrir en las computadoras clásicas, en el sentido de que ambos son de origen térmico — pero la escala de temperatura es obviamente diferente, y también lo es el mecanismo de pérdida de información.
Diafonía e interferencia:
La diafonía en la computación cuántica se refiere a cualquier acoplamiento o interferencia no deseados entre qubits o líneas de control, de tal manera que una operación o señal destinada a un qubit afecta inadvertidamente a otros. Se manifiesta como errores o correlaciones entre qubits que idealmente deberían ser independientes.
En arquitecturas de qubits superconductores como las utilizadas por IBM®, la diafonía puede surgir de señales de control de microondas que se filtran a qubits vecinos, acoplamiento no intencionado entre resonadores de lectura, o diafonía de flujo entre bucles de qubits.
Muchos de los enfoques para minimizar la diafonía están incorporados en el diseño de una computadora cuántica, como el espaciado de los qubits y garantizar que los qubits adyacentes tengan frecuencias operativas diferentes. También existen enfoques de software para mitigar los errores de diafonía, que se analizarán en lecciones posteriores.
Operaciones de puerta imperfectas:
Las operaciones sobre los qubits se llevan a cabo utilizando hardware con precisión finita y que puede estar sujeto a ruido u otras fuentes de imprecisión. En particular, se utilizan pulsos de microondas de duraciones específicas y con orientaciones específicas para implementar puertas de rotación. Supongamos, por ejemplo, que un pulso de microondas debe rotar 0.30 radianes alrededor del eje . Existe una precisión finita en la orientación, lo que genera cierta imprecisión en el eje de rotación. Además, siempre existe una compensación fundamental entre la frecuencia de un pulso y su duración. Un pulso muy largo puede tener un comportamiento esencialmente sinusoidal con prácticamente una sola frecuencia. Para formar un paquete corto, se necesita una superposición de muchas frecuencias. Esta es la misma compensación que subyace en la relación de incertidumbre energía-tiempo, aunque la precisión de las puertas aún no está llegando a estos límites fundamentales; todavía hay margen de mejora.
Ruido intrínsecamente cuántico:
Este último tipo de ruido es bastante diferente de los demás; no se debe a errores, sino a la naturaleza de la mecánica cuántica. Supongamos que un qubit en el estado cuántico se mide y colapsa a un autoestado ( o ). En un sistema de transmón de frecuencia fija, el qubit está acoplado dispersivamente a un resonador de microondas cuya frecuencia de resonancia depende ligeramente del estado del qubit. Se envía un pulso de sondeo de microondas a través del resonador, y la señal saliente adquiere un desplazamiento de fase y un cambio de amplitud dependientes del estado. Esta señal se amplifica y se mide luego utilizando electrónica clásica.
A nivel cuántico, la señal de medición es transportada por un campo de microondas coherente con un número promedio finito de fotones. Debido a la naturaleza cuántica de los campos electromagnéticos, las cuadraturas del campo exhiben fluctuaciones intrínsecas. Estas fluctuaciones son independientes de las imperfecciones técnicas y surgen incluso para un estado coherente ideal. Aumentar el número promedio de fotones incrementa la señal de medición, pero el nivel de ruido fundamental permanece finito, de modo que la distinguibilidad entre los resultados mejora solo como .
Por lo tanto, incluso si el qubit está perfectamente preparado y la cadena de medición es ideal, la señal de lectura correspondiente a un estado dado del qubit no es un único valor fijo, sino una distribución que limita qué tan bien se pueden distinguir los resultados. Este solapamiento representa una fuente fundamental de incertidumbre en el propio proceso de medición. En la práctica, aunque el ruido técnico proveniente de amplificadores y otros componentes suele dominar, este ruido cuántico intrínseco establece un límite inferior en la fidelidad de lectura.
La incertidumbre no es error:
Todas estas fuentes de ruido son diferentes de la incertidumbre fundamental asociada con las mediciones de estados cuánticos. En contraste, supongamos que tenemos un qubit en un estado cuántico:
Este estado tiene un 64% de probabilidad de medirse en el estado y un 36% de probabilidad de medirse en el estado . Pero una sola medición solo arrojará un o un — así que una sola medición rara vez nos dirá mucho sobre el estado previo a la medición. Se requieren muchas mediciones para obtener información detallada sobre el estado. De diez mediciones, podríamos esperar que seis o siete arrojen . Pero no sería sorprendente que las primeras diez mediciones resultaran ser todas (como lanzar una moneda justa y obtener "cara" diez veces seguidas: poco común, pero completamente plausible). Si repitiéramos la medición 1000 veces y siempre obtuviéramos , eso sí sería sorprendente.
Por lo tanto, existe incertidumbre en nuestro conocimiento del estado cuántico basado en cualquier número finito de mediciones. A medida que repetimos las mediciones, nuestro conocimiento del estado cuántico previo a la medición mejora, pero nunca es perfecto. Coloquialmente, se podría decir que siempre hay algún "error" subyacente en cualquier resultado de medición cuántica. Pero este es un uso diferente del término "error", y se describe mejor como incertidumbre estadística. El proceso de aumentar el conocimiento de un estado cuántico mediante muchas mediciones se llama tomografía de estado cuántico. Sin embargo, la tomografía de estado cuántico no se limita a mediciones a lo largo de Z; generalmente se refiere a mediciones a lo largo de ejes ortogonales (como X, Y y Z) para la determinación de amplitudes y fase relativa. Para más información sobre este proceso, consulta esta sección en el curso de John Watrous sobre la Formulación General de la Información Cuántica, o para una implementación práctica, consulta esta lección de teletransporte del curso sobre Computación Cuántica a Escala de Utilidad.
Observar los errores y su acumulación
En esta sección, utilizaremos computadoras cuánticas reales para observar los errores cuánticos y su acumulación bajo diferentes condiciones. En la práctica, muchas fuentes de errores cuánticos suelen estar presentes simultáneamente. Para observar diferentes tipos de errores de una manera algo aislada, necesitaremos usar circuitos diseñados para ese aislamiento. Los circuitos utilizados en aplicaciones de computación cuántica se verán mucho más complicados.
Comencemos con los errores de relajación de energía.
Errores de relajación de energía ()
Recordando nuestra discusión sobre el ruido térmico, a cualquier temperatura distinta de cero, existe cierta probabilidad de que un sistema cuántico experimente una transición entre autoestados de energía. La relajación () domina porque está impulsada por emisión espontánea (independiente de la temperatura), mientras que la baja temperatura suprime el proceso competidor de excitación. Cuanto más tiempo permanece inactivo un qubit, más tiempo tiene para experimentar dicha transición. La probabilidad de que un qubit preparado en el estado permanezca en después de un tiempo viene dada por
Aquí, el tiempo es un tiempo característico determinado experimentalmente que es diferente para cada qubit, e incluso puede cambiar ligeramente con el tiempo. Las computadoras cuánticas de IBM® se someten a pruebas de referencia regularmente, por lo que los tiempos que encuentras listados para los qubits en las computadoras cuánticas de IBM deberían ser precisos y estar actualizados. Un valor alto de significa que el qubit permanece en el estado que preparaste durante más tiempo (en promedio). Los valores típicos de difieren según la arquitectura; los qubits en las computadoras cuánticas de IBM suelen tener tiempos del orden de 200-300 , y puedes consultar los valores más recientes en la página de Recursos de cómputo.
El tiempo característico mide algo diferente: la pérdida de información de fase. Volveremos a esto más adelante.
Para observar los errores de relajación de energía, prepararemos qubits en el estado , y luego los dejaremos intencionalmente inactivos durante largos periodos de tiempo. Esta es la parte artificial. En flujos de trabajo cuánticos reales, podrías tener algunos qubits que permanecen inactivos durante largos periodos mientras se realizan procesos en otros qubits; por lo tanto, algunas instancias de tales tiempos de inactividad no son artificiales.
Comencemos importando algunos paquetes y seleccionando el backend menos ocupado.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"cycler": "cycler", "matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_runtime import QiskitRuntimeService
import numpy as np
import matplotlib.pyplot as plt

# If your credentials are already saved locally
service = QiskitRuntimeService()

# To load an unsaved instance, uncomment the line below
# service = QiskitRuntimeService(channel = "ibm_quantum_platform", instance = "your crn here")

# To select the least-busy backend:
# backend = service.least_busy(simulator=False, operational=True)

# To specify the backend by name:
backend = service.backend("ibm_boston")

props = backend.properties()
print(backend)
<IBMBackend('ibm_boston')>
Ahora seleccionaremos un qubit para trabajar, en este caso, el qubit cero. Podemos importar directamente las propiedades de este qubit, incluyendo y .
qubit_idx = 0
qubit_props = props.qubit_property(qubit_idx)

t1 = qubit_props["T1"][0]  # * 1e6  # Convert seconds to µs
t2 = qubit_props["T2"][0]  # * 1e6  # Convert seconds to µs

# print(f"Qubit {qubit_idx}: T1={t1} µs, T2={t2} µs")
print(f"Qubit {qubit_idx}: T1={t1} s, T2={t2} s")
Qubit 0: T1=0.0002737016180018049 s, T2=0.00042784777605680494 s
Saber en unidades de microsegundos es importante, pero es posible que no tengas una idea intuitiva de lo que eso significa. Después de todo, las operaciones de puerta en las computadoras cuánticas son muy rápidas. La verdadera pregunta es: cuánto podemos hacer en una computadora cuántica en esa cantidad de tiempo. Para ello, es útil relacionar con otras escalas de tiempo utilizadas en la computación cuántica — específicamente con las siguientes:
-
tiempo de muestreo - el tic de reloj más pequeño sobre el cual se pueden implementar procesos de control en la computadora cuántica.
-
tiempos de puerta de un solo qubit - el tiempo necesario para implementar una operación de puerta en un solo qubit. Esto no será un único valor, sino un rango de valores posibles según el tipo de puerta.
-
tiempos de puerta de dos qubits - el tiempo necesario para implementar una operación de puerta en dos qubits adyacentes. Esto también puede tomar un rango de valores, pero típicamente es aproximadamente un orden de magnitud mayor que para una puerta de un solo qubit.
Comprobemos para nuestro backend, y mostremos algunos rangos plausibles para los tiempos de puerta.
print(f"Using backend: {backend.name}")

# Access the backend target
target = backend.target

def get_gate_times(target, gate_name):
    results = []

    if gate_name not in target:
        return results  # gate not supported

    # target[gate_name] is a dict: {(qubits): InstructionProperties}
    for qubits, props in target[gate_name].items():
        if props.duration is not None:
            results.append({"qubits": qubits, "duration_ns": props.duration * 1e9})

    return results

# Query some gates
for gate in ["cz", "x"]:
    times = get_gate_times(target, gate)

    print(f"\nGate: {gate}")
    if times:
        for entry in times[:5]:
            print(f"  Qubits {entry['qubits']}: {entry['duration_ns']:.2f} ns")
    else:
        print("  Not available on this backend")
Using backend: ibm_boston

Gate: cz
  Qubits (0, 1): 68.00 ns
  Qubits (1, 0): 68.00 ns
  Qubits (1, 2): 68.00 ns
  Qubits (2, 1): 68.00 ns
  Qubits (2, 3): 88.00 ns

Gate: x
  Qubits (0,): 32.00 ns
  Qubits (1,): 32.00 ns
  Qubits (2,): 32.00 ns
  Qubits (3,): 32.00 ns
  Qubits (4,): 32.00 ns
Estos tiempos de puerta variarán de un backend a otro. Codificaremos directamente un tiempo de puerta de dos qubits obtenido de ibm_boston de 68 ns.
dt = backend.configuration().dt
two_q_gate_time = 68e-9
print("The sampling time is : ", dt)
print("dts per T_1 : ", t1 / dt)
print("2-qubit characteristic time : ", two_q_gate_time)
print("The sampling time intervals per two-qubit gate : ", two_q_gate_time / dt)
print("2-qubit gates per T_1 : ", t1 / two_q_gate_time)
The sampling time is :  4e-09
dts per T_1 :  68425.40450045122
2-qubit characteristic time :  6.8e-08
The sampling time intervals per two-qubit gate :  17.0
2-qubit gates per T_1 :  4025.0237941441897
Ten en cuenta que aquí no se han considerado otras fuentes de error ni su supresión o mitigación. Los errores de no son los únicos errores en juego en un sistema cuántico, así que no te preocupes demasiado por estos números. Esto simplemente significa que, en ausencia de cualquier supresión, podríamos implementar de manera plausible del orden de miles de puertas de dos qubits antes de que los errores de comiencen a dominar. Otros errores típicamente dominarán en profundidades mucho menores, y, a la inversa, podría valer la pena suprimir los errores de incluso en tiempos mucho más cortos que los necesarios para eliminar la señal por completo.
Comenzaremos utilizando un simulador con un modelo de ruido, y luego compararemos los resultados con hardware real.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, thermal_relaxation_error
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import EstimatorV2

pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)
Definamos un paso de tiempo para nuestras mediciones correspondiente a la estimación más alta para un tiempo de puerta de dos qubits. Luego construiremos 50 circuitos en incrementos de ese paso de tiempo. De esta manera, veremos qué sucede en una escala de tiempo similar a implementar 80 puertas de dos qubits. La precisión aquí no es crítica, así que usaremos solo un puñado de disparos.
n_points = 50  # We will show 50 steps
delay_unit = 80  # The delay in units of two-qubit-time from above
shots = 100
Construimos un modelo de ruido para nuestro simulador que incluye explícitamente errores de relajación térmica.
# Create noise model with thermal relaxation for delays
noise_model = NoiseModel()
error = thermal_relaxation_error(
    t1, t2, two_q_gate_time * delay_unit
)  # error model characterized by times in ns
noise_model.add_all_qubit_quantum_error(error, ["delay"])

sim = AerSimulator(noise_model=noise_model)
Ahora construimos nuestros circuitos y observables. Estos son excepcionalmente simples. Los circuitos consistirán simplemente en preparar el qubit en e implementar retardos durante periodos de tiempo cada vez mayores, utilizando los tiempos de puerta característicos y definidos anteriormente. Los observables serán simplemente , porque lo que queremos saber es si el qubit ha permanecido en o ha decaído a . Aunque la transpilación no siempre es necesaria para los simuladores, procedemos a transpilar nuestros circuitos aquí para su uso posterior en un backend real.
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times_sim = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        for j in range(i):
            qc.delay(delay_unit * two_q_gate_time, 0, "s")
            j = j + 1
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times_sim.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)
Ejecutamos nuestro trabajo utilizando un simulador.
pubs = list(zip(circuits, obs))

# Create AerSimulator with noise model as backend
simulator = AerSimulator(noise_model=noise_model)

# Create SamplerV2 from the AerSimulator backend
estimator = EstimatorV2.from_backend(simulator)

# Run the sampler on the circuit, specify shots
job = estimator.run(pubs)
result = job.result()
Finalmente, graficamos las salidas.
# Optional: color palette similar to 'mpl', style = 'clifford'

from cycler import cycler

plt.rcParams["axes.prop_cycle"] = cycler(
    color=[
        "#4C78A8",  # muted blue
        "#72B7B2",  # teal
        "#54A24B",  # green
        "#9C89CC",  # purple
        "#B279A2",  # mauve
    ]
)

# Everything else stays at Matplotlib defaults

# Example data: assume result is a list of objects with structure result[i].data.evs.item()
# and delay_times is already defined as a list of floats.

# Extract y-values
y_sim_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_sim_values = delay_times_sim

# Create the plot
plt.figure(figsize=(8, 5))
plt.plot(x_sim_values, y_sim_values, marker="o", linestyle="-", label="EV Data")

plt.xlabel("Idle Time (s)")
plt.ylabel("Probability of measuring |1>")
plt.title("T1 Decay")
plt.grid(True)
plt.show()
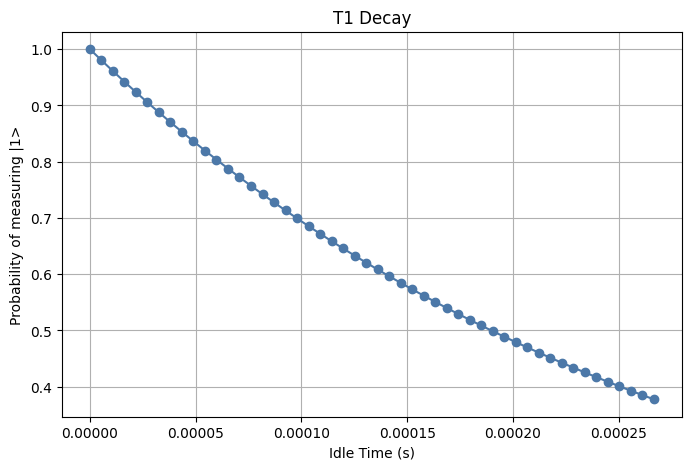
La caída exponencial es claramente visible, y en este tiempo, decae a poco menos del 40% de probabilidad de estar en . Ten en cuenta que esto es exactamente consistente con el modelo: donde hemos elegido que el máximo sea del mismo orden que ; recuerda que dijimos que podría corresponder a 60 puertas (o ese orden de magnitud), y aquí corresponde a 60 puertas. Por lo tanto
Ahora ejecutemos los mismos circuitos en una computadora cuántica real. Para abarcar la misma duración de retardo con menos trabajos, aumentaremos la unidad de retardo y reduciremos el número de puntos.
# This took 27 s on ibm_boston

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same time parameters and shots
n_points = 10
delay_unit = 400
shots = 100

# Measure Pauli Z's as your observables
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        qc.delay(delay_unit * two_q_gate_time * i, 0, "s")
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)

pubs = list(zip(circuits, obs))
estimator = EstimatorV2(mode=backend)
job = estimator.run(pubs=pubs)
result = job.result()

# To print the job id for later retrieval of data
# job_id = job.job_id()
# print(f"Job ID: {job_id}")
Ahora graficamos los resultados.
fig, ax = plt.subplots()

# Convert from the expectation value of Z to the probability of a transition
y_real_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_real_values = delay_times

# Exponential decay to match theoretical model
t_smooth = np.linspace(0, x_sim_values[19], 100)  # Smooth x-range covering your data
y_decay = np.exp(-t_smooth / (t1))  # y = exp(-t/t1)
ax.plot(t_smooth, y_decay, "k--", linewidth=1, label=f"Perfect Decay (t1={t1:3f} s)")

# Add simulator values
ax.scatter(x_sim_values, y_sim_values, label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(x_real_values, y_real_values, label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Idle Time (s)")
ax.set_ylabel("Probability of measuring |1>")
ax.legend()
ax.set_title("T1 Decay")
ax.grid(True)

plt.show()
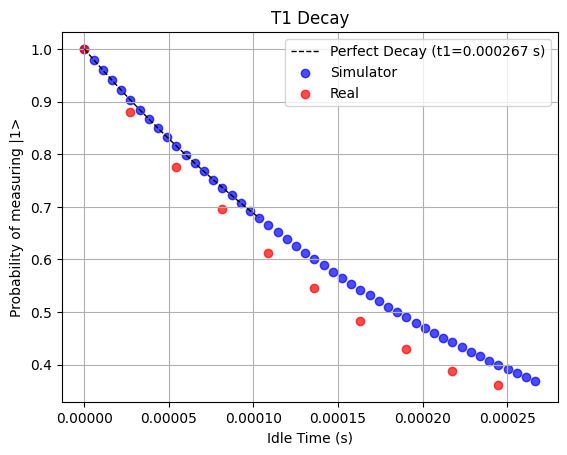
Como podemos ver, la caída del estado a lo largo del tiempo coincide con la teoría (y con la definición de ). Además, el simulador es bastante bueno para igualar el comportamiento de la computadora cuántica real en este caso. Aquí hay algunas cosas a tener en cuenta sobre la caída de este estado:
- Hemos retrasado artificialmente la medición durante un tiempo poco realista. Estos retardos corresponden a la escala de tiempo de circuitos extremadamente profundos que podrían constar de miles de puertas de dos qubits. Esto se hizo solo para mostrar que los efectos del ruido térmico existen. En circuitos reales aplicados a problemas del mundo real, se realizarían operaciones en otros qubits mientras que unos pocos podrían permanecer inactivos el tiempo suficiente para que los errores de relajación de energía importen — pero otros errores dominarían antes de alcanzar un completo.
- No se han utilizado técnicas de mitigación o supresión de errores. Podemos alterar esta curva de decaimiento utilizando las técnicas que aprenderemos en este curso.
- Aquí usamos solo 100 disparos, lo cual es inusualmente bajo porque solo buscábamos demostrar que el efecto existe. Es probable que uses más de 1,000 disparos en aplicaciones.
Esta primera visualización del error prácticamente no requirió puertas, aparte de los retardos (y la única puerta X usada para preparar ). Veamos ahora otro ejemplo que se centra en el error de puerta.
Errores de puerta y acumulación
Cuando aplicamos una puerta cuántica, digamos una puerta , en teoría esa puerta rota un estado cuántico un ángulo de radianes alrededor del eje en la esfera de Bloch, mapeando a mediante
Sin embargo, una puerta real es imperfecta. Podría estar orientada de forma imperfecta (causando rotaciones que no son perfectamente alrededor del eje X) o podría causar una rotación ligeramente mayor o menor de lo previsto. Modelemos un error de puerta como una sobre/sub-rotación pura en un ángulo pequeño .
Si se aplica una puerta imperfecta muchas veces, los pequeños errores pueden acumularse. A veces estos múltiples errores incluso hacen que el estado se desplace en la misma dirección cada vez (un fenómeno llamado "acumulación coherente", que retomaremos más adelante). Veamos qué sucede cuando aplicamos una puerta X real a un qubit muchas veces.
# This took 78 s on penguino1

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same bit flips
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2(mode=backend)
results = estimator.run(pubs=pubs).result()
real_expectations = [pub_res.data.evs for pub_res in results]
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService()           # uses stored IBM Quantum account
# job_id = "d5immof67pic7386l8eg"

# job = service.job(job_id)                 # retrieve the job
# results = job.result()                        # this is your .result() object
# Convert from the expectation value of Z to the probability of a transition
# y_real_values = [(1-r.data.evs.item())/2 for r in results]

# Create the plot
plt.figure(figsize=(8, 5))
# plt.plot(range(max_depth + 1), y_real_values, 'o-')
# plt.plot(x_real_values, y_real_values, marker='o', linestyle='-', color='blue', label='EV Data')
plt.plot(
    range(max_depth + 1),
    real_expectations,
    marker="o",
    linestyle="-",
    color="blue",
    label="EV Data",
)

plt.xlabel("Number of Flip-Back Cycles")
plt.ylabel("Expectation ⟨Z⟩")
plt.title("Accumulated Gate Noise Effects on Flips")
plt.grid(True)
plt.show()
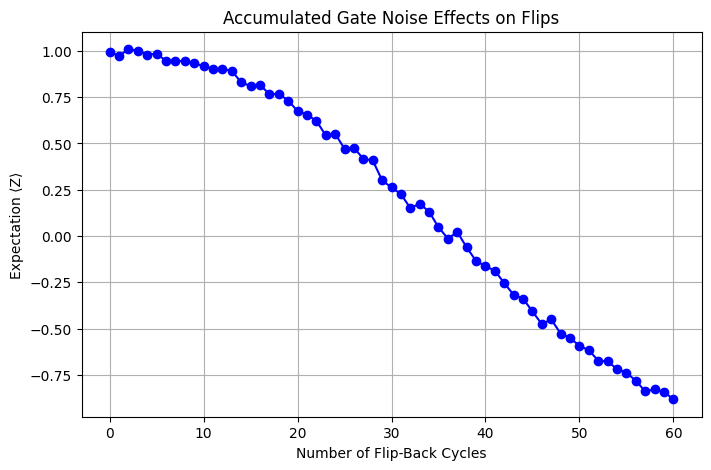
El valor esperado comienza alrededor de 1.0, como se esperaba, y decae, ¡pero no simplemente decae a cero! Se vuelve negativo. Si esto fuera ruido térmico o interacciones aleatorias, no haría que tuviera más probabilidad de ser medido que . Este error es claramente diferente. Y tiene sentido en el contexto de nuestra discusión sobre sobre/sub-rotación. Si cada par de rotaciones que debería cancelarse en realidad termina rotando un ángulo pequeño, entonces muchas repeticiones de este tipo permitirían que el estado rote lentamente desde hacia .
Es poco probable que la acumulación de errores mostrada aquí se produzca de forma tan limpia en un flujo de trabajo real. Por un lado, hemos desactivado explícitamente la mitigación de errores y hemos realizado la misma secuencia repetitiva de puertas para permitir que los errores se acumulen de forma coherente. Esto se hace únicamente para demostrar que estos errores existen. Cuando usamos técnicas de manejo de ruido (por ejemplo, Pauli twirling), podemos influir en cómo se acumula el error, lo que a menudo produce un error general menor.
Podemos comprobar exactamente qué tan bien se ajusta nuestro modelo de este error a los datos experimentales construyendo explícitamente un modelo de ruido y usando un simulador. En el modelo siguiente, incorporamos explícitamente un error correspondiente a 0.025 radianes. Ese no es un número mágico; simplemente se puede ajustar el error hasta que describa razonablemente el experimento.
from qiskit_aer.noise import NoiseModel, coherent_unitary_error
from qiskit_aer import AerSimulator
import numpy as np

# For your SINGLE-QUBIT test on qubit 0, just override X error specifically
noise_model = NoiseModel.from_backend(backend, gate_error=True, thermal_relaxation=True)

theta_error = 0.025  # model over-rotation error around 0.01-0.03 radians
U_over = np.array(
    [
        [np.cos(theta_error / 2), -1j * np.sin(theta_error / 2)],
        [-1j * np.sin(theta_error / 2), np.cos(theta_error / 2)],
    ]
)

unitary_error = coherent_unitary_error(U_over)
# Target ONLY qubit 0 (your circuit) - no warning!
noise_model.add_quantum_error(unitary_error, ["x"], [0])

simulator = AerSimulator(noise_model=noise_model)
WARNING: quantum error already exists for instruction "x" on qubits (0,) , appending additional error.
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2.from_backend(simulator)
results = estimator.run(pubs).result()
expectations = [pub_res.data.evs for pub_res in results]  # no [0], use value directly
Ahora podemos graficar juntas las curvas real y simulada.
fig, ax = plt.subplots()

# Add simulator values
ax.scatter(range(max_depth + 1), expectations, c="blue", label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(range(max_depth + 1), real_expectations, c="red", label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Number of Flip-Back Cycles")
ax.set_ylabel("Expectation ⟨Z⟩")
ax.set_title("Accumulated Gate Noise Effects on Flips")
ax.legend()
ax.grid(True)

plt.show()
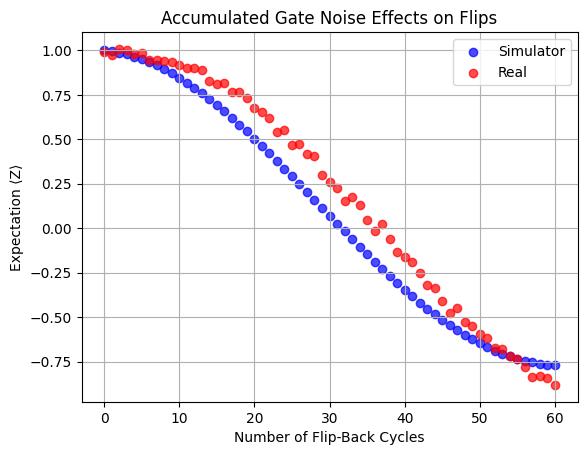
El error en el circuito real fue descrito bastante bien por el modelo de error de sobre/sub-rotación. Es evidente que distintos tipos de ruido y errores se acumularán de forma diferente y darán lugar a efectos drásticamente distintos en la fidelidad de nuestros circuitos cuánticos. Por ello, resulta muy importante clasificar y caracterizar los errores que pueden ocurrir de una manera más formal de lo que hemos hecho hasta ahora.
Caracterización de errores cuánticos
Ya hemos descrito algunas de las fuentes de ruido cuántico, y podríamos categorizar los errores según los tipos de ruido que los causan. Pero podría haber diferentes categorías de errores cuánticos que resultan útiles para la corrección y mitigación de errores. Por ejemplo, necesitamos saber en qué punto ocurren los errores y cómo se acumulan si queremos corregirlos o mitigarlos. Al especificar dónde (en qué procesos) ocurren los errores, una categoría común e importante son los errores de preparación de estado y medición (o errores SPAM, por sus siglas en inglés). Aquí, el término "preparación de estado" no significa todo lo que se hace sobre un estado para prepararlo para la medición. Más bien, se refiere a la inicialización de los qubits, a la "preparación" de los qubits para la ejecución de un algoritmo, por lo que esta categoría SPAM excluye cosas como los errores de puerta durante la ejecución del algoritmo.
Otra distinción importante es si los errores son coherentes o incoherentes. Para resumir brevemente (los analizamos con más detalle más abajo), los errores coherentes se modelan típicamente mediante operaciones unitarias y preservan la pureza del estado. Los errores incoherentes se modelan mediante canales cuánticos no unitarios y, por lo general, reducen la pureza del estado. Es fácil imaginar los errores incoherentes como interacciones térmicas que causan pérdida de información cuántica, pero en realidad podrían deberse a cualquier acoplamiento aleatorio con el entorno. Como ejemplo de un error coherente, supongamos que hay una imperfección en la orientación del pulso al implementar una puerta RY, de manera que una puerta en realidad provoca . Tal imperfección siempre causaría una rotación errónea alrededor de X en la misma dirección. Esto sería un error coherente.
Ten en cuenta que los errores SPAM incluyen una mezcla de errores coherentes, como fallos sistemáticos de control, y errores incoherentes, como la pérdida de fotones y los efectos térmicos. Dado que esto involucra múltiples pasos y fuentes de error, los errores SPAM se describen mejor como una combinación de errores tanto coherentes como incoherentes.
Errores SPAM
Como sugiere el nombre, los errores SPAM surgen en dos etapas distintas de un experimento cuántico: la preparación inicial y la lectura/medición. Los errores de preparación de estado ocurren cuando el hardware no logra inicializar de forma confiable los qubits en el estado inicial deseado ( para las computadoras cuánticas de IBM). Las causas incluyen:
- excitación térmica (los qubits reales no están perfectamente enfriados y ocasionalmente pueden comenzar en en lugar de )
- fotones residuales o ruido en los resonadores en qubits superconductores
- derivas en la calibración que afectan la precisión con la que se reinician los qubits
Los errores de medición ocurren durante el proceso de lectura, cuando el aparato de medición identifica erróneamente el estado del qubit. Las fuentes incluyen:
-
ruido del amplificador de lectura que causa confusión entre y
-
relajación del qubit durante la lectura (por ejemplo, un qubit en decae a justo antes o durante la medición)
-
diafonía (crosstalk) entre líneas de lectura: leer un qubit influye ligeramente en las lecturas de los qubits vecinos
-
Umbrales de discriminación imperfectos en los sistemas de medición basados en resonadores de IBM
Los errores SPAM son principalmente incoherentes. Los errores de preparación actúan como mezclas aleatorias de estados excitados y fundamentales. Los errores de medición se comportan como confusión clásica: con probabilidad , se reporta como o viceversa. Estos son distintos de los errores unitarios coherentes (como puertas mal calibradas que causan desplazamientos de fase sistemáticos). Los errores SPAM, en cambio, se asemejan al ruido clásico aleatorio, aunque pueden existir sesgos coherentes poco frecuentes en la lectura.
Los errores SPAM pueden ser problemáticos para el benchmarking aleatorizado o para circuitos de poca profundidad, donde la preparación de estado y la medición representan una gran fracción del error total. Son menos problemáticos en circuitos muy profundos, especialmente en aquellos con muchas puertas de dos qubits.
Matemáticamente, los errores SPAM pueden describirse como la generación de una distribución ruidosa que está relacionada con la distribución ideal mediante una matriz :
Aquí es la probabilidad de medir la cadena de bits , y es la probabilidad de obtener el estado cuando el estado debería haberse preparado en el estado . Imagina el contexto de las cadenas de bits muestreadas por Sampler. Tu distribución medida de estados consistirá en muchas mediciones precisas, pero también en algunas mediciones en las que las instrucciones para la preparación de estado no coinciden con el estado observado. Esto significa que las probabilidades estarán ligeramente desviadas.
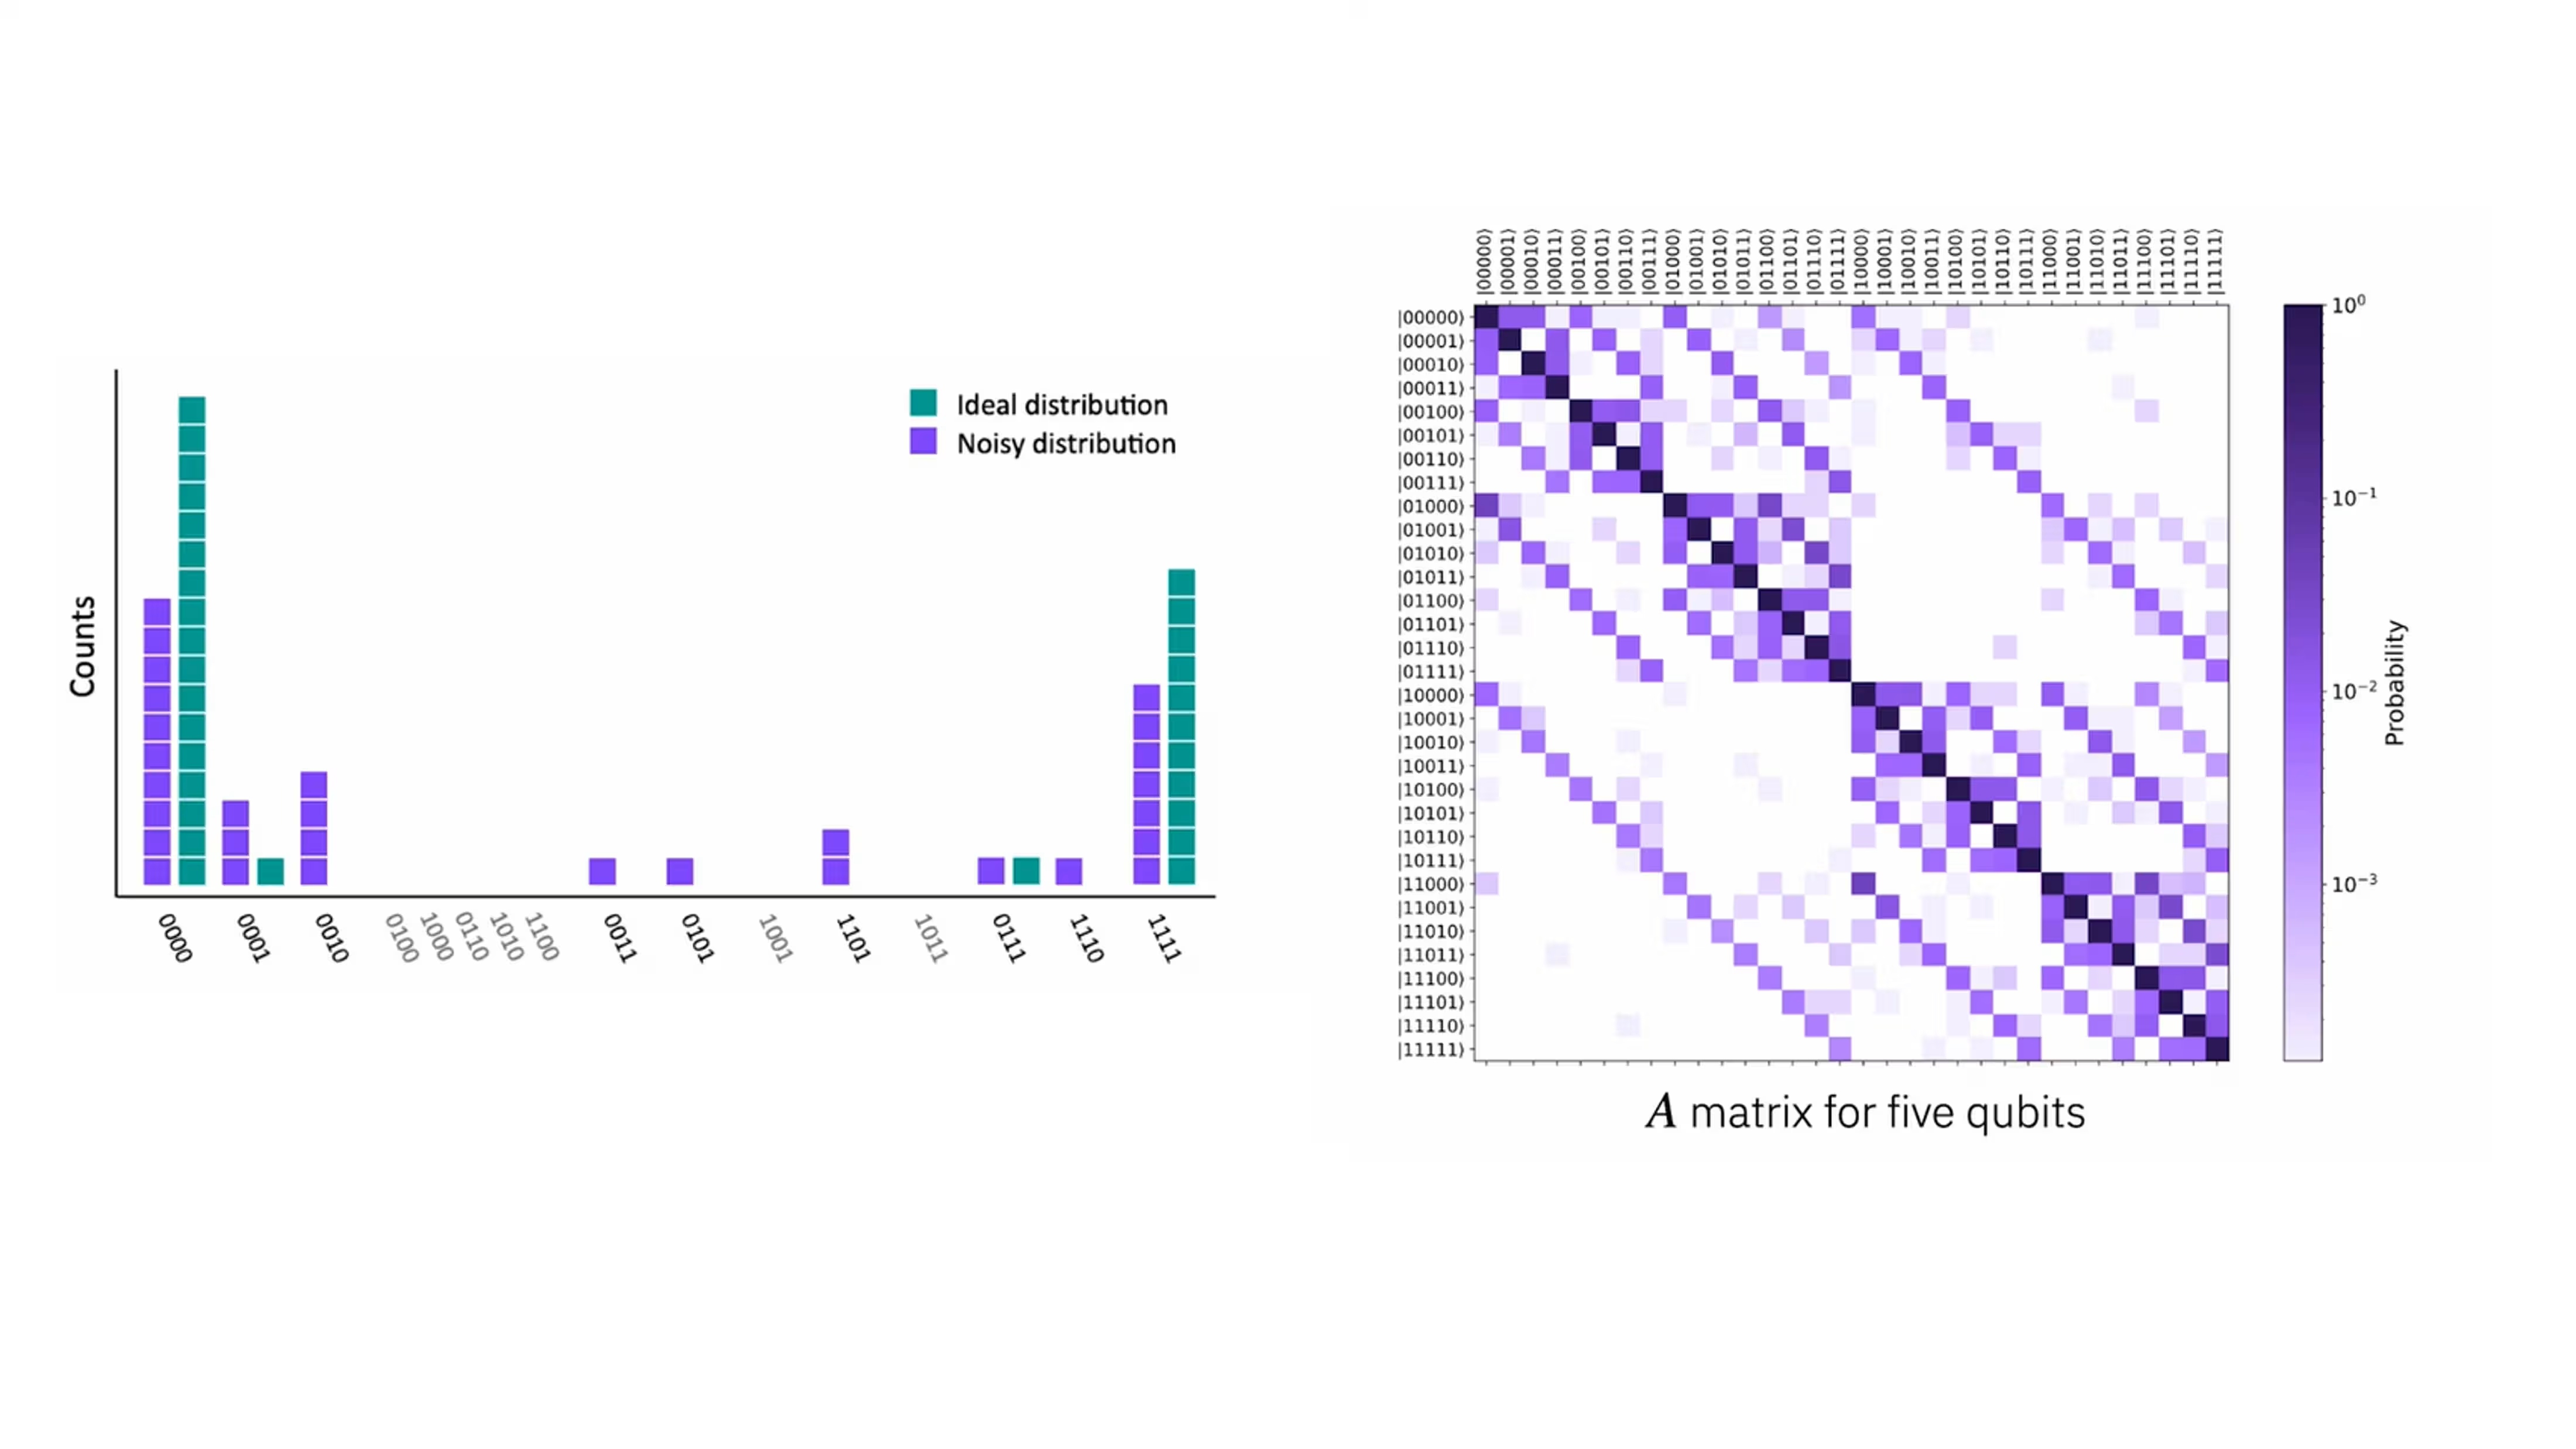
En la figura anterior, la parte (a) muestra la distribución ideal de un estado GHZ en color verde azulado, y las mediciones reales en morado. En la parte (b) vemos un ejemplo de una matriz . Ten en cuenta que la matriz no es perfectamente simétrica respecto a la diagonal, ya que cada qubit no tiene por qué tener la misma probabilidad de devolver erróneamente un 0 que de devolver erróneamente un 1. En la práctica, a menudo es difícil separar los errores de preparación y de lectura, por lo que suelen combinarse en un único tratamiento (de ahí el uso común de SPAM).
Una forma de corregir estos errores SPAM es utilizar circuitos simples con resultados de medición ideales conocidos y compararlos con los resultados medidos en presencia de errores SPAM. Esto puede usarse para obtener por ingeniería inversa los resultados ideales de circuitos más complejos. Para estados generales de alta entropía, esto podría requerir construir una matriz con probabilidades, pero en casos menos extremos estos errores pueden mitigarse.
Errores coherentes frente a errores incoherentes
Los errores coherentes son rotaciones erróneas, sistemáticas, deterministas y unitarias del estado cuántico. Surgen de operaciones cuánticas imperfectas que se desvían de manera predecible. Los ejemplos incluyen pequeños errores en la rotación aplicada por puertas de rotación de un solo qubit, incluidos los causados por la deriva de calibración, que provocaría de forma consistente una sobre- o sub-rotación. Matemáticamente, podríamos escribir que una puerta de rotación real, digamos , viene dada por la puerta de rotación ideal más algún error adicional:
para alguna pequeña sub- o sobre-rotación . Otros ejemplos incluyen una puerta de dos qubits que añade un pequeño desplazamiento de fase no deseado, y pulsos de control que se desvían sistemáticamente de la forma ideal.
Una característica clave de los errores coherentes es que son deterministas y pueden modelarse, a su vez, mediante puertas unitarias. En consecuencia, preservan la pureza del estado cuántico: la información cuántica no se pierde, simplemente se ha procesado de forma imperfecta. Otro punto importante a destacar es que los errores coherentes repetidos interfieren constructivamente y, en ocasiones, crecen de forma cuadrática con el número de puertas.
Estos errores a veces son predecibles y, por lo tanto, pueden calibrarse en cierta medida. Pero los errores coherentes que persisten pueden acumularse rápidamente, causando desviaciones problemáticas respecto a los estados ideales. Esto significa que a veces resulta ventajoso "aleatorizar" intencionalmente los errores coherentes. Este procedimiento y su utilidad se tratarán en la lección sobre mitigación de errores.
Por qué son problemáticos
Los errores coherentes pueden "acumularse" de maneras peligrosas, produciendo grandes desviaciones del estado correcto si no se aleatorizan o corrigen.
Los errores incoherentes son estocásticos, aleatorios y, a menudo, no unitarios. Surgen de interacciones con el entorno o fuentes de ruido no controladas. Ya hemos visto algunos ejemplos: la relajación de energía / decaimiento es incoherente. También lo son el ruido estocástico de puertas, el ruido térmico y el error de medición.
La característica clave de los errores incoherentes es que no son iguales cada vez que se realiza una operación. Son no unitarios, por lo que no pueden modelarse mediante una simple puerta cuántica unitaria, como sí podían modelarse los errores coherentes. Debido a que son incoherentes, normalmente se acumulan de forma lineal, como el ruido aleatorio, y no como una sobre-rotación consistente.
Los errores incoherentes hacen que los qubits pierdan información de manera irreversible (pérdida de pureza e información de fase).
Entonces, ¿cuál es peor? Como con la mayoría de las cosas en la computación cuántica, depende. La conclusión es que los errores coherentes se acumulan más rápido y de forma no lineal (lo cual es malo). Pero pueden calibrarse parcialmente y la información de fase sigue presente en tu sistema, si logras descubrir cómo extraerla correctamente. Los errores incoherentes se acumulan de forma lineal, lo cual es bueno por dos razones: es más lento que la acumulación coherente y es bastante fácil ver cómo escalan los efectos de los errores incoherentes en procesos como la extrapolación a ruido cero (ZNE), que se tratará en la lección sobre mitigación de errores. Sin embargo, cuando ocurren errores incoherentes, la información cuántica se pierde de verdad, no simplemente se oscurece.
Matrices de densidad y canales cuánticos
En las siguientes secciones, profundizaremos en algunos tipos de errores coherentes e incoherentes y veremos cómo pueden modelarse matemáticamente usando canales cuánticos. Primero, conviene hacer un breve repaso de las matrices de densidad y los canales cuánticos. Para un tratamiento completo y riguroso de estos temas, consulta el curso de John Watrous General formulation of quantum information en IBM Quantum Learning. El tratamiento aquí estará basado en ejemplos y será menos formal.
Los canales cuánticos son la forma más general de describir cómo evoluciona, interactúa y sufre ruido un sistema cuántico. Si estás acostumbrado a los estados puros y la evolución unitaria, los canales cuánticos son el siguiente paso natural.
En la mecánica cuántica estándar, un estado "puro" se escribe como . Aquí "puro" se refiere a la pureza de la información o al conocimiento de la preparación del estado; no significa un autoestado de algún sistema. Como ejemplo con un qubit, es un estado puro porque tenemos un conocimiento perfecto de las amplitudes relativas y la fase. La evolución temporal de un estado puro de este tipo está gobernada por un operador unitario :
según la ecuación de Schr"odinger, en la cual , donde es el hamiltoniano del sistema y es la constante de Planck reducida, que a menudo se "fija igual a uno" o, más rigurosamente, se absorbe en el hamiltoniano de modo que todas las energías se expresan en unidades de .
La evolución unitaria es reversible, determinista y aislada. Pero esto resulta inadecuado para describir sistemas cuánticos reales. En los sistemas cuánticos reales:
- Realizamos mediciones, colapsando el estado cuántico en un autoestado del sistema. Esto es explícitamente no unitario.
- El sistema interactúa con un entorno. Esto significa que el sistema no está realmente aislado, y dado que el entorno no puede rastrearse hasta el infinito, esto corresponde a una pérdida de información.
- En términos prácticos: el ruido corrompe el estado. Y más.
La evolución unitaria por sí sola no puede describir estos procesos; por lo tanto, necesitamos una representación más general de los estados y procesos cuánticos. Un estado mixto describe una distribución clásica de estados cuánticos. Es decir, ya estamos familiarizados con el hecho de que el estado cuántico: tiene un 50% de probabilidad de ser medido (colapsado en información clásica) en el estado y un 50% de probabilidad de ser medido en . Pero la afirmación es que el estado cuántico inicial es exactamente con una probabilidad del 100%. Ahora queremos añadir, además de la probabilidad mecanocuántica, una probabilidad clásica, por ejemplo:
El estado cuántico inicial se prepara en con una probabilidad clásica del 25%, y se prepara en con una probabilidad clásica del 75% (observa las diferentes fases relativas).
A veces esto puede deberse a probabilidades clásicas explícitas en la preparación; otras veces puede deberse al entrelazamiento con partes del entorno que ignoramos. De cualquier manera, es evidente la necesidad de una herramienta para describir esta distribución clásica de estados mecanocuánticos. Los estados puros por sí solos no pueden representar estas posibilidades. Por lo tanto, introducimos la matriz de densidad.
Un estado mixto se describe mediante un operador de densidad:
Aquí, es un estado cuántico (no necesariamente un autoestado de ningún operador en particular) y es la probabilidad clásica de que el sistema esté preparado en el estado . Esta es una buena receta para construir una matriz de densidad a partir de una distribución clásica conocida de estados cuánticos. Por otro lado, podríamos querer saber, dadas tanto una distribución clásica de estados cuánticos como una probabilidad mecanocuántica de diferentes resultados de medición, cuál es la probabilidad de que una medición arroje un estado particular (como , o , u otros estados cuando hay más qubits involucrados). Ahí es donde la matriz de densidad resulta especialmente útil. También podemos escribirla en una base como:
Aquí los elementos diagonales son probabilidades:
-
= probabilidad de que el qubit esté en
-
= probabilidad de que el qubit esté en
Son reales, no negativos y suman 1.
Los elementos fuera de la diagonal son coherencias: relaciones de fase o capacidad de interferencia, y generalmente corresponden a cuánta información mecanocuántica hay en el estado. Esta es una afirmación informal, pero veamos qué significa en la práctica.
Ejemplo
Considera el estado puro . (a) ¿Qué sabes sobre las probabilidades de medición y la información de fase sin hacer ningún cálculo? (b) Construye la matriz de densidad y verifica tu intuición.
Solution:
(a) Debido a que es un estado puro, solo hay una fase posible entre y : +1. Esta es información de fase perfecta, por lo que esperamos que los elementos fuera de la diagonal de nuestra matriz de densidad sean grandes. Podrías tener más intuición que esa sobre los elementos fuera de la diagonal, pero eso es suficiente por ahora. Además, las amplitudes de los dos estados base son iguales, por lo que esperamos una probabilidad del 50% de medir o . Así que esperamos que las entradas diagonales sean 1/2. (b) Usando la definición anterior:
solo para el estado . Así que podemos escribir
Las entradas diagonales son cada una , como se esperaba, y los elementos fuera de la diagonal son grandes (suman uno).
Ahora veamos qué sucede cuando no tenemos buena información de fase.
Ejemplo
Considera un caso similar, pero ahora con una probabilidad clásica del 50% de estar en el estado y una probabilidad clásica del 50% de estar en el estado . Las mismas dos preguntas: (a) ¿Qué sabes sobre las probabilidades de medición y la información de fase sin hacer ningún cálculo? (b) Construye la matriz de densidad y verifica tu intuición.
Solution:
(a) Como antes, las amplitudes de los dos estados base son iguales, por lo que esperamos una probabilidad del 50% de medir o . Así que esperamos que las entradas diagonales sean 1/2. Pero esta vez hay dos posibilidades opuestas para la fase entre y : +1 y -1, y cada una es igualmente probable. Se podría esperar que, con dos fases opuestas igualmente probables, se tenga poca o ninguna información de fase. Se podría esperar que las entradas fuera de la diagonal sean pequeñas. (b) Usando nuevamente la definición anterior
solo para los dos estados y . Así que podemos escribir
Las entradas fuera de la diagonal son pequeñas, cero de hecho, como se esperaba. Los elementos diagonales siguen siendo 50% cada uno, lo cual tiene sentido porque cada uno de los estados de la mezcla tenía y igualmente ponderados.
Esta construcción se vuelve más interesante a medida que aumenta el número de qubits. Explora esto en las preguntas a continuación.
Comprueba tu comprensión
Escribe la matriz de densidad para el estado de Bell puro .
Respuesta
solo para el estado . Así que podemos escribir
Escribe la matriz de densidad para una probabilidad clásica del 25% de y una probabilidad clásica del 75% de .
Respuesta
solo para los dos estados y . Así que podemos escribir
Modifica tu trabajo de la pregunta anterior para escribir la matriz de densidad para una probabilidad clásica del 50% de y una probabilidad clásica del 50% de . Predice qué información de fase debería persistir.
Respuesta
solo para los dos estados y . Así que podemos escribir
Los términos diagonales suman 1, como deben. Los términos fuera de la diagonal no se cancelan aquí como sí lo hicieron en un ejemplo anterior de un solo qubit. Puedes ver por qué, en las matemáticas, pero una explicación abreviada es que ahora hay más estados en nuestro espacio de Hilbert. Aunque el primer estado de Bell tenía una fase relativa positiva y el segundo una negativa, estas fases estaban entre estados base diferentes. El primer estado de Bell tenía una fase entre y , mientras que el segundo tenía una fase relativa entre y .
Canales cuánticos
Un canal cuántico es la transformación físicamente permitida más general de un estado cuántico. Lleva una matriz de densidad inicial a otra matriz de densidad:
Aquí significa un canal cuántico actuando sobre una matriz de densidad , que no debe confundirse con los estados de Bell o .
Los canales cuánticos son extremadamente generales. Pueden incluir:
-
Evolución unitaria
-
Mezclas probabilísticas de unitarias
-
Measurements
-
Decoherence
-
Amortiguamiento de amplitud (pérdida de energía)
-
Desfase (pérdida de información de fase)
-
Interacción con un entorno Y muchas otras cosas.
Una forma de pensar en los canales cuánticos es que son a las matrices de densidad lo que las unitarias son a los estados puros. Pero la generalidad de las matrices de densidad permite que los canales cuánticos correspondientes sean mucho más generales y, por lo tanto, más potentes.
Las únicas restricciones sobre un canal cuántico son que debe ser:
- Lineal Las mezclas de estados deben evolucionar de forma consistente:
- Completamente positivo No debe producir probabilidades negativas, incluso si tu sistema está entrelazado con algo más.
- Que preserve la traza Las probabilidades deben sumar 1. Estas propiedades a veces se agrupan en el acrónimo CPTP: mapas Completamente Positivos que Preservan la Traza (Completely Positive Trace-Preserving).
Existen diferentes representaciones de los canales cuánticos, incluidas las representaciones de Stinespring, Kraus y Choi. Estas se tratan en detalle en esta lección sobre canales cuánticos en General formulation of quantum information, y allí también se muestra que son equivalentes. No entraremos aquí en estas diferentes representaciones. Basta decir que son análogas a describir vectores usando tres sistemas de coordenadas diferentes. Cada una podría enfatizar aspectos distintos y desarrollar la intuición de una manera diferente; pero todas te dan la respuesta correcta. Las representaciones de Kraus son convenientes para nuestros propósitos. Ofrecen una forma práctica y formulaica de expresar la acción de un canal mediante multiplicación y suma de matrices. En particular, una representación de Kraus es la especificación de un canal, , en la siguiente forma.
Aquí, son matrices que tienen todas las mismas dimensiones: sus columnas corresponden a los estados clásicos del sistema de entrada, , y sus filas corresponden a los estados clásicos del sistema de salida, ya sea o algún otro sistema . Para que sea un canal válido, estas matrices deben satisfacer la siguiente condición.
Estas matrices se llaman matrices de Kraus. Esta formulación es aplicable no solo a los canales de ruido, sino a procesos y canales cuánticos generales, incluyendo la medición. Veamos un ejemplo de cómo estas pueden usarse para construir canales en el contexto del ruido y los errores.
Canal completamente desfasante
Considera un canal que destruye toda la información de fase y llámalo el canal completamente desfasante. Esto significa que el canal debe tomar cualquier matriz de densidad de la forma
y mapearla a
Si suponemos que la matriz de densidad ya se ha escrito en la base computacional, podemos expresar como . Esto sugiere un conjunto de matrices de Kraus que pueden lograr esta acción de canal: . Apliquemos esta estrategia a un caso de ejemplo de un solo qubit, y veamos si funciona como requerimos:
Sea y .
Debido a que es un número, simplemente podemos mover el vector más allá de él. Esto también se aplica al segundo término. Tenemos:
Ten en cuenta que estas matrices satisfacen la condición requerida:
Vale la pena señalar que esta elección de matrices de Kraus no es única.
Caracterización del ruido como canales
En esta sección usaremos el modelo de la esfera de Bloch y las matemáticas de los canales cuánticos para comprender mejor varios tipos de ruido y errores.
Errores incoherentes
Volvamos a los errores incoherentes y exploremos específicamente los errores de relajación de energía. Recuerda que el estado es el estado fundamental de un qubit y el estado tiene una energía ligeramente mayor. A veces, los estados cuánticos simplemente decaen espontáneamente de un nivel de energía superior a uno inferior. El proceso de emisión espontánea es un tema rico y no puede entenderse verdaderamente sin un tratamiento de teoría cuántica de campos. Pero la intuición nos resulta muy familiar a todos: las perturbaciones aleatorias pueden hacer que una roca ruede cuesta abajo por una colina; no harán que una roca ruede cuesta arriba. Cuánto tiempo permanece un qubit en el estado de mayor energía se caracteriza por un tiempo . Más concretamente, la probabilidad de que un qubit preparado en el estado permanezca en ese estado después de un tiempo es . O, de manera equivalente, la probabilidad de un error de relajación de energía después de un tiempo es
Para describir esto con un canal cuántico en la representación de Kraus, necesitamos matrices de Kraus que correspondan a
- dejar los estados sin cambios
- cambiar los estados a con cierta probabilidad p.
Definamos
Primero, comprobemos que esto tiene los efectos deseados sobre una matriz de densidad. Consideremos un sistema que se encuentra en un estado puro . Vimos en un ejemplo anterior que la matriz de densidad para este caso es
Al aplicar el canal de relajación de energía utilizando matrices de Kraus, obtenemos la nueva matriz de densidad transformada:
Examinemos esto y comparémoslo con nuestra intuición:
Primero, comprobemos el límite cuando tiende a cero. Recuperamos nuestra matriz de densidad inicial, como debe ser:
A medida que pasa el tiempo, esperaríamos que la probabilidad de medir el estado aumente y la probabilidad de medir disminuya. Esto es, de nuevo, exactamente lo que observamos, ya que
También podemos ver trivialmente que las probabilidades de medir y suman 1, como debe ser.
El escalado preciso de los términos de coherencia (fuera de la diagonal) está fuera del alcance de este tratamiento. Pero lo que está claro es que inicialmente tenemos información de fase perfecta, y después de un tiempo muy largo no puede haber información de fase, ya que el sistema se relaja por completo al estado . Por lo tanto, los términos de coherencia deben decaer a cero después de tiempos muy largos. En efecto,
Muchas de las restricciones sobre nuestras matrices de Kraus se comprueban implícitamente mediante estas consideraciones intuitivas. Se debería comprobar rigurosamente que se satisfacen las restricciones sobre los canales (y sobre las matrices de Kraus en concreto), pero dejamos eso como ejercicio para el lector.
Gráficamente, este tipo de canal puede representarse mediante una esfera de Bloch. Un estado puro se encuentra en la superficie de una esfera de Bloch. Los estados mixtos se desplazan hacia el interior de la esfera y se extienden alejándose de un único punto. La inclusión de probabilidades clásicas se aprecia mediante la reducción de la distancia absoluta desde el origen hasta cualquiera de los estados de la mezcla, y la expansión desde un único punto hacia una región indica la mezcla de múltiples estados posibles. En el caso especial de un canal de relajación de energía, el estado mixto (matriz de densidad) después de un tiempo no despreciable se vería como en la imagen siguiente: una región en el interior de la esfera de Bloch, desplazada hacia arriba en dirección al polo , y contraída tanto a lo largo del eje como a lo largo del plano , aunque en menor medida que a lo largo de .

Ten en cuenta que la región no es un "casquete" de la esfera de Bloch, tal como a veces parece en una representación en perspectiva. Como se puede ver claramente en el video, se trata de un esferoide achatado, contraído y desplazado hacia el estado . Los canales de ruido (y los canales en general) son, por supuesto, aplicables a sistemas de cualquier tamaño. Pero representarlos visualmente (como con una esfera de Bloch) se vuelve difícil a medida que aumenta el número de estados mutuamente ortogonales en el espacio de Hilbert.
Comprueba tu comprensión
Verifica que las matrices de Kraus utilizadas en el canal de relajación de energía anterior satisfacen la condición de identidad:
Respuesta
Presentaremos dos tipos más de canales de ruido incoherente, pero dejaremos la mayor parte de la interpretación y verificación como ejercicios. El siguiente es el canal de desfase, que describe una pérdida de información de fase, pero con la preservación de las amplitudes. Aunque todavía puede haber probabilidades tanto clásicas como cuántico-mecánicas involucradas en la probabilidad de medición general, la pérdida de información de fase a menudo se describe como una pérdida de información cuántica, o como que el sistema se vuelve más clásico.
De manera muy similar a como la relajación de energía se describió con un tiempo característico , los errores de desfase se describen mediante un segundo parámetro temporal . La probabilidad de un error de desfase después de un tiempo viene dada por
Un conjunto de matrices de Kraus para el canal de desfase en un único qubit, en términos de esta probabilidad, es el siguiente:
El resultado de este canal de desfase se visualiza mediante una esfera de Bloch en la figura siguiente.

Ten en cuenta que las amplitudes no cambian, por lo que cualquier estado que caiga exactamente en un polo ( o ) no se ve afectado y sigue mapeándose a la superficie de la esfera en la región sombreada. Pero se pierde la información de fase, lo que corresponde a una reducción de la región sombreada a través del plano . Una forma de entender esto es: cualquier estado cuántico posible puede seguir teniendo una fase bien definida, pero dado que existe una probabilidad clásica de encontrar varios estados con diferentes fases bien definidas, la probabilidad total de cualquier fase bien definida se reduce.
Comprueba tu comprensión
Verifica que las matrices de Kraus definidas anteriormente para el canal de desfase satisfacen la condición de identidad:
Respuesta
Comienza con un estado puro de un único qubit de tu elección, con una fase bien definida entre y . Escríbelo como una matriz de densidad. Aplica el canal de desfase utilizando los operadores de Kraus sugeridos anteriormente. Interpreta la matriz de densidad transformada resultante.
Respuesta
Elijamos el estado . La matriz de densidad correspondiente es
Ahora aplicamos el canal de desfase a esta matriz de densidad utilizando los operadores de Kraus.
En primer lugar, observamos que la suma de la diagonal es efectivamente igual a uno, como debe ser. En segundo lugar, observa que los elementos fuera de la diagonal eran inicialmente grandes, con una suma de 24/25, lo que indica una coherencia fuerte. Ten en cuenta que a medida que aumenta la probabilidad de un error de desfase , estos elementos fuera de la diagonal disminuyen. Esto también coincide con nuestra expectativa. Una sutileza: observa qué sucede cuando . ¡La coherencia vuelve a ser fuerte! Esto parece contraintuitivo al principio, porque una alta probabilidad de un error de desfase debería estropear nuestra fase, ¿verdad? El truco está en que, si estamos 100% seguros de que ocurre un error de fase, entonces volvemos a tener información sólida sobre la fase; la fase simplemente se ha invertido. Con esta idea, podríamos esperar que la peor información de fase corresponda a una probabilidad del 50-50 de que ocurra un error de fase, y eso es exactamente lo que encontramos.
Nuestro último ejemplo de un canal de ruido que describe errores incoherentes es el canal de ruido de Pauli. Este canal describe la aparición de tres tipos de errores con probabilidades independientes:
- Error de inversión de bit (error X) con probabilidad
- Error de inversión de fase (error Z) con probabilidad
- Combinación de X y Z (error Y) con probabilidad Aquí, para todo . Un corolario es que la probabilidad de que no ocurra ningún error es .
Los operadores de Kraus para este canal son:
En el caso del canal de ruido de Pauli, resulta instructivo escribir explícitamente el propio canal:
A partir de esta forma vemos que el canal de ruido de Pauli implementa uno o más errores correspondientes a la acción de las matrices de Pauli , cada una con probabilidad .
Distintas combinaciones de probabilidades de inversión producirán distintas visualizaciones. Aquí visualizamos el caso especial en que , también llamado canal despolarizante.

Modelado de errores coherentes
Los canales cuánticos pueden representar tanto errores coherentes como incoherentes, pero en la práctica se utilizan principalmente para errores incoherentes, porque los errores coherentes se modelan mejor como desajustes de calibración unitarios o se convierten en canales estocásticos para facilitar el análisis. En esta sección presentaremos enfoques más aplicables a los errores coherentes.
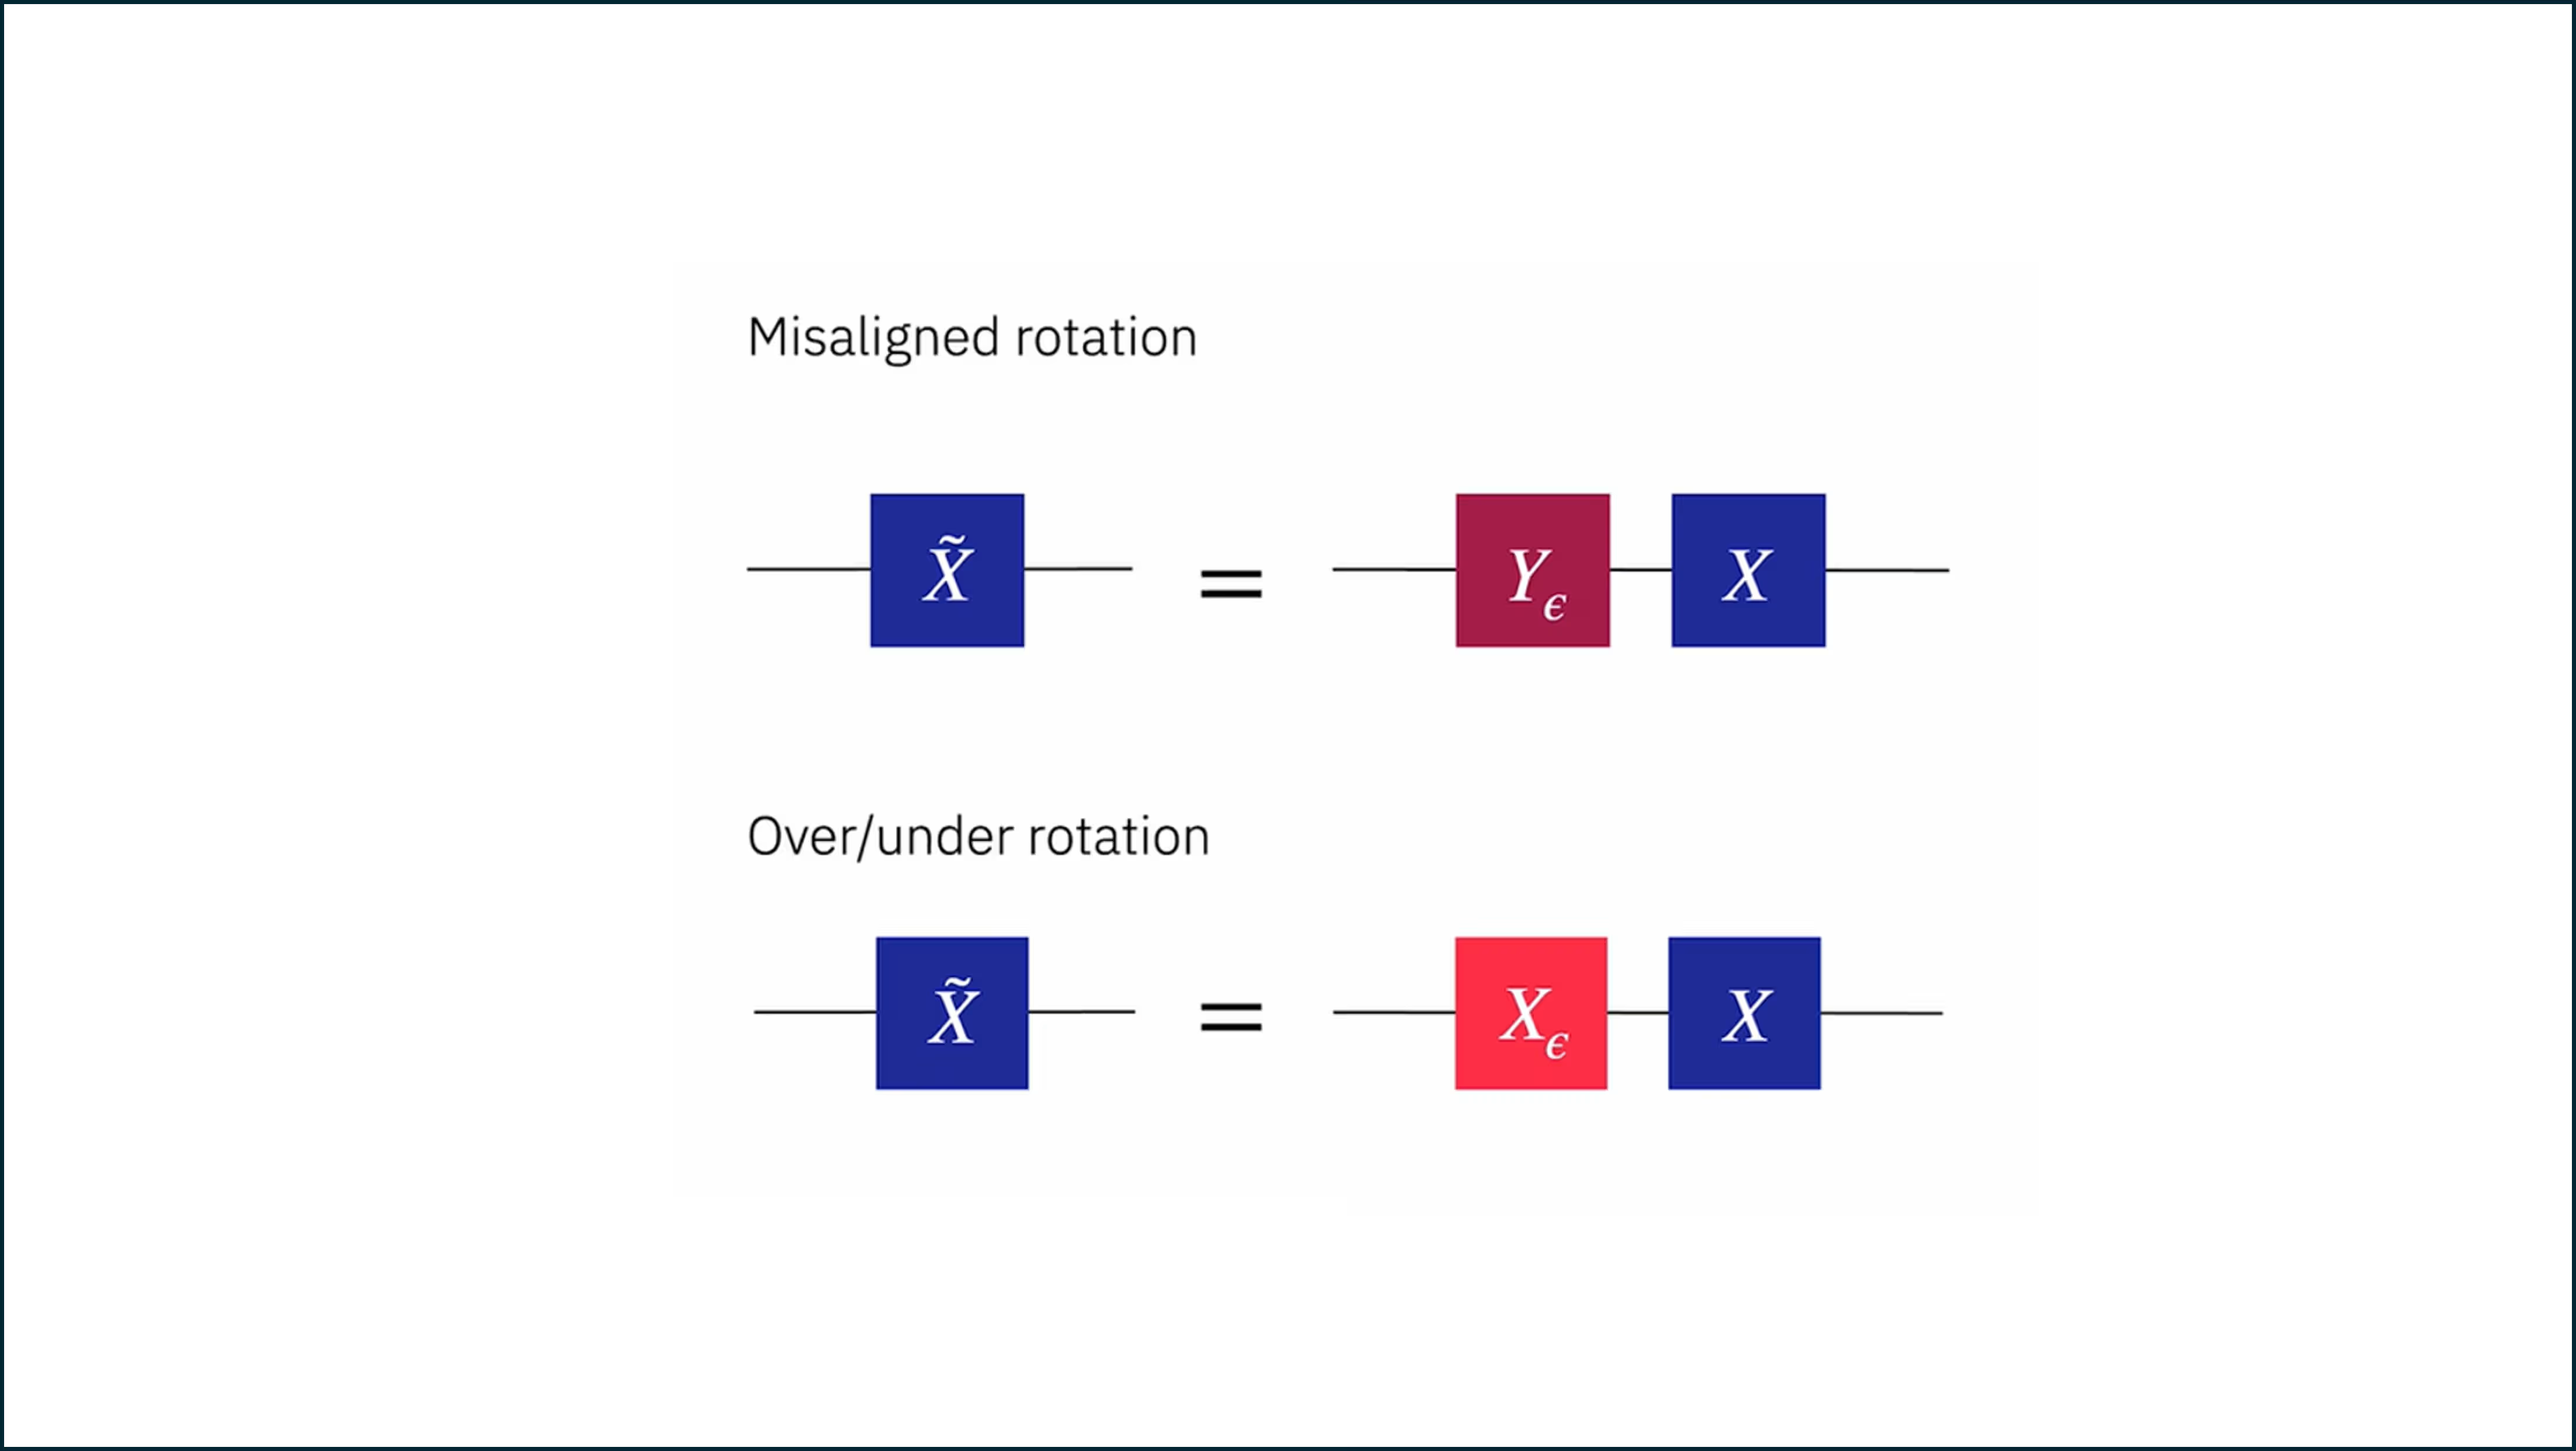
Los errores coherentes pueden modelarse mediante puertas unitarias no deseadas. Algunos ejemplos sencillos incluyen rotaciones mal alineadas o subrotación/sobrerrotación. En la imagen siguiente, mostramos una rotación mal alineada como una rotación adicional de una pequeña cantidad , además de la rotación deseada alrededor del eje . Una sobrerrotación se describe mediante la rotación deseada junto con alguna rotación adicional alrededor del mismo eje .
Errores de dos qubits y conos de luz sombreados
Una puerta de un qubit hace rotar un qubit aislado. Una puerta de dos qubits implementa lógica que depende de dos qubits, pero no puede realizar una medición directa de ninguno de los dos; por tanto, debe activar una interacción entre los qubits. Esta interacción es la razón por la que podemos generar entrelazamiento, y también es de donde proviene gran parte del ruido, la diafonía y la dificultad de calibración. Esta interacción entre qubits también permite que los errores se propaguen. Si un qubit tiene algún error, y sirve como qubit de control para otro qubit objetivo, el error puede transferirse al objetivo. En esta lección repasaremos lo que implican las puertas de dos qubits para las tasas de error y su propagación dentro de un circuito.
Puertas de resonancia cruzada con eco
Diferentes arquitecturas de hardware y familias de puertas diseñan esa interacción de maneras distintas. Las computadoras cuánticas de IBM implementan puertas abstractas de dos qubits como CZ o CX utilizando puertas de resonancia cruzada con eco (ECR) nativas del hardware. Las puertas ECR generan una interacción efectiva mediante un impulso de microondas. Puertas relacionadas como CNOT se construyen a partir de añadiendo rotaciones de un qubit.
Distintos qubits tienen distintas frecuencias de resonancia (frecuencias a las que reaccionan fuertemente). Una operación estándar podría usar esa frecuencia de resonancia para inducir una transición en un qubit. Pero ¿qué sucede si impulsas el qubit C a la frecuencia de resonancia de un qubit adyacente T? Los qubits adyacentes están vinculados por una interacción fija, capacitiva o mediada por resonador. Debido a este acoplamiento, un impulso sobre el qubit C “se filtra” hacia el hamiltoniano del qubit T. La intensidad y la dirección de este impulso efectivo dependen del estado del qubit C ( o ). Aquí, el qubit C es el control y el qubit T es el objetivo.
El resultado es una rotación efectiva del qubit objetivo condicionada al estado del qubit de control. Matemáticamente:
Esta interacción ZX es exactamente lo que se necesita para construir una CNOT. Pero los otros términos podrían incluir algunos errores, y es casi seguro que incluyen acoplamiento capacitivo entre los qubits C y T, lo cual corresponde a un término ZZ.
Podemos pensar en estos términos adicionales de la siguiente manera:
-
IX = el objetivo recibe un impulso no intencionado
-
ZI = el qubit de control adquiere una rotación Z no deseada
-
IZ = el qubit objetivo adquiere una rotación Z no deseada
-
ZZ = desplazamiento de fase estático dependiente del estado
-
otros = pequeñas interacciones XY, XX, de orden superior
Una puerta ECR es simplemente una rotación controlada más un pulso de eco cuidadosamente elegido sobre el qubit de control. El eco invierte el signo de muchos términos no deseados mientras preserva la interacción ZX. Este proceso cancela bastante bien los errores IX y ZI, y a veces algunos términos de orden superior. Pero el eco no puede cancelar el acoplamiento ZZ estático porque conmuta con el pulso de eco. Hay otras interacciones que no se cancelan en este proceso: algunas no linealidades residuales y efectos de qubits espectadores, fugas y contaminación de impulso de largo alcance, además de algunas otras — pero el término ZZ es especialmente importante.
Este proceso a menudo requiere tiempos de impulso que son un orden de magnitud más largos que los de las puertas de un qubit. La combinación de tiempos de impulso más largos, términos ZZ persistentes en el hamiltoniano e imperfecciones en el acoplamiento hacen que las puertas de dos qubits sean la fuente dominante de errores de puerta. Ten en cuenta también que si se necesitan interacciones en un circuito entre qubits que no son adyacentes, las puertas SWAP necesarias también son, obviamente, puertas de dos qubits. Por eso la métrica estándar relacionada con la profundidad es: profundidad transpilada de dos qubits. Nos preocupamos principalmente por las puertas de dos qubits porque dominan el error de puerta, y necesitamos observar los circuitos transpilados porque la transpilación a menudo introduce muchas puertas adicionales de dos qubits en forma de puertas SWAP.
Comprueba tu comprensión
Explica por qué nos preocupamos principalmente por la profundidad transpilada de dos qubits. Asegúrate de considerar las restricciones del hardware y el hecho de que la profundidad de las puertas de un qubit podría ser mucho mayor.
Respuesta
Las puertas de dos qubits tienen tasas de error mucho más altas que las puertas de un qubit. Las puertas de un qubit no son perfectas, por lo que puede haber casos en los que también sea útil considerar la profundidad de un qubit. Pero la profundidad de puertas de dos qubits tiende a dominar el comportamiento de error de un circuito. Debemos considerar el circuito transpilado. Las computadoras cuánticas modernas no tienen conectividad total entre todos los qubits. Las computadoras cuánticas de IBM utilizan una red cuadrada o una red "heavy hex", lo que significa que los qubits tienen 2, 3 o 4 vecinos más cercanos a los que pueden acoplarse directamente mediante una única puerta de dos qubits. Cualquier entrelazamiento con otros qubits no adyacentes requiere mover información por la computadora cuántica utilizando puertas SWAP de dos qubits. Por lo tanto, la transpilación tiende a aumentar la profundidad de puertas de dos qubits. Para circuitos altamente entrelazados, este aumento podría ser muy grande.
Conos de luz sombreados
Supongamos que un único qubit está bien aislado de todos los demás. Un error en ese qubit no causará ningún error en ningún otro qubit. Pero cuando un qubit interactúa con otro, los errores pueden propagarse. La forma en que se propagan los errores depende de la forma en que interactúan los qubits. Considera el circuito siguiente. Supongamos que cualquier par de qubits adyacentes en el diagrama del circuito también son adyacentes en el chip cuántico (es decir, no será necesario intercambiar información con otros qubits para facilitar las interacciones descritas).
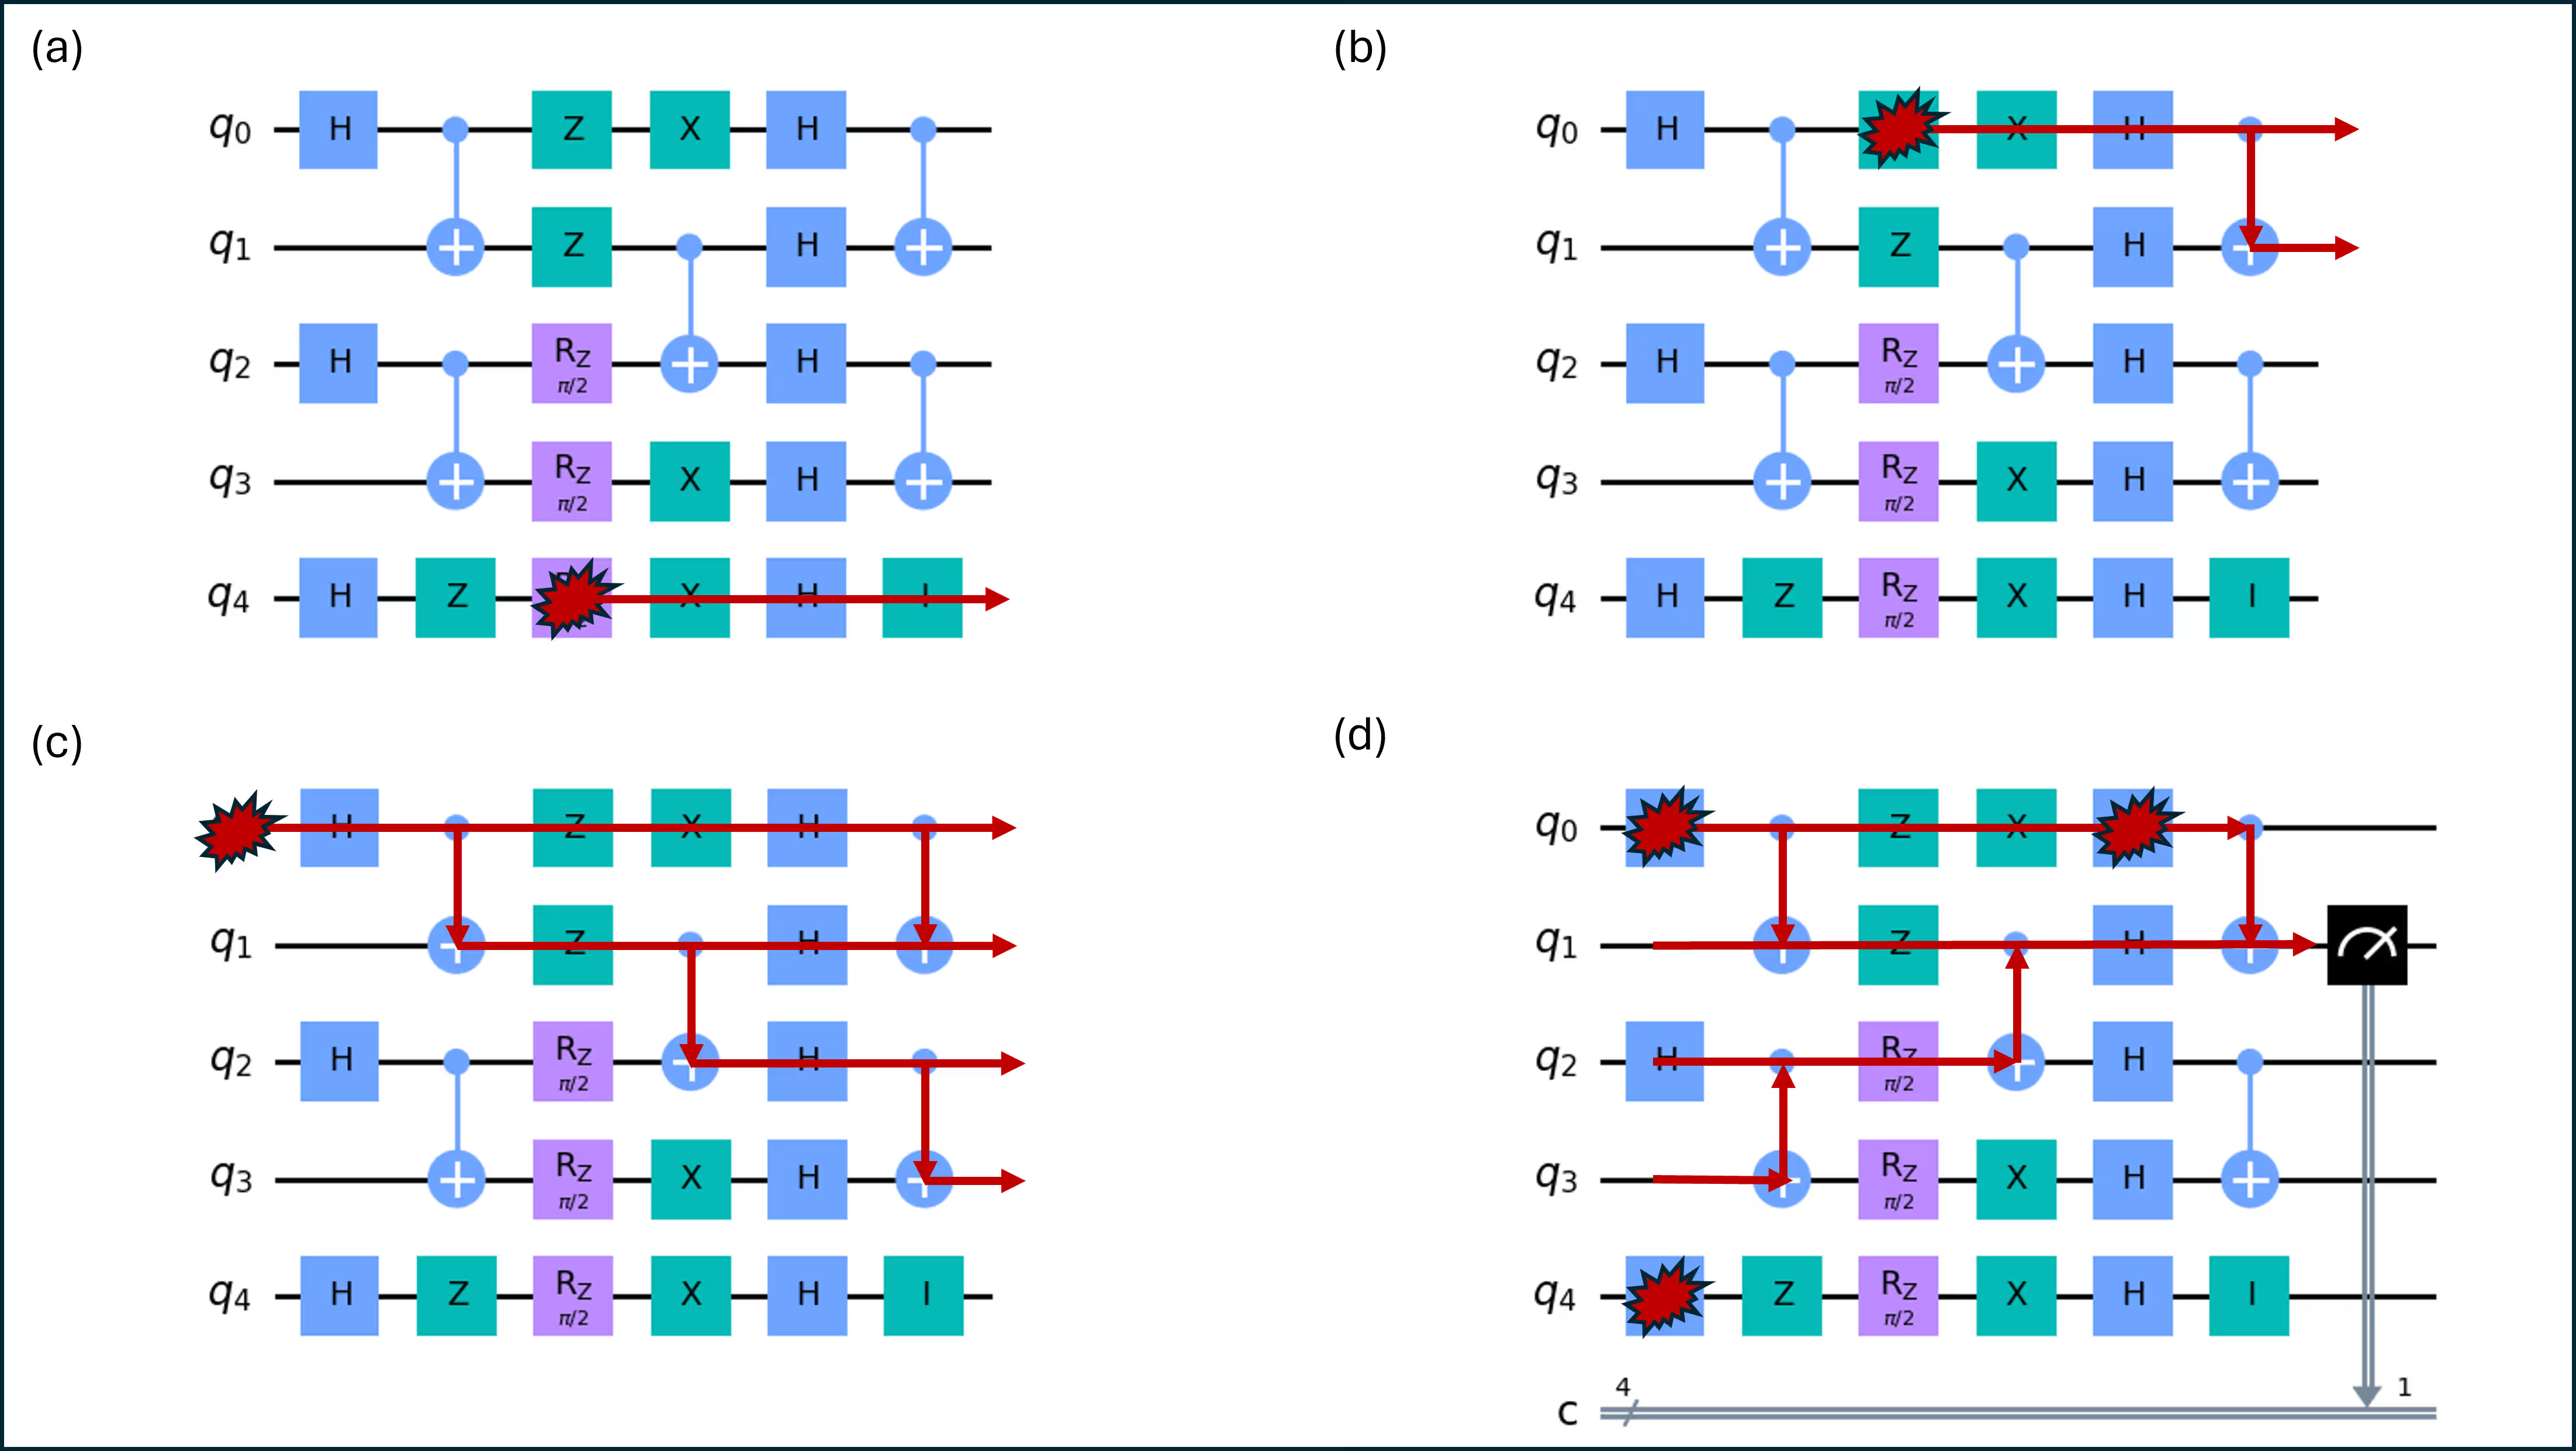
Aunque quizás no lo hayas pensado de esta manera, esto es una especie de diagrama de espacio-tiempo. El eje vertical en un circuito cuántico representa diferentes qubits dispuestos en el espacio. El eje horizontal representa el tiempo a lo largo del cual se aplica una secuencia de puertas. Tomando prestado el lenguaje de la relatividad, un cono de luz representa la región del espacio-tiempo que es alcanzable desde un punto mediante interacciones causales.
En la figura anterior, no se ha especificado el tipo de error. Resulta que el tipo de error afecta al cono de luz, ya que algunos errores afectan a la lógica de una puerta de dos qubits y otros no. Volveremos a esto en breve. Por ahora, considera que las líneas amarillas son caminos de propagación potencial de algún tipo de error. Observa, por ejemplo, en la parte (a) de la figura, que un error de un qubit en la puerta RZ del qubit 4 solo puede propagarse hacia adelante en el tiempo en ese único qubit. No puede propagarse a otros qubits porque el qubit 4 no está entrelazado con ningún otro qubit. Este es un buen momento para señalar que el qubit 4 es bastante inútil en este circuito, y de hecho todo el circuito está construido solo con fines pedagógicos.
Sin embargo, un error en la puerta Z del qubit 0 (no necesariamente un error Z, solo algún error en esa ubicación) podría propagarse a otro qubit: el qubit 1, a través de la CNOT final que utiliza el qubit 0 como control y el qubit 1 como objetivo. Esto se muestra en la parte (b). Como cabría esperar, un error más temprano en el circuito a menudo tendrá la posibilidad de propagarse a través de más qubits. La parte (c) muestra que un error en la preparación del estado inicial del qubit 0 puede propagarse a todos los qubits excepto al qubit 4, que está aislado.
Esta configuración muestra cómo un error puede propagarse hacia adelante en el tiempo y afectar a las mediciones. Pero también puedes examinar la pregunta inversa: para una medición específica de un qubit, ¿qué partes de mi circuito podrían haber contribuido con algún error a ella? En ese caso, simplemente comenzarías con la medición u otro punto de interés y retrocederías (en el tiempo) a través del circuito, siguiendo cualquier circuito de entrelazamiento, como se muestra en la parte (d). También se muestran algunos puntos elegidos aleatoriamente en los que podrían ocurrir errores.
En la figura anterior, los errores se propagan entre qubits mediante puertas ECR, pero una discusión similar podría aplicarse a otras puertas de dos qubits. Estas puertas tienen un control y un objetivo. Está claro que un error en el control puede afectar a la lógica de la puerta y, por lo tanto, puede provocar un error en el objetivo. Pero ¿qué pasa en la otra dirección? ¿Puede un error en el objetivo propagarse al qubit de control? Recuerda que el acoplamiento entre control y objetivo en las puertas ECR no es puramente del tipo ZX ideal; también tiene un acoplamiento ZZ no deseado.
Si un error en el objetivo conmuta con el acoplamiento ZZ, entonces no puede propagarse al qubit de control. Podemos ver esto a través de los mecanismos físicos en juego. Una forma rápida de verlo es que si un error conmuta con , entonces su orden puede intercambiarse sin afectar al resultado. Sin embargo, si el hecho de que ocurra justo antes del acoplamiento es equivalente a que actúe después del acoplamiento , entonces no puede afectar al control, ya que en este último caso el error tendría que retroceder en el tiempo. Si un error no conmuta con el acoplamiento ZZ, entonces sí podría propagarse del objetivo de vuelta al control. Por lo tanto, en el caso de una puerta ECR, los errores Z no podrían propagarse del objetivo al control, pero los errores X o Y sí podrían.
Comprueba tu comprensión
En la parte (d) de la figura anterior, observa las líneas verticales entre los qubits 0 y 1. ¿Es correcto que algunos errores podrían propagarse a través de esas líneas? De nuevo, puede depender del tipo de error, y aún no hemos hablado de esto. La pregunta es si existe algún error que pudiera propagarse tal como muestran esas líneas verticales. Explica tu respuesta.
Respuesta
Sí, es correcto. Al trazar el cono de luz hacia atrás desde la medición, podría parecer que estás afirmando que algo se mueve del objetivo al control. Sin embargo, el significado real del diagrama es que un error podría haberse movido del control (qubit 0) al objetivo (qubit 1) para causar un error en el punto de interés. Si tu intuición te dice que depende del tipo de error, tienes toda la razón. Esto se aborda parcialmente en la siguiente sección.
Comenzando con una versión sin errores de los circuitos en el diagrama anterior, traza la posible propagación de un error en la primera puerta de Hadamard que actúa sobre el qubit 2. Enumera todos los qubits que podrían verse afectados al final del circuito si el error es (a) una inversión de fase, y (b) una inversión de bit. Pista: piensa en cómo se está utilizando la información de cada qubit.
Respuesta
(a) El qubit 3 podría verse afectado, además, obviamente, del propio qubit 2. ¡Ningún otro! Si mencionaste los qubits 0 y 1, ten en cuenta que el qubit 2 es el objetivo de la ECR que lo entrelaza con el qubit 1. No se realiza ningún cambio en el qubit 1 en esa puerta. (b) Los qubits 0-3 podrían verse afectados. El error de inversión de bit o de tipo X no conmuta con el acoplamiento ZZ de la puerta ECR y, por lo tanto, puede propagarse del objetivo al control.
Propagación de errores
En la sección anterior hablamos de la propagación de errores sin darle una definición formal. De ahora en adelante:
Para un error que ocurre antes de alguna parte de la carga lógica de un circuito , la propagación de errores consiste en encontrar el operador equivalente que reproduce el mismo resultado defectuoso cuando se aplica después de en lugar de antes.
La imagen de la propagación de errores en la sección anterior sugería que los errores podían propagarse de un qubit de control a un qubit objetivo a través de una puerta CNOT. Una forma de comprobar cuándo esto es cierto es considerar un error en el control o en el objetivo antes del entrelazamiento, y comprobar si ese operador conmuta con la puerta CNOT. Si los dos operadores conmutan, entonces no hay diferencia si se aplican en orden inverso, lo que significa que el error podría simplemente "desplazarse más allá de" la CNOT sin tener ningún efecto sobre otros qubits. Esta es la forma más habitual en que la gente aborda la propagación de errores, y da lugar a las siguientes reglas:
Sea el control el qubit 0 y el objetivo el qubit 1. Considera los errores X y Z en los qubits de control y objetivo (, , y , respectivamente). Al mover estos errores más allá de una , los errores se convierten en:
Presentamos lo anterior sin demostración. Pero si eres como el autor de esta lección y prefieres la representación de Schr"odinger, también puedes escribir estados arbitrarios de control y objetivo, aplicar el error, luego la CNOT, y examinar el estado final. Si comparas ese estado final con un caso sin errores, puedes ver qué combinación de errores aplicada después de la CNOT produciría el estado erróneo, y en particular, puedes ver si la operación de error se ha propagado de un qubit al otro.
| Control inicial | Objetivo inicial | Error | Final | Error equiv. tras CNOT |
|---|---|---|---|---|
| Ninguno | No aplicable | |||
| X en el control | ||||
| Z en el control | ||||
| X en el objetivo | ||||
| Z en el objetivo |
Quizás sorprendentemente, un error Z en el objetivo sí provoca que un error se propague de vuelta al control.
Como puedes imaginar, rastrear esta propagación de operadores de error hacia adelante a través de circuitos (o, de manera equivalente, propagar hacia atrás los operadores que se van a medir) es complicado. Qiskit dispone de herramientas para facilitar esto, sobre las que aprenderemos en la lección 6, dedicada a los flujos de trabajo modernos.
Existe un addon de Qiskit llamado Shaded Lightcones. El addon shaded lightcones (SLC) analiza la propagación de errores en circuitos cuánticos utilizando la propagación de Pauli para identificar qué partes de un circuito pueden influir realmente en un observable objetivo. Está diseñado principalmente para hacer que la mitigación de errores sea más eficiente, especialmente para flujos de trabajo de cancelación probabilística de errores (PEC). Aquí solo exploraremos brevemente esta herramienta, y haremos un uso más amplio de ella en el contexto de las técnicas de mitigación de errores en lecciones futuras. Utiliza la propagación de operadores de Pauli para trazar la propagación de errores de distintos tipos, produciendo un cono de luz para errores de tipo X, Y y Z.
Los conos de luz sombreados (SLC, por sus siglas en inglés) van más allá, utilizando simulaciones clásicas para acotar de forma más estricta la sensibilidad a los errores en todo el circuito. Esto intercambia algo de tiempo de QPU por tiempo de CPU y reduce la sobrecarga de muestreo necesaria para renormalizar el sesgo. En lugar de un corte estricto, a cada error potencial en el circuito se le asigna un «sombreado» graduado que acota superiormente la susceptibilidad del observable a ese error. Esta caracterización refinada permite aplicaciones más eficientes y específicas de PEC con menor varianza, a la vez que le da al usuario la capacidad de ajustar de forma controlada el sesgo en la estimación del observable. Consulta Lightcone shading for classically accelerated quantum error mitigation para más detalles.
No presentaremos aquí un flujo de trabajo completo. Simplemente mostramos de forma esquemática cómo este flujo de trabajo toma un circuito:

El flujo de trabajo separa el circuito en «cajas» útiles para aprender el comportamiento del ruido:

Finalmente, utiliza propagación de operadores y aprendizaje de ruido para producir un mapa sombreado de la susceptibilidad a errores en todo el circuito:
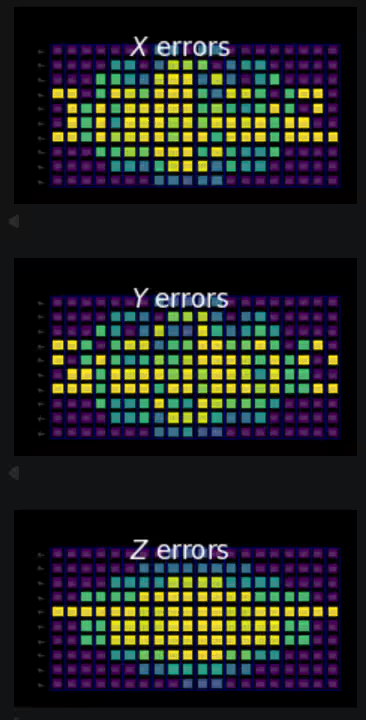
Cada caja de color en la salida corresponde a un qubit específico en un momento específico. Las cajas más oscuras (moradas) indican un qubit y una capa en los que un error no puede propagarse hasta la(s) medición(es) de interés. Las cajas más brillantes (amarillas) corresponden a un qubit y una capa en los que un error puede tener una fuerte influencia en la(s) medición(es) de interés.
Observa las regiones moradas a la derecha de cada mapa. Un error en la misma capa que la medición, pero en un qubit diferente, no puede afectar la medición a través de la conectividad del circuito mostrada. Del mismo modo, un error una capa atrás en el tiempo (una capa a la izquierda) solo puede propagarse al qubit adyacente en el siguiente paso, debido a la estructura de la capa de entrelazamiento, y así sucesivamente. Por lo tanto, la forma cónica a la derecha es general siempre que relativamente pocos qubits estén involucrados en la medición de interés.
Comprueba tu comprensión
¿Crees que es mejor elaborar un mapa de cono de luz sombreado antes o después de la transpilación? ¿Por qué?
Respuesta
Se debe hacer después de la transpilación. Para que estos diferentes mapas sean útiles, debemos asegurarnos de que los qubits adyacentes en nuestro circuito correspondan a qubits adyacentes en nuestro chip cuántico. De lo contrario, las puertas de entrelazamiento que se muestran actuando sobre qubits adyacentes en el diagrama del circuito terminarían requiriendo puertas SWAP y una estructura de circuito más complicada.