Supresión y adaptación de errores
La supresión de errores puede referirse a cualquier técnica que anticipe y trate de evitar ciertos tipos de ruido y errores. Esto es más fácil de explicar mediante ejemplos concretos, pero ten en cuenta que estos métodos no se limitan a los ejemplos mostrados aquí, y continuamente se exploran nuevos métodos. A veces no es posible suprimir los errores, pero sí es posible afectar cómo se acumulan. Si podemos hacer que los errores se acumulen más lentamente, podríamos describir esto como la supresión del error general, pero se ve con más precisión como una adaptación del ruido. En esta lección cubrimos ejemplos canónicos de supresión de errores (desacoplamiento dinámico) y de adaptación/modelado de ruido (Pauli twirling).
Un video que acompaña a esta lección se publicará en los próximos días y se incrustará aquí.
Desacoplamiento dinámico
Comencemos con un estado muy simple en un solo qubit, e introduzcamos un modelo de ruido simple. Esto es insuficiente para explicar completamente el desacoplamiento dinámico, pero nos da un ejemplo claro. Supongamos que tenemos un qubit preparado en un estado de superposición usando una puerta Hadamard:
Este estado se visualiza en la esfera de Bloch como se muestra abajo a la izquierda. En el caso ideal con ruido cero, este qubit permanecería en este estado hasta que se realice la siguiente operación. Sin embargo, sabemos por la lección anterior que esto no es lo que observamos. El ruido hace que la información cuántica se degrade.
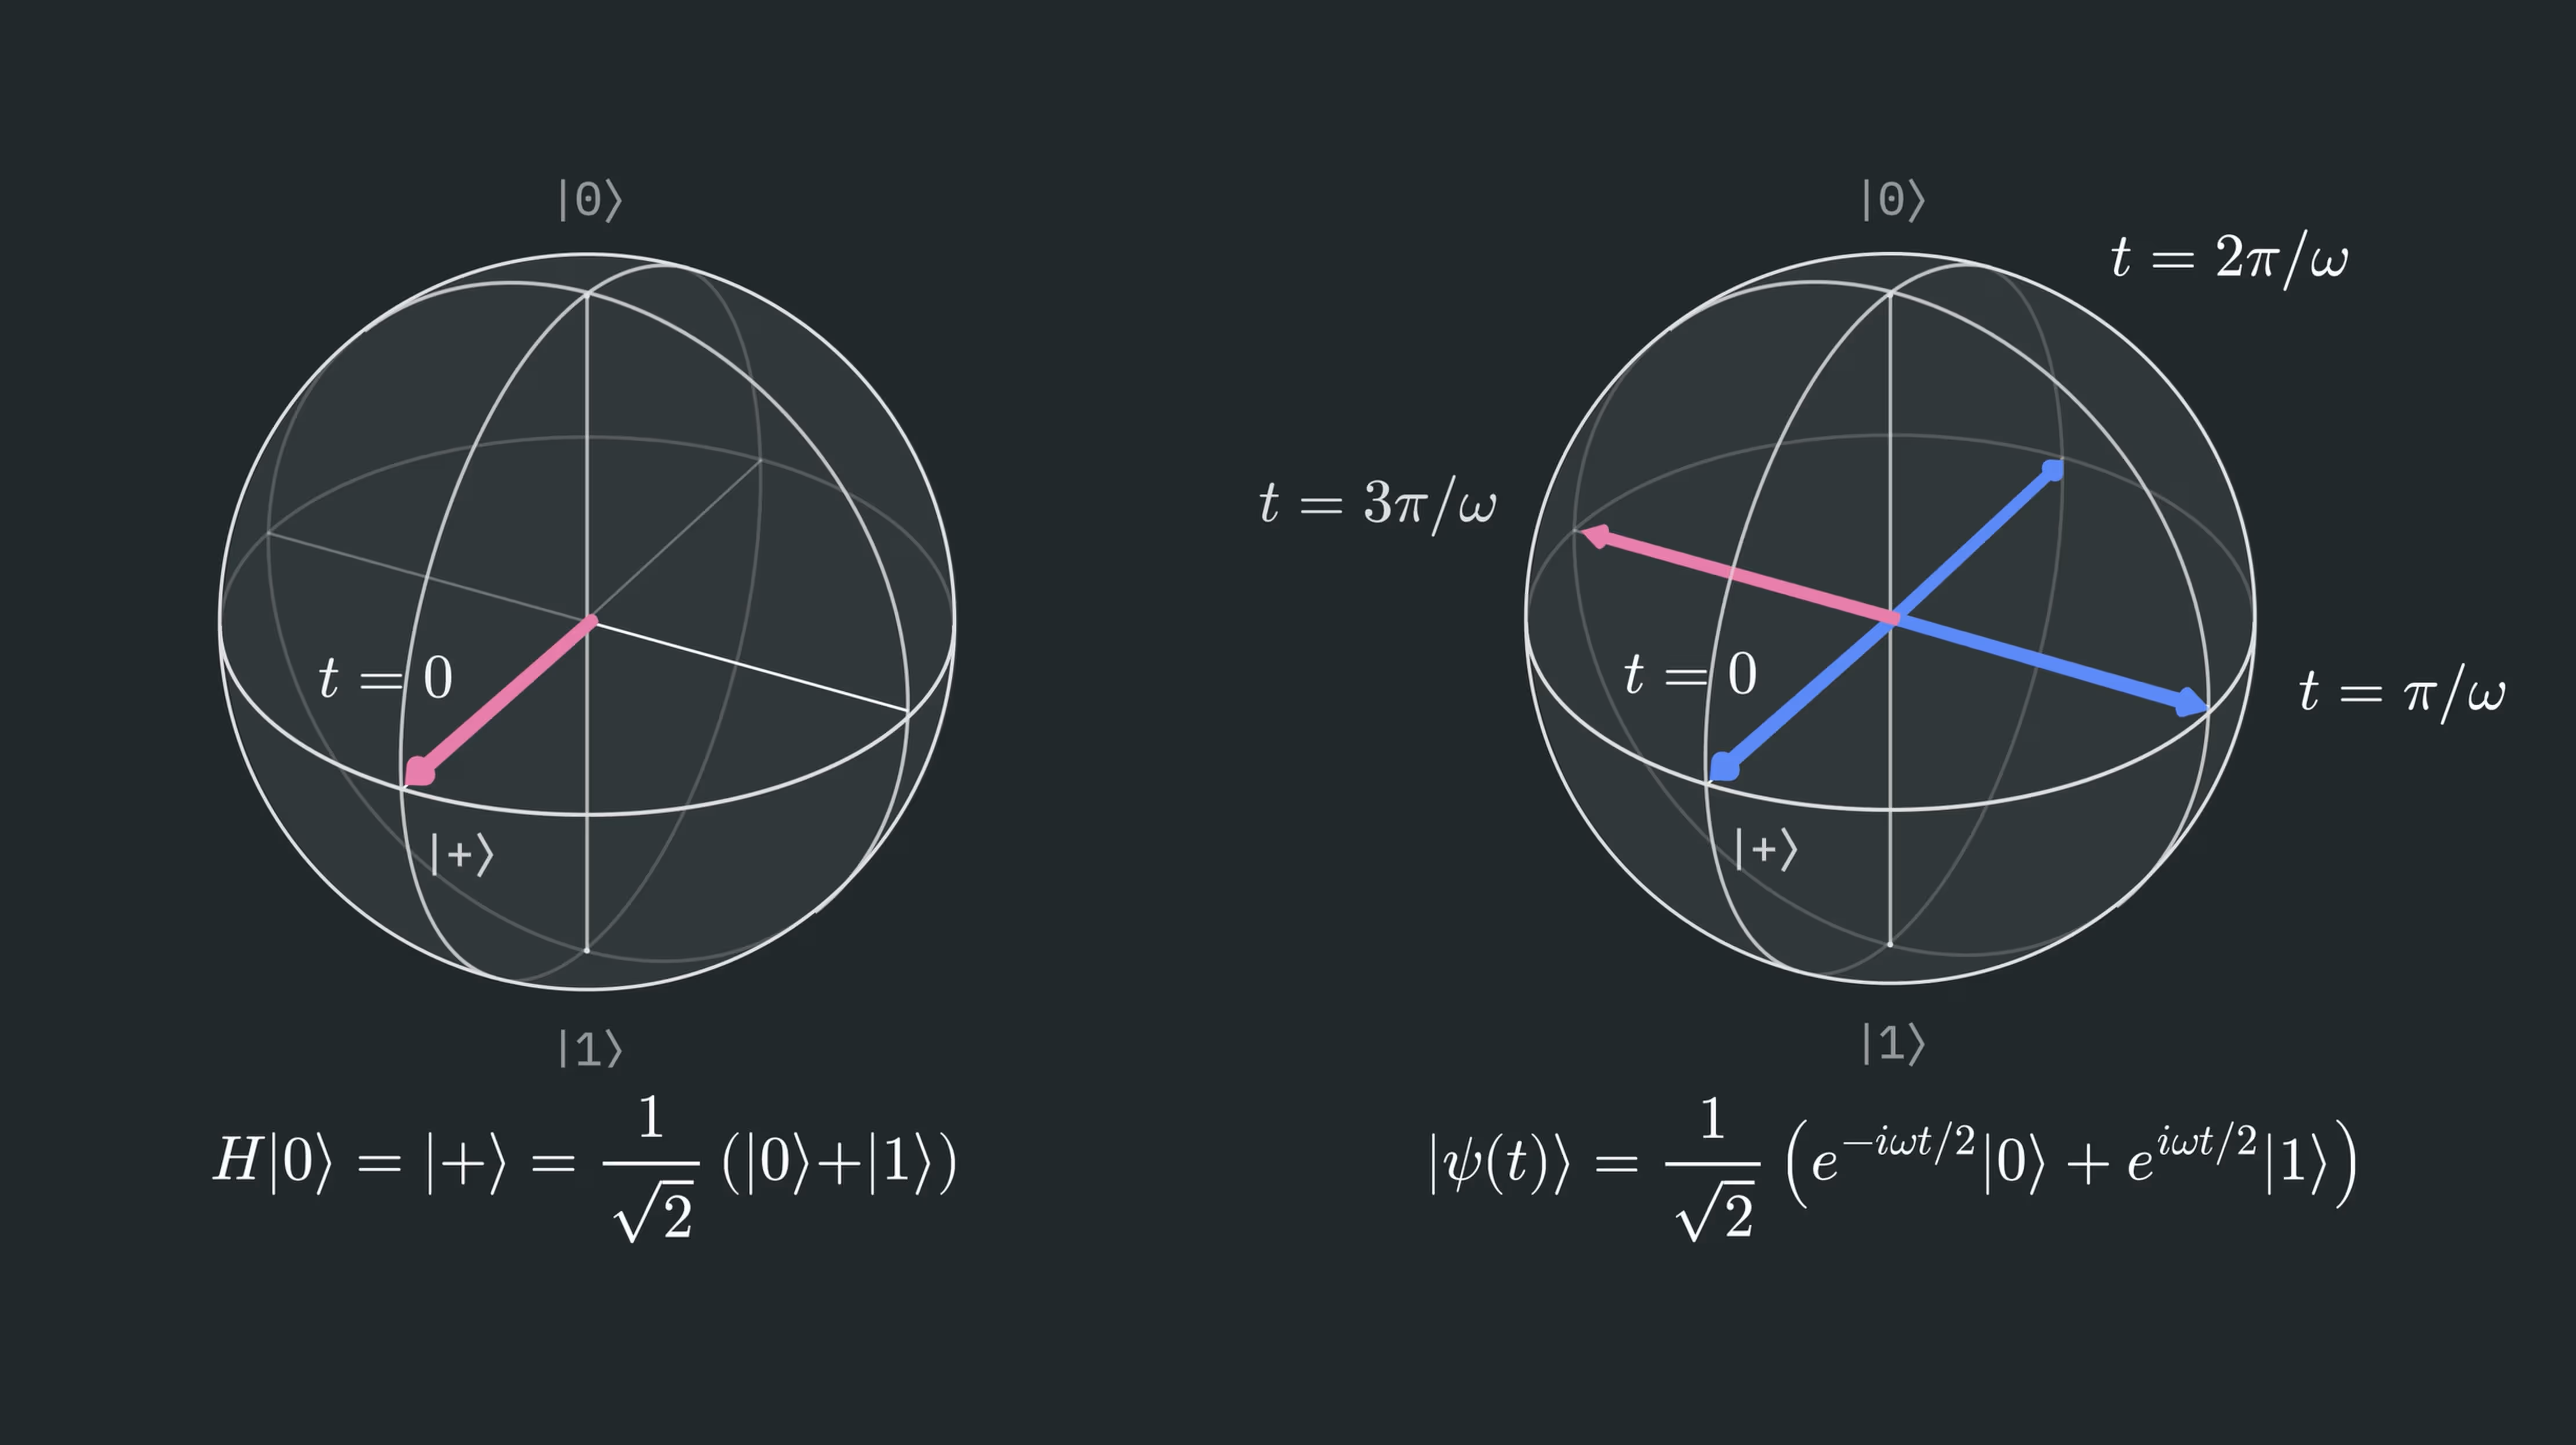
El ruido o el acoplamiento ambiental pueden hacer que la fase relativa entre los estados base cambie. Es decir, las probabilidades de y no cambian, ya que los valores absolutos de sus coeficientes no cambian. Más bien, las fases de las amplitudes cambian, alterando sus componentes real e imaginaria. Para hacer esta discusión más concreta, consideremos un tipo de interacción que puede causar esto: el acoplamiento a un campo magnético orientado en la dirección Z: .
Consideremos qué le sucede al estado a medida que pasa el tiempo:
Aquí hemos usado el hecho de que un campo magnético en la dirección Z causa precesión alrededor del eje Z con una frecuencia que depende del momento magnético efectivo y de la intensidad del campo magnético. Los detalles son menos importantes que el hecho de que esta interacción causa una evolución alrededor del eje Z, lo que resulta en una acumulación de fase opuesta para los dos estados base computacionales. Aplicando este operador a cada término en , encontramos lo siguiente:
Esta fase dependiente del tiempo corresponde a la precesión alrededor del eje Z en la representación de la esfera de Bloch. Esto se muestra en la mitad derecha de la figura anterior.
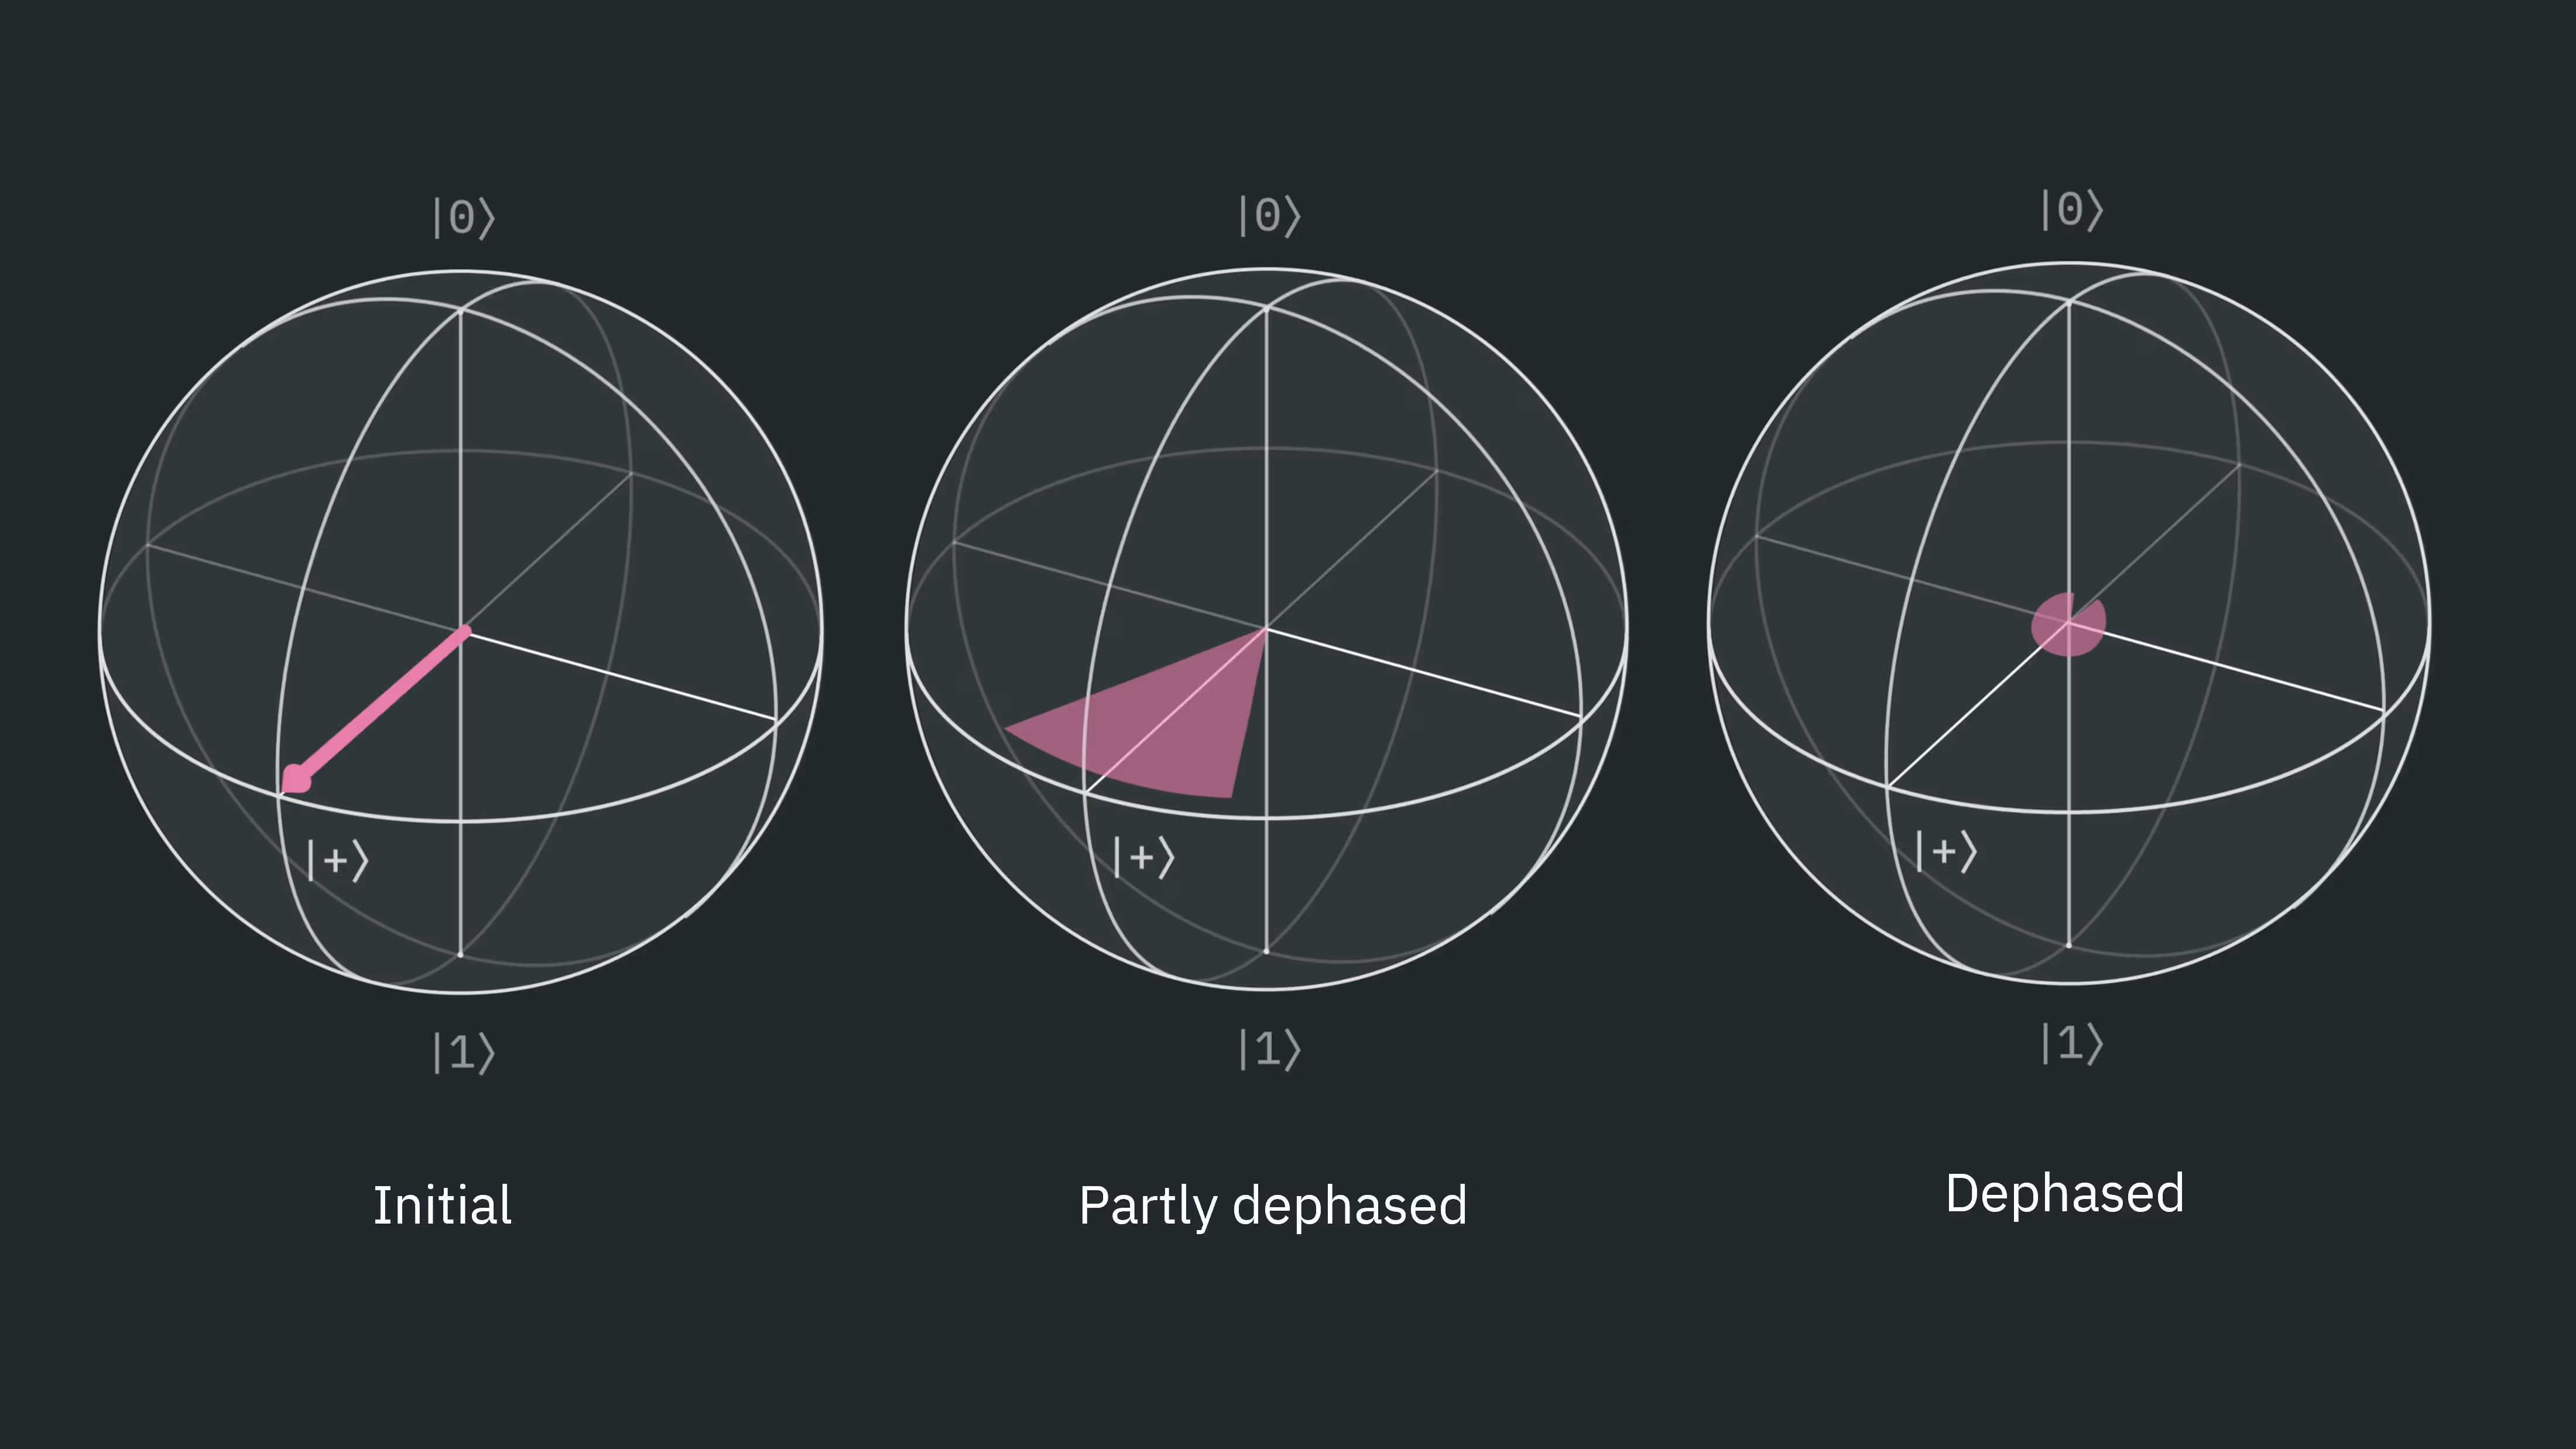
Si supiéramos que esta interacción está ocurriendo de manera controlada, podríamos predecirla. Para modelar este tipo de ruido, en cambio, consideramos una distribución de posibles intensidades de campo magnético, cada una ocurriendo con cierta probabilidad clásica (otras fuentes de ruido tendrían que modelarse de manera diferente). Necesitamos considerar qué sucede cuando hay una probabilidad clásica distinta de cero de que el estado no haya rotado en absoluto, y también cierta probabilidad de que haya rotado una pequeña cantidad, o incluso una gran cantidad. Esta distribución de posibles rotaciones es la razón de la dispersión del estado en la representación de la esfera de Bloch de abajo. Si hay más ruido de este tipo de desfase, la fase estará menos bien definida. En el límite de desfase fuerte, el qubit se desfasa por completo, lo que corresponde a la pérdida de la coherencia cuántica almacenada en el estado.
Por supuesto, en un experimento no tenemos idea de qué acoplamiento aleatorio ocurrirá. ¿Qué podemos hacer al respecto?
Supongamos que el acoplamiento ambiental permanece aproximadamente constante durante un intervalo de tiempo . Consideremos qué sucedería si siguiéramos esta prescripción:
-
Permitir que la fase cambie durante un tiempo
-
Aplicar una puerta X al qubit
-
Permitir que ocurra el mismo acoplamiento ambiental durante un tiempo adicional
-
Aplicar una segunda puerta X
Después de la evolución temporal inicial, tendríamos exactamente el estado anterior. Aplicando la primera puerta X tenemos:
Ahora, cuando transcurre el segundo intervalo de , ocurre la misma interacción. Pero ahora las amplitudes están asociadas con los autoestados Z opuestos, lo que significa que el signo de la rotación alrededor del eje Z se ha invertido. Después de permitir que el sistema evolucione en el tiempo durante otro , tenemos el estado:
Y sustituyendo tenemos:
Aplicar la puerta X final no hace nada en este caso, pero generalmente es necesario:
Hemos recuperado el estado cuántico original, incluida su fase relativa. Este proceso es un ejemplo especialmente simple de desacoplamiento dinámico.
De manera más general, el desacoplamiento dinámico (DD) consiste en insertar algunas puertas de un solo qubit para reducir el efecto de las interacciones con sistemas fuera del qubit (desacoplándolo del entorno). El reenfoque completo de todas las posibles historias de fase de vuelta al estado original, como se muestra arriba, está algo idealizado, pero sigue siendo un escenario posible. Analicemos cuándo es útil el DD y qué advertencias existen.
Comprueba tu comprensión
En el texto anterior, repasamos el efecto de una secuencia de DD XX sobre el estado inicial . Comprueba si los mismos pasos anteriores también devuelven el estado a su estado inicial bajo las mismas suposiciones de un campo magnético que varía lentamente a lo largo de la dirección z.
Respuesta
Después de la evolución temporal inicial, tendríamos exactamente el estado anterior. Aplicando la primera puerta X tenemos:
Ahora, cuando transcurre el segundo intervalo de , ocurre la misma interacción. Pero ahora las amplitudes están asociadas con los autoestados Z opuestos, lo que significa que el signo de la rotación alrededor del eje Z se ha invertido. Después de permitir que el sistema evolucione en el tiempo durante otro , tenemos el estado:
Y sustituyendo tenemos
Aplicando la puerta X final, tenemos:
Cuándo usar DD
La primera y más obvia advertencia es que asumimos un canal de desfase puro en nuestro tratamiento. Las interacciones del mundo real normalmente producen una mezcla de desfase y otros mecanismos de error. En el tratamiento anterior, elegimos aplicar puertas X específicamente. Esto se conoce como una secuencia XX en el desacoplamiento dinámico. Esta secuencia particular es apropiada para errores puramente de desfase. Pero hay otras secuencias que podrían ser más ampliamente aplicables, como XY4 (mostrada en el diagrama de circuito de abajo) y la más compleja XY8.

Otra advertencia es que el desacoplamiento dinámico añade puertas de un solo qubit, que pueden añadir errores de un solo qubit debido a imperfecciones de la puerta o incluso a diafonía. Estas tasas de error de un solo qubit suelen ser mucho más bajas que los errores de puertas multi-qubit, por lo que normalmente no es una preocupación importante, pero es algo que hay que tener en cuenta si muchos qubits emplean DD muchas veces a lo largo de tu circuito.
El DD es útil cuando el acoplamiento externo tiene tiempo de afectar al estado del qubit. Debido a que los qubits están meticulosamente bien aislados y los acoplamientos externos deberían ser débiles, este tipo de ruido es más notable cuando un qubit permanece inactivo durante largos periodos. Para tiempos de inactividad cortos, el efecto del DD podría ser añadir errores de puertas de un solo qubit mientras suprime muy poco ruido; la fidelidad de tu circuito podría en realidad reducirse.
Conclusión clave: Usa el desacoplamiento dinámico cuando los qubits permanezcan inactivos durante periodos suficientemente largos, y presta atención al tipo de secuencia de DD que se está usando.
Desacoplamiento dinámico usando Qiskit
Exploremos el uso del DD examinando el caso de varios qubits preparados en el estado , que luego permanecen inactivos durante mucho tiempo. En ausencia de errores, preparar el estado multi-qubit y luego aplicar una puerta Hadamard antes de la medición (midiendo así en la base X) siempre debería producir 0. Con ruido, el resultado de la medición será 0 solo una fracción del tiempo en lugar de con una probabilidad del 100%. Calculamos el valor de expectativa promedio de X a través de varios qubits. Es decir, nos interesa lo siguiente:
donde con el operador X en la posición desde la derecha y es el estado de todo el sistema.
Este circuito contiene retrasos intencionales, lo cual es algo artificioso para un benchmark. Sin embargo, es muy común que los circuitos reales contengan qubits que permanecen inactivos durante parte de la ejecución. Puedes pensar en esto como un modelo simplificado de un circuito más complejo en el que algunos qubits permanecen inactivos durante parte del cálculo. Este tipo de benchmarking basado en la evolución de estados a menudo se conoce como benchmarking de Ramsey.
Comenzamos cargando los paquetes necesarios y configurando el servicio.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Ahora definimos algunas funciones auxiliares. Primero, queremos abordar el punto sobre los tiempos de inactividad largos. ¿Qué significa exactamente "largo" en este contexto? Podríamos simplemente reportar el tiempo de inactividad en microsegundos. Sin embargo, es útil saber cuántas puertas de dos qubits podrían ejecutarse durante ese mismo intervalo. Esto hace que los tiempos de inactividad sean más directamente indicativos de la profundidad del circuito que podría haberse ejecutado durante el mismo periodo. La primera función auxiliar obtiene la puerta de dos qubits nativa del backend y determina la duración de esa puerta.
La segunda función simplemente crea un circuito de Ramsey (uno con qubits en el estado ), implementa un retraso, rota usando una puerta H, y luego mide. Recuerda que una puerta Hadamard (H) mapea a , por lo que medir en la base Z después de la Hadamard corresponde a que el qubit estuviera en inmediatamente antes de la Hadamard.
Nuestra función final convierte los conteos brutos de resultados de medición de 0 y 1 en un valor de expectativa de X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Ahora especificamos los detalles de nuestra prueba, incluyendo el número de qubits y la secuencia de puertas a usar en el DD (en este caso XX). Ten en cuenta especialmente que establecemos el nivel de optimización en cero. En la práctica, a menudo seleccionarías un nivel de optimización más alto; aquí usamos el nivel 0 para asegurarnos de que los efectos de los errores a los que apunta el DD permanezcan visibles. Finalmente, determinamos el tiempo característico para las puertas de dos qubits en este backend e imprimimos algunos tiempos relevantes.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Ahora construimos nuestros circuitos y los transpilamos para nuestro backend elegido.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
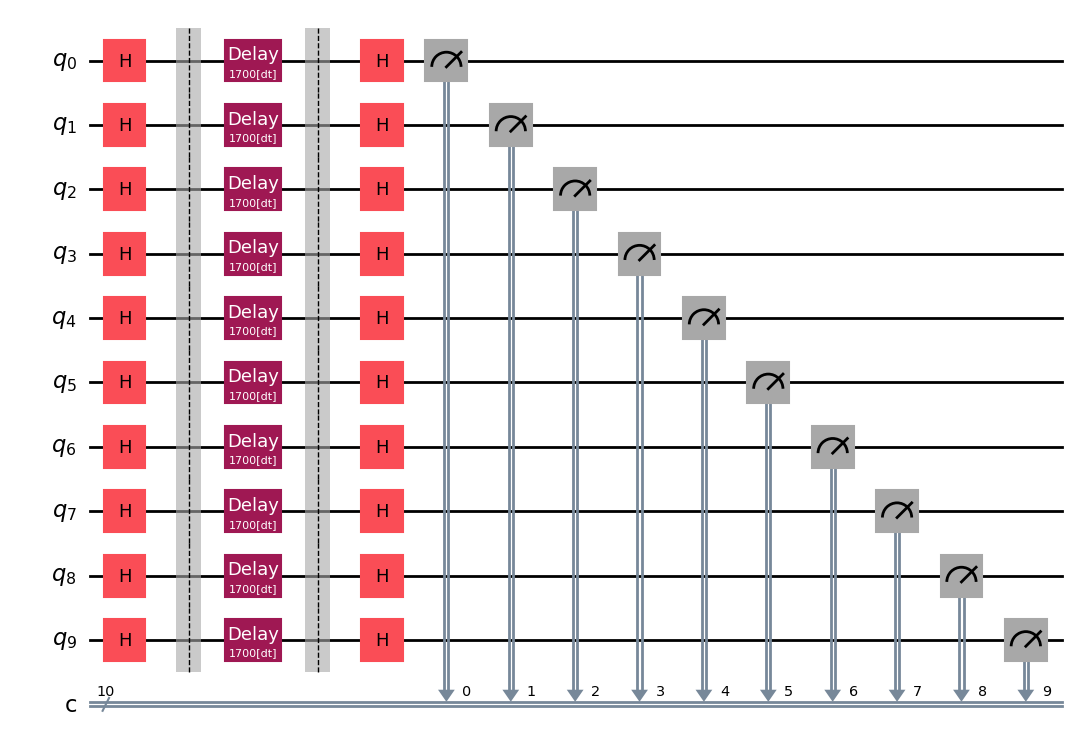
Deberíamos visualizar al menos un circuito para asegurarnos de que hemos codificado nuestro circuito con los estados y retrasos deseados. Podría ser más fácil visualizar el circuito pre-transpilado qc, o podrías revisar el transpilado qc_isa.
qc.draw("mpl")
Ejecutar
Finalmente estamos listos para ejecutar en hardware. Usamos Sampler para obtener muchas mediciones de cada qubit, y lo usaremos dos veces: una vez con el DD explícitamente desactivado, y otra vez con el DD activado y usando la secuencia de puertas XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Podemos extraer los conteos de los diversos circuitos.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Post-procesamiento
Ahora tenemos los conteos de la medición, pero queremos convertirlos en el valor de expectativa de X y luego promediar esos valores de expectativa entre todos los qubits que usamos, para aprender sobre la preservación de la información de fase. Para eso usamos nuestra función counts_to_x_expectations definida anteriormente.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Finalmente, grafiquemos nuestros resultados.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
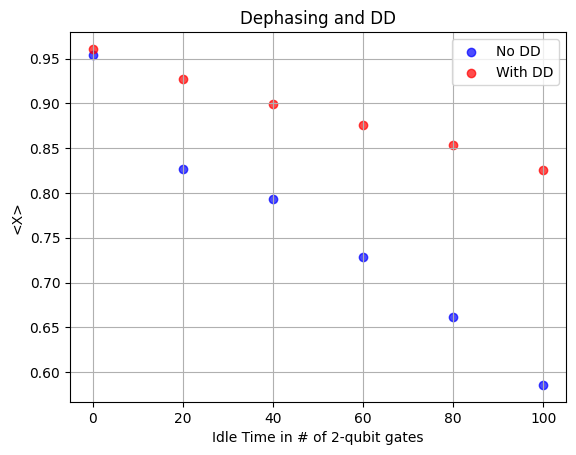
Como puedes ver, sin retraso explícito los valores de expectativa están de hecho cerca de 1, lo cual esperaríamos si se preservara toda la información de fase. Si se perdiera toda la información de fase, no habría preferencia para que la rotación final produjera en lugar de , y el valor de expectativa promedio se aproximaría a cero. En los datos, vemos que a medida que aumentan los tiempos de retraso, el valor de expectativa promedio de X disminuye, comenzando a aproximarse a cero. Ten en cuenta que el DD ha sido muy efectivo aquí; los valores de expectativa con DD suelen ser más de un 20% mejores (más cercanos a 1) que los valores sin DD. Pero también ten en cuenta que el primer punto de datos con retraso corresponde a un retraso aproximadamente equivalente a 100 operaciones de puerta de dos qubits. Esto refuerza el punto de que el DD es más útil cuando los qubits permanecen inactivos durante periodos relativamente largos.
Comprueba tu comprensión
Si aplicamos DD usando XY4 al mismo circuito que antes, ¿esperas que produzca resultados mucho mejores, mucho peores, o aproximadamente iguales, que el DD usando XX? Explica.
Respuesta
Aproximadamente iguales, quizás ligeramente peores. El circuito que usamos tenía estados rotados hacia el plano XY. Este estado almacena información principalmente en su fase, lo que lo hace especialmente sensible a errores de desfase en lugar de a la relajación T1. XY4 podría ayudar con una mayor variedad de errores, pero XX ya está optimizado para ayudar al circuito que estamos usando. XY4 podría ser igual de bueno, pero no añadiría nada sustancial, o el hecho de que XY4 contenga más puertas podría permitir errores de puerta adicionales que hagan que los resultados sean ligeramente peores.
El último resultado usó la secuencia de puertas de DD más simple, XX. Veamos cómo implementar una secuencia más compleja, XY4. Definimos un Sampler en la siguiente sección.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
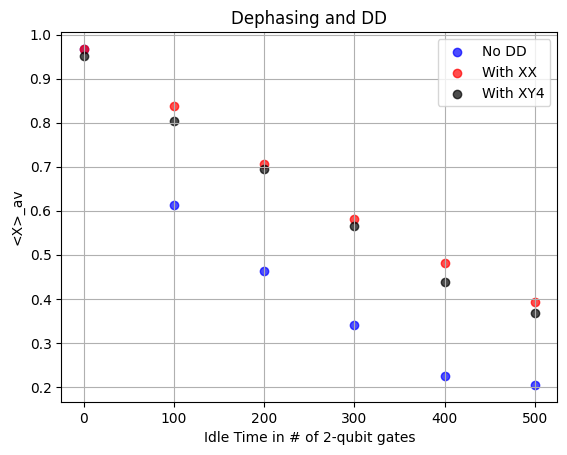
Aquí vemos que XY4 no es apreciablemente diferente de XX. Podría ser muy ligeramente peor debido a puertas adicionales en la secuencia XY4, pero más importante aún, ya explicamos por qué XX tendría el efecto deseado en preservar la fase específicamente para un estado como . No hay razón para pensar que, para un estado inicial así, una secuencia diferente mejoraría los resultados.
Comprueba tu comprensión
Verifica que la secuencia XY4 deja el estado sin cambios salvo por una fase global.
Respuesta
Pauli twirling
Deberíamos comenzar señalando que el Pauli twirling a menudo se usa no como una técnica de supresión de errores, sino como una técnica de modelado de errores: hace que el ruido/los errores se comporten de manera diferente, a veces de forma más predecible, para permitir otros métodos. Aunque el Pauli twirling no previene los errores, podría prevenir su acumulación coherente.
En un circuito cuántico, múltiples fuentes diferentes de error se suman. Los errores pueden sumarse de diferentes maneras, notablemente de forma coherente e incoherente. La acumulación coherente de errores significa que el ruido o las implementaciones imperfectas tienden a impulsar los errores en la misma dirección a través de múltiples capas y puertas. Un ejemplo sería una sobrerrotación coherente al aplicar una puerta de rotación.
Consideremos una puerta de rotación ideal, como , que rota alrededor del eje X exactamente . Por supuesto, la implementación de la puerta no es perfecta, y la rotación real podría ser para una implementación, e incluso podría darse el caso de que tenga siempre el mismo signo, y posiblemente una magnitud similar a través de muchas aplicaciones de . Por lo tanto, la aplicación repetida de puertas de rotación puede resultar en una acumulación coherente de estas muchas sobrerrotaciones (o subrrotaciones), .
La acumulación incoherente de errores es justo lo opuesto: errores en direcciones aleatorias con signos aleatorios, de manera que los errores en diferentes capas no siempre interfieren de forma aditiva, sino que a veces se cancelan o se suman en cuadratura. Claramente, los errores incoherentes se acumulan más lentamente en términos del efecto general sobre el estado del qubit. Un diagrama simplificado de esto se muestra en la figura de abajo. Esto es una simplificación. Los errores cuánticos reales no están restringidos a un espacio cartesiano bidimensional; no todas las contribuciones de error tendrán la misma magnitud, y hay más complejidades. Pero la intuición de una imagen como esta es útil: los errores coherentes tienden a acumularse más rápido que los incoherentes.
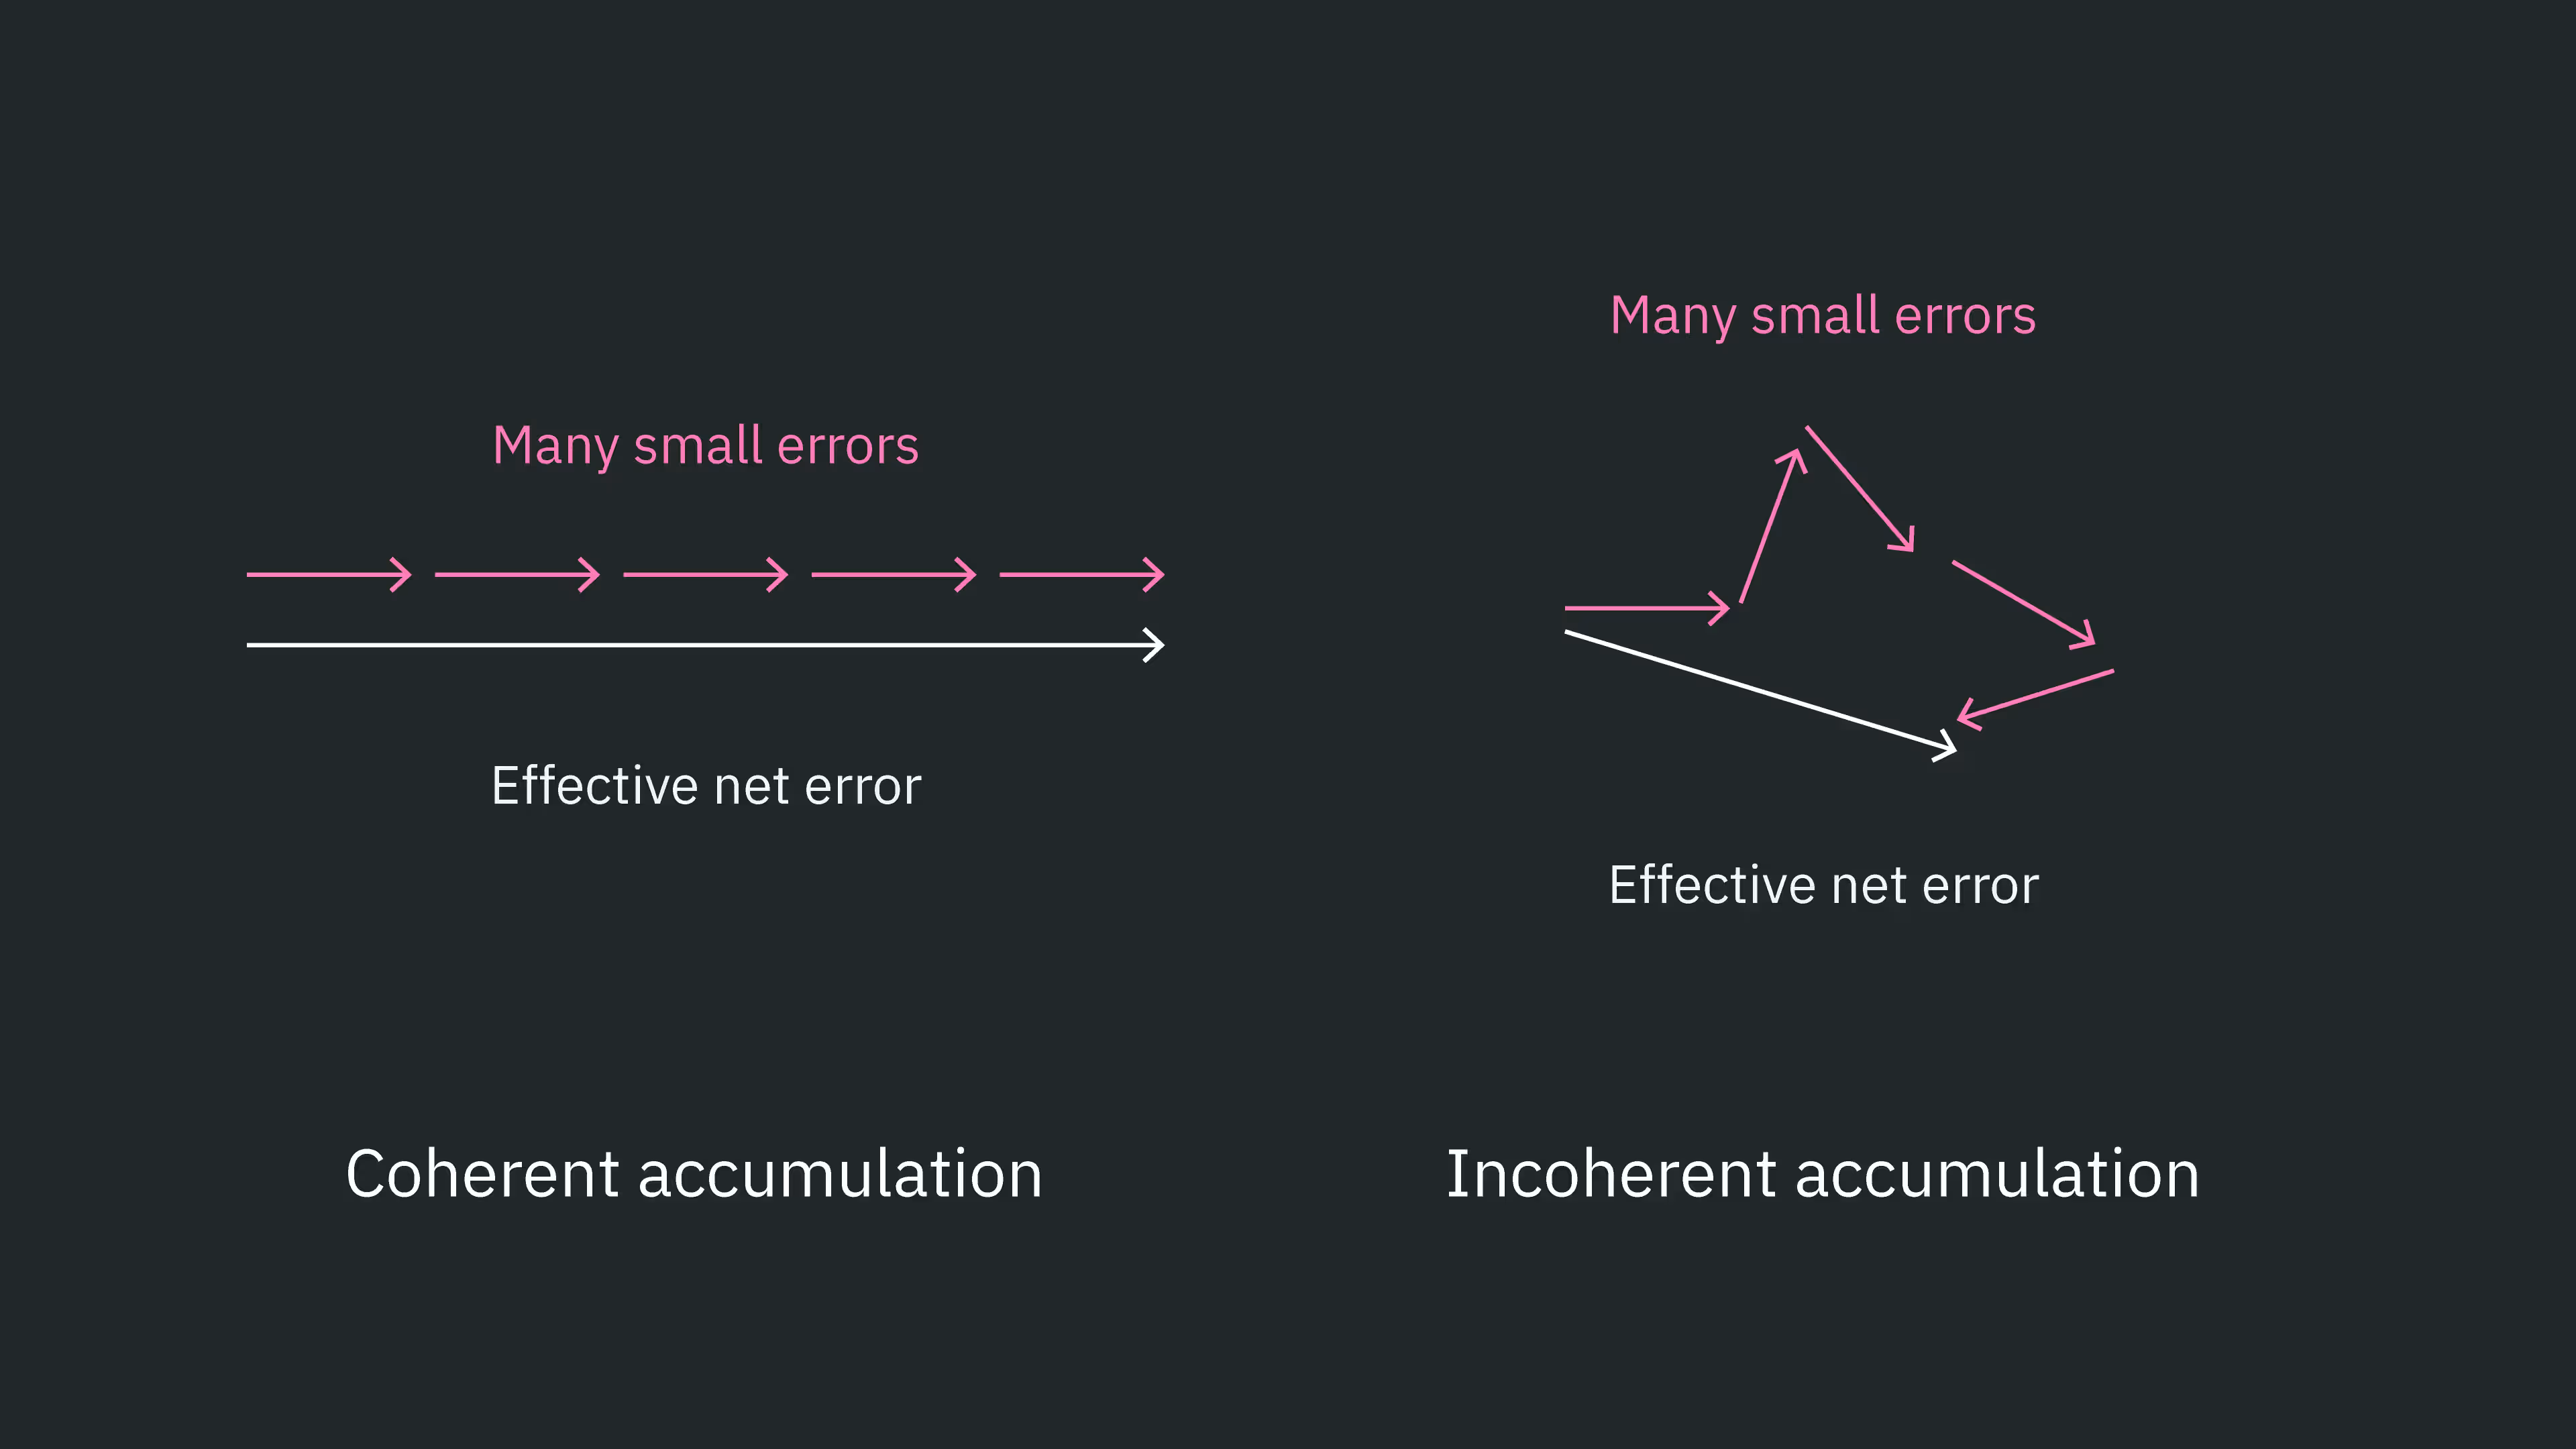
A menudo se pueden obtener resultados de mayor fidelidad convirtiendo la acumulación coherente de errores en acumulación incoherente de errores. Una forma principal de lograr esto se llama Pauli twirling.
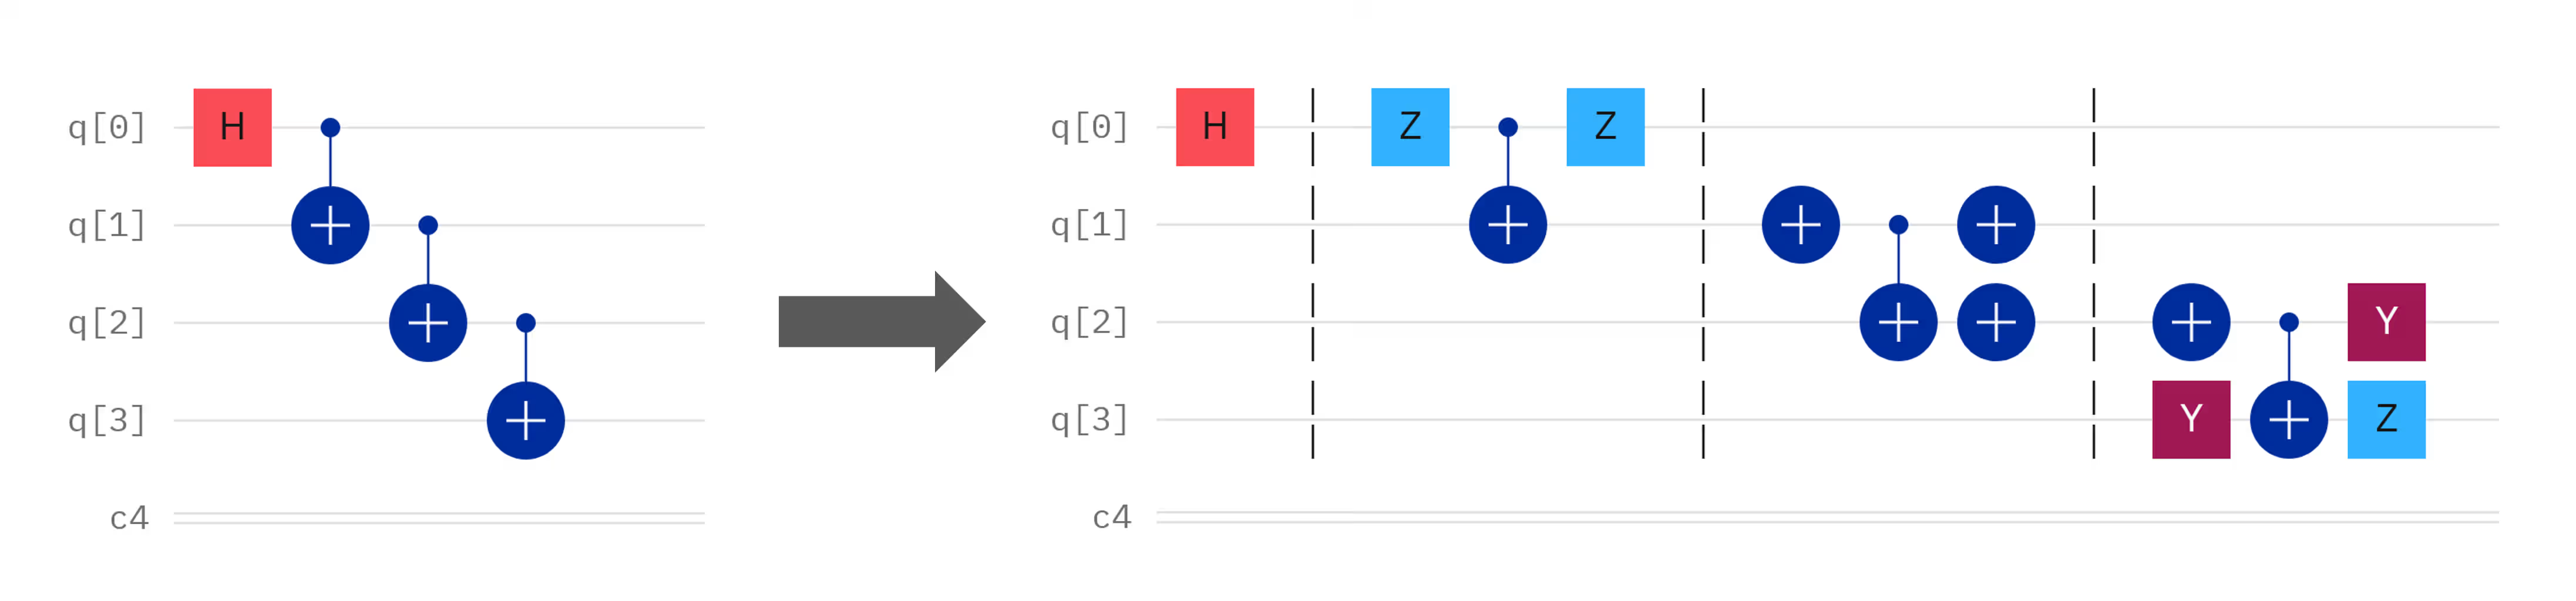
El Pauli twirling se refiere a añadir combinaciones de puertas de Pauli antes y después de una operación de puerta deseada de tal manera que . Aquí, y no son Paulis individuales, sino colecciones de operadores de Pauli que a menudo actúan sobre varios qubits. A veces podrías ver afirmado que la acción de las puertas de Pauli adicionales es "equivalente a la identidad". Pero esto es impreciso y potencialmente confuso. Las puertas de Pauli están separadas por y el objetivo es dejar la acción lógica de todas las puertas igual a . A veces se llama a la "carga útil" para distinguir esta operación pretendida de las puertas añadidas para la supresión. A continuación se muestran algunos ejemplos de Pauli twirling alrededor de una puerta CNOT.

Recorramos solo un ejemplo para verificar que el twirling deja sin cambios el efecto lógico de la carga útil. Sin pérdida de generalidad, sean los estados de dos qubits que involucran a y :
Como siempre, estamos usando la convención de ordenamiento de qubits . Aplicando una puerta CX con como objetivo se obtiene
Ahora consideremos el tercer circuito mostrado, que usa puertas X para el Pauli twirling. Podríamos simplemente multiplicar las matrices entre sí y verificar que producen una matriz CNOT. Alternativamente, podemos rastrear la operación sobre un estado cuántico arbitrario a través del circuito, como hacemos a continuación. Los estados en diferentes puntos del circuito se han etiquetado a-d.

Esto es exactamente que obtuvimos antes sin twirling. De hecho, esta secuencia de puertas con twirling deja sin cambios la acción lógica de la carga útil. Sin embargo, si se seleccionan aleatoriamente diferentes secuencias válidas de twirling de capa a capa, la acumulación coherente de errores puede convertirse en una acumulación de errores efectivamente estocástica (incoherente). Para ser claros, no se elige un único patrón de twirling y se usa en todo el circuito. En cambio, se seleccionan diferentes secuencias válidas de twirling para diferentes capas. Un ejemplo con muchas capas de entrelazamiento podría verse así.
Comprueba tu comprensión
Verifica que el Pauli twirling en el cuarto panel de la figura anterior también deja sin cambios el efecto lógico del CNOT.
Respuesta
Seguimos el ejemplo anterior y mostramos que la acción sobre cualquier estado arbitrario de dos qubits es equivalente a una operación CNOT. Nos referiremos a los puntos etiquetados en este diagrama.

Esto es equivalente a la acción de un CNOT con el qubit 0 como control y el qubit 1 como objetivo.
¿Puedes idear una secuencia de Pauli twirling para la puerta CNOT que no se haya mostrado anteriormente?
Respuesta
Sí, hay muchas otras. Un ejemplo es antes del CNOT, y un y después del CNOT.
Cuándo usar el Pauli twirling
Tal como se presenta aquí, el Pauli twirling se aplica solo a puertas multi-qubit. Aplicar un protocolo similar a puertas de un solo qubit requeriría una lógica diferente y generalmente no es útil en la práctica. El propio Pauli twirling usa varias puertas de un solo qubit (las puertas de Pauli). Las puertas de Pauli adicionales probablemente introducirían más error del que se ganaría al aleatorizar cualquier acumulación coherente de errores. Las tasas de error asociadas con las puertas de dos qubits son mucho mayores que las asociadas con las puertas de un solo qubit. Además, algunas puertas de un solo qubit son no-Clifford, las cuales no se pueden hacer twirling por completo. Es por esto que Qiskit incluye opciones de Pauli twirling que automáticamente hacen twirling alrededor de puertas de dos qubits, y no alrededor de puertas de un solo qubit.
Esto estaba implícito en la figura anterior: el Pauli twirling se implementó alrededor de las puertas CX, pero no alrededor de la puerta Hadamard.
Veamos dos ejemplos de Pauli twirling en acción.
Pauli twirling para suprimir la acumulación coherente
Para observar cómo el Pauli twirling puede convertir la acumulación coherente de errores en una acumulación incoherente más lenta, queremos un circuito y un observable que funcionen como una prueba de estrés de error coherente. El único propósito es hacer visibles los errores de dos qubits que se acumulan coherentemente, y luego mostrar cómo el Pauli twirling convierte esa acumulación coherente en una desintegración estocástica.
Las puertas CNOT (o CZ) son una fuente común de errores coherentes. El experimento más simple que podemos hacer en este caso es inicializar un estado (digamos ), aplicar capas de puertas CNOT emparejadas (usando el hecho de que dos CNOT producen una identidad), y comprobar cómo se acumulan los errores a medida que aumenta el número de capas, tanto con como sin Pauli twirling.
El observable de interés es en un solo qubit, que graficamos en función del número de repeticiones de pares de CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Debido a que hemos rotado nuestra base antes de las mediciones, una medición de corresponde a que el estado haya estado en justo antes de la puerta Hadamard final, y de forma similar para y . Por lo tanto, nuestro valor de expectativa se puede calcular simplemente a partir de los conteos de menos los conteos de .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Seleccionamos un número razonable de capas de CNOT sobre las cuales permitir que se acumule el error, construimos nuestros circuitos, y luego los transpilamos.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Ten en cuenta que cada capa consiste en más de una puerta de dos qubits. Monitorea la profundidad de dos qubits transpilada usando la función de abajo.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Ahora ejecutamos los trabajos.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Finalmente, visualizamos estos resultados.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
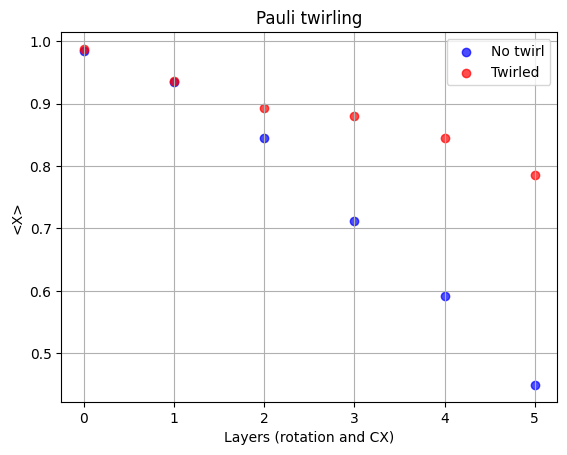
Podemos ver claramente que el circuito con twirling produce un valor de expectativa más cercano al ideal . Este ejemplo cumplió su propósito, pero pasemos a algo más útil: el twirling en la producción de estados altamente entrelazados.
Pauli twirling en la preparación de estados GHZ
El ejemplo anterior mostró un caso convincente para el Pauli twirling en la destrucción de la acumulación coherente de errores asociados con las puertas CNOT. La producción de estados GHZ usa muchas puertas CNOT para producir estados altamente entrelazados útiles para muchas aplicaciones de computación cuántica. Exploremos cómo ayuda el Pauli twirling en este contexto, con estados GHZ de tamaño creciente.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

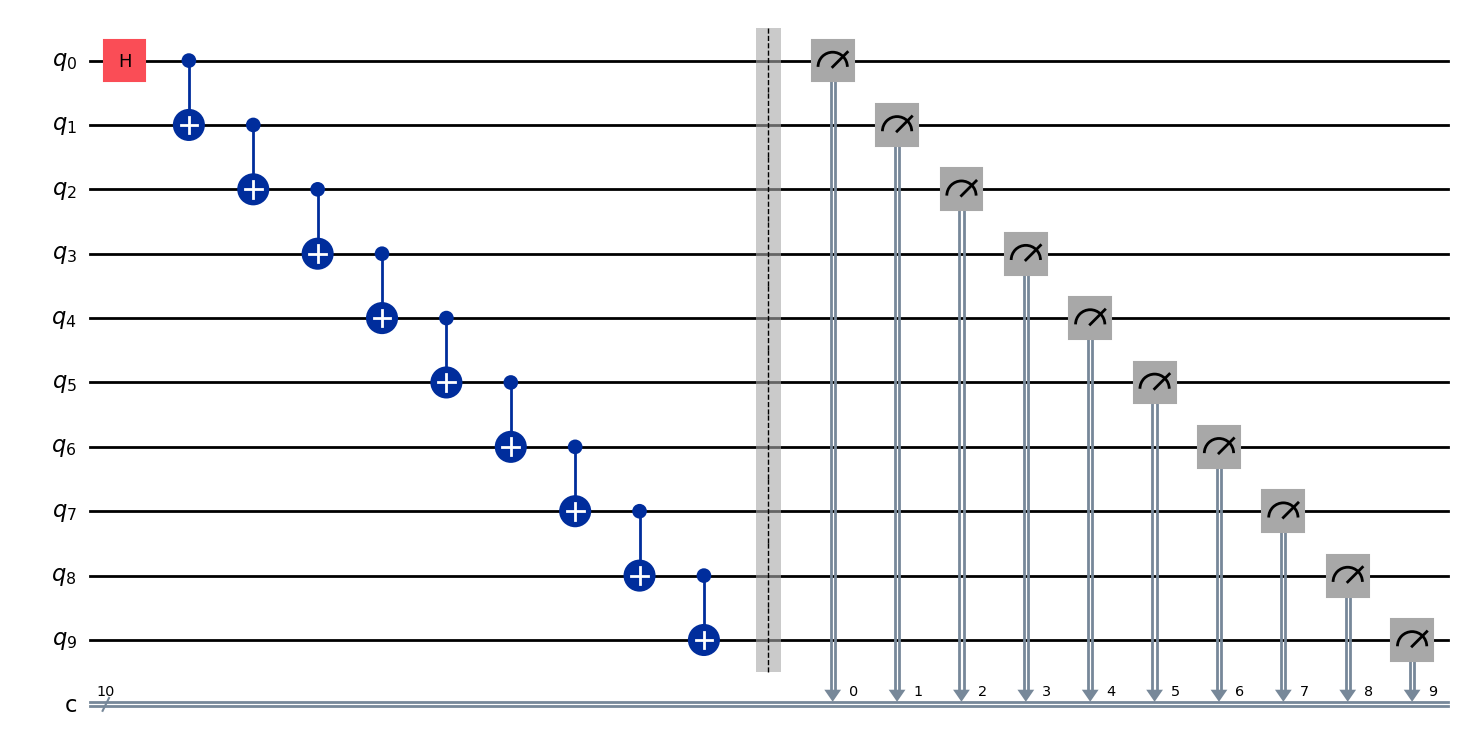
# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
Ahora construimos nuestros circuitos y los transpilamos. En este caso, no tenemos puertas artificialmente repetidas que se reduzcan a la identidad. Así que podemos permitir que el pass manager haga un poco más de optimización por nosotros. Lo estableceremos en el nivel tres.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Podemos ver que el optimizador mapeó nuestro circuito abstracto a los qubits 123, 124, 136, 142 y 143.
circuits[0].draw("mpl")
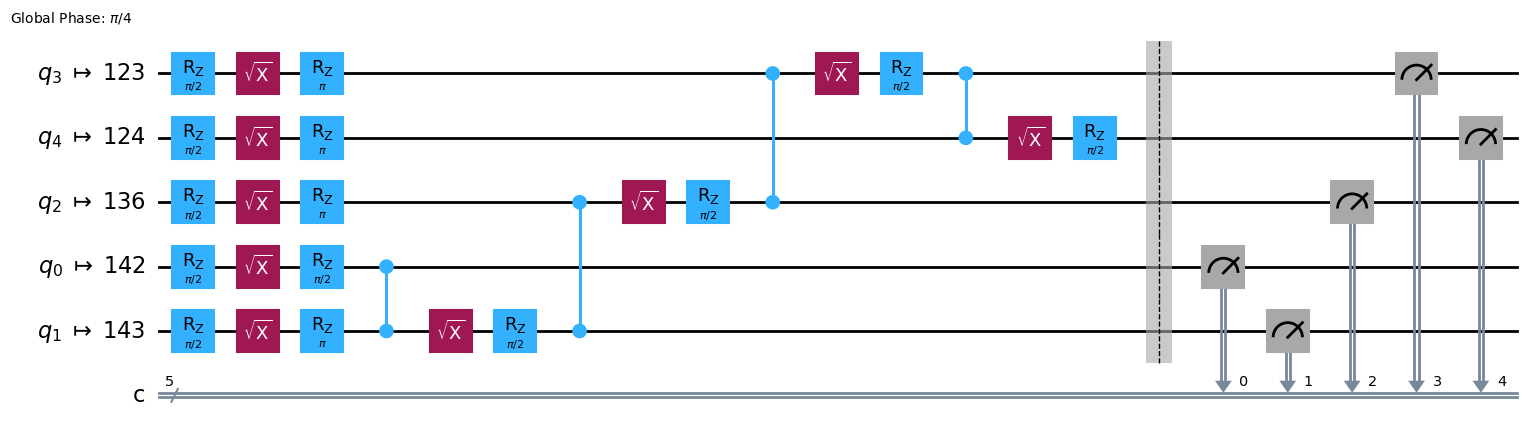
Para entender por qué, veamos un mapa de la disposición de nuestro backend (en esta imagen, ibm_fez, pero puedes hacer análisis equivalentes en cualquier backend).
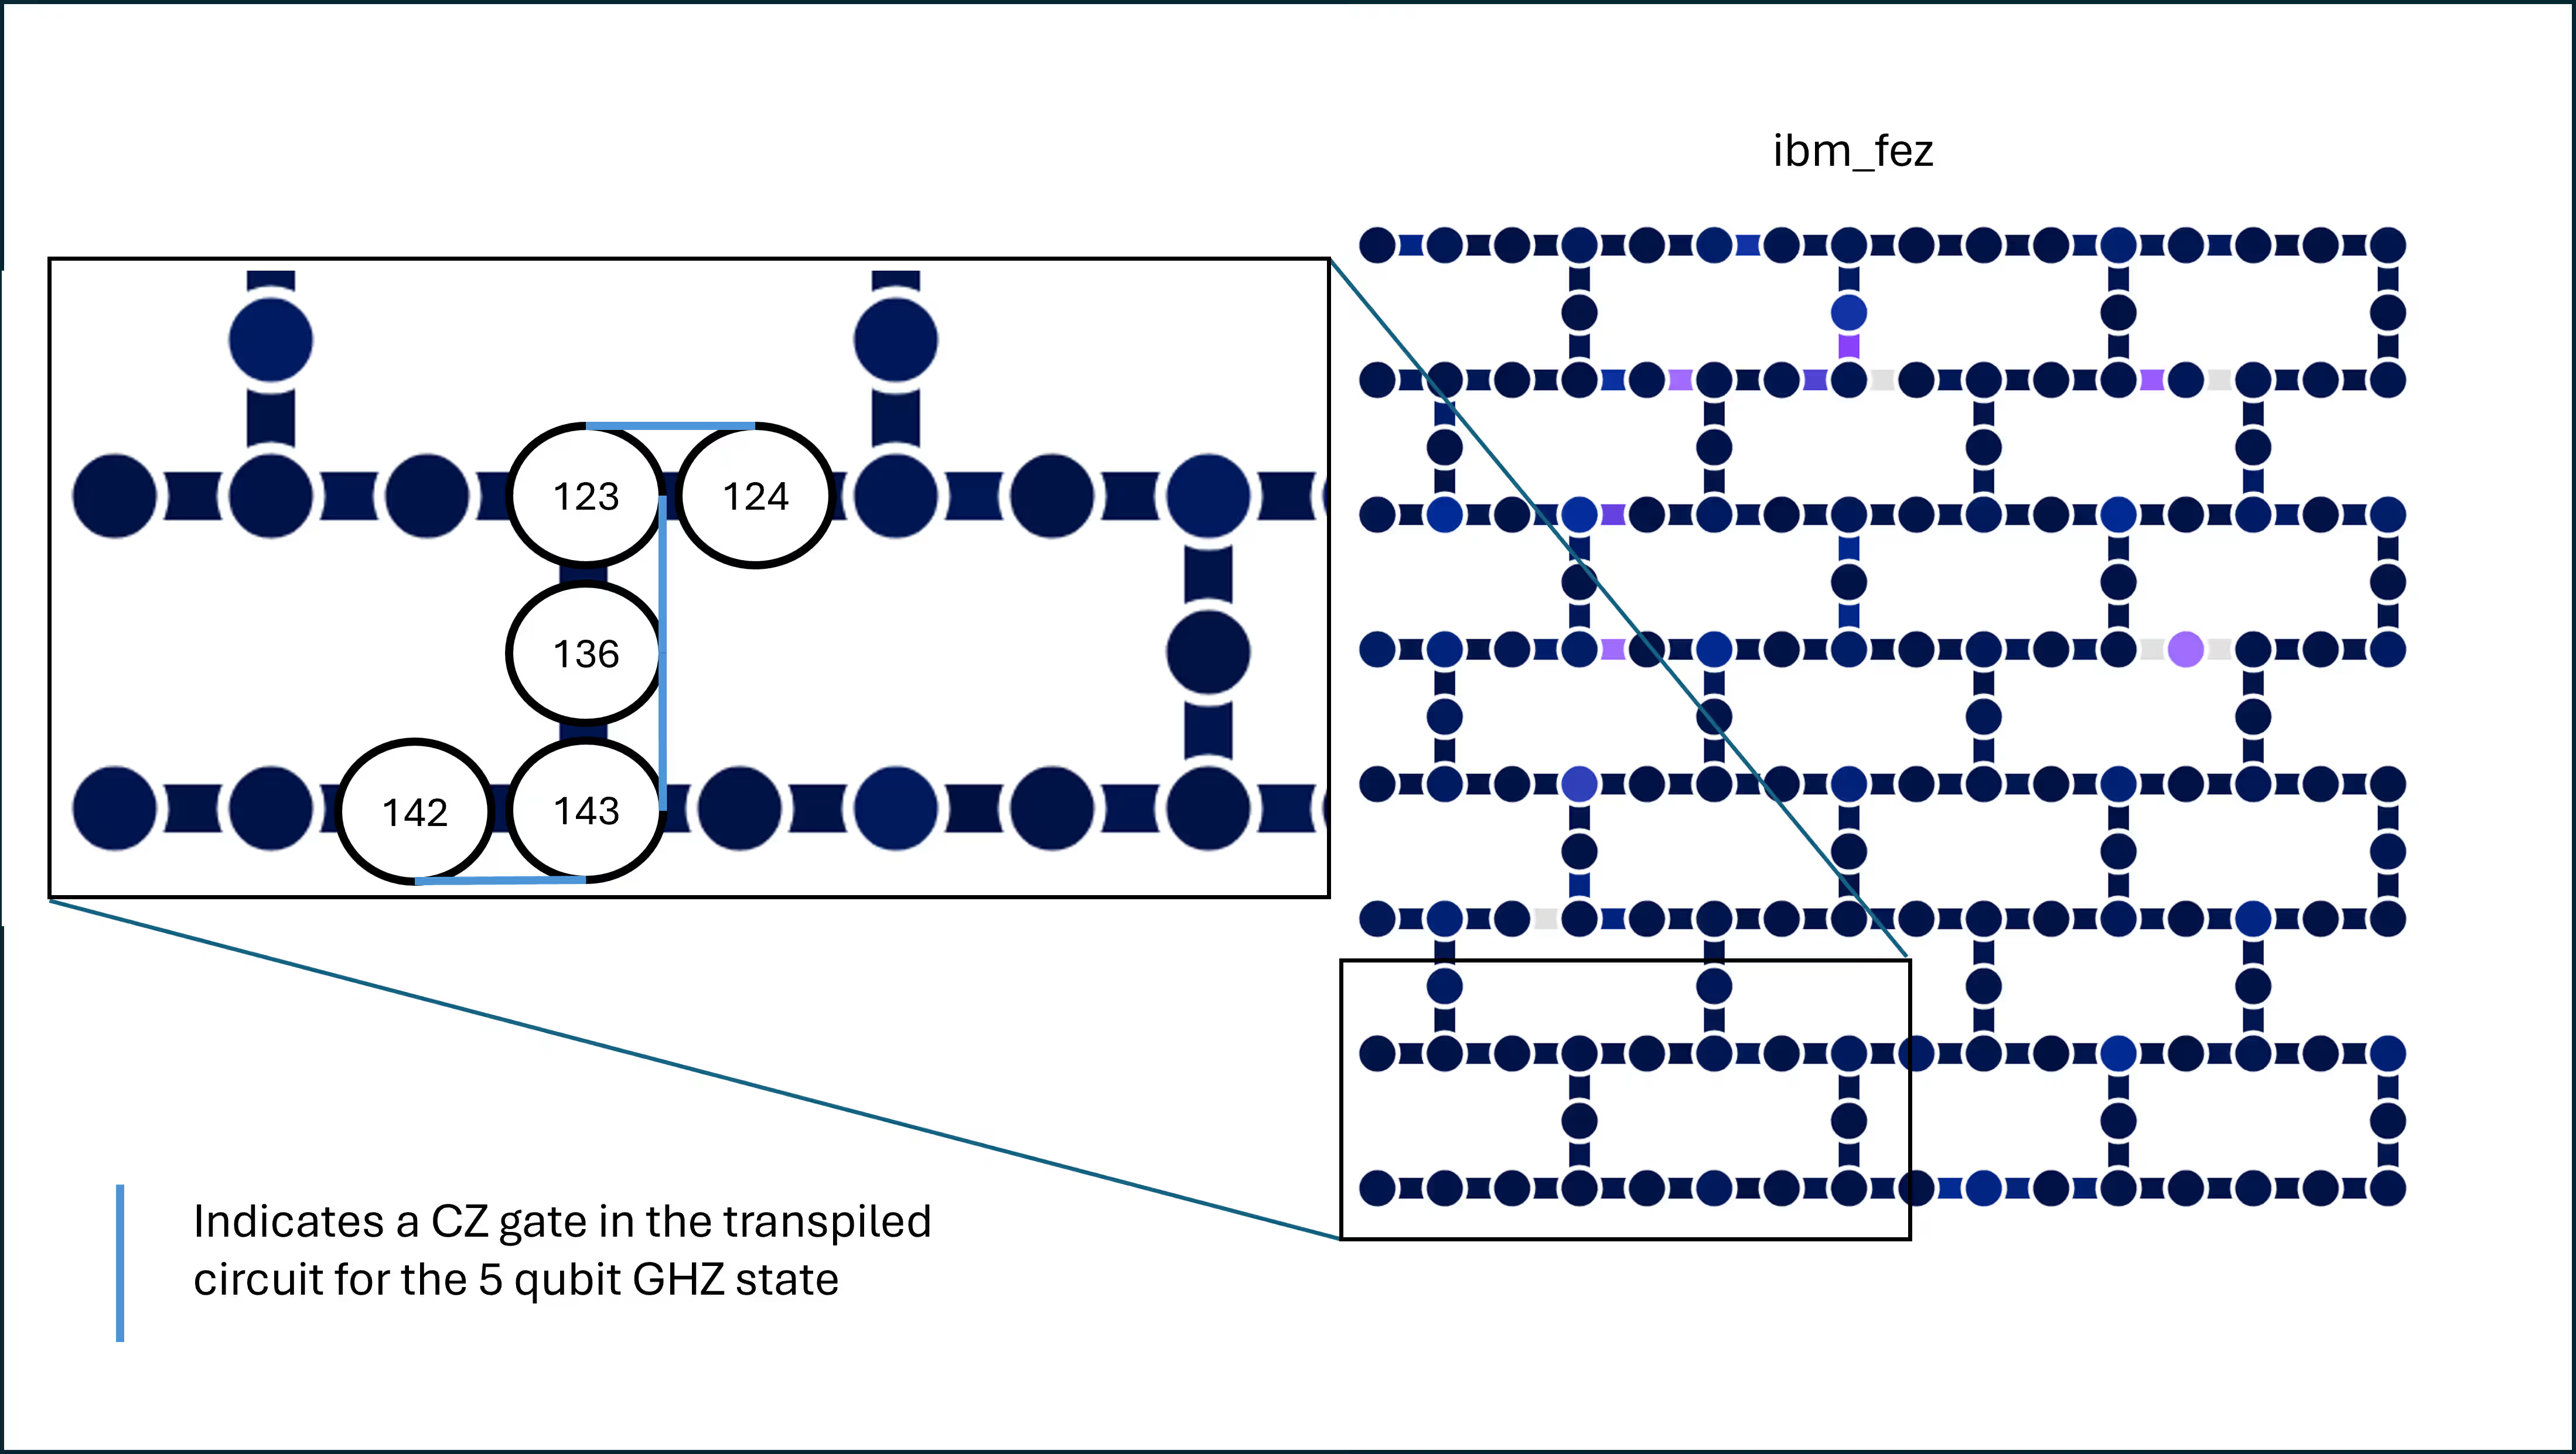
Vemos que los qubits se seleccionaron en una cadena para minimizar las puertas swap y, por lo tanto, la profundidad del circuito. Además, cada puerta CZ implementada en el circuito está entre qubits adyacentes. Finalmente, los cinco qubits tienen tasas de error relativamente bajas, incluyendo las tasas de error de asignación de lectura. Puedes verificar estas tasas de error en cualquier backend en la página de Recursos de cómputo. Encontrar una disposición así no es difícil para una simple cadena lineal, pero a medida que los problemas se vuelven más complejos, la optimización de la disposición del circuito se vuelve más difícil y más valiosa.
Ahora configuramos nuestra primitiva Sampler. Desactivamos otras herramientas de supresión/mitigación para centrarnos en el Pauli twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Finalmente, ejecutamos nuestros trabajos. Opcionalmente puedes imprimir los números de ID de trabajo para su recuperación posterior.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Extraemos los conteos de cada estado base computacional medido para todos los circuitos, tanto con como sin twirling.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Sabemos que la distribución ideal de un estado GHZ es aquella en la que la mitad de los disparos devuelven y la otra mitad devuelven . Construye esto para comparación.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Ahora usamos la fidelidad de Hellinger como medida de la calidad de nuestro estado final.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Finalmente graficamos nuestros resultados.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
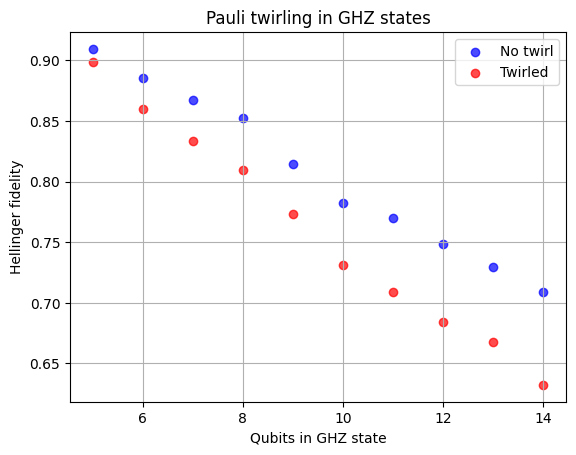
Los resultados usando Pauli twirling no son mejores (e incluso son ligeramente peores) que sin twirling. ¿Qué sucedió?
Sucedieron dos cosas. Primero, el Pauli twirling no reduce la cantidad total de ruido — más bien, transforma errores coherentes y sistemáticos en errores estocásticos de tipo Pauli, de manera que el crecimiento del error se vuelve predecible y modelable. Nunca hubo ninguna promesa de reducción de errores, excepto en casos especiales.
En segundo lugar, en los circuitos GHZ, algunos errores coherentes pueden cancelarse parcialmente o actuar como desplazamientos de fase benignos debido a la simetría de la construcción GHZ; el twirling elimina esta protección accidental y la reemplaza con ruido de Pauli estocástico no correlacionado, por lo que la fidelidad de GHZ se vuelve ligeramente peor bajo twirling.
Esta segunda afirmación requiere alguna explicación. La afirmación no es que los circuitos GHZ estén protegidos de todos los tipos de acumulación coherente de errores, solo de algunos tipos — y que en esos casos la protección se destruye por el twirling. Específicamente, consideremos la sobrerrotación coherente asociada con las puertas CX. Llamemos a la puerta CX real con sobrerrotación :
donde es cualquier producto de operadores de Pauli, como , , , , etc. Para estados generales, cualquiera de estas sobrerrotaciones podría afectar las estadísticas de medición (y por lo tanto las medidas de fidelidad del estado). Sin embargo, un subconjunto de estas deja muchos observables GHZ estándar sin cambios, incluyendo operadores como y . En el contexto de la preparación de un estado GHZ, los errores de sobrerrotación relevantes de este tipo serían:
La preparación del estado GHZ completo de qubits se vería así:
Después de preparar el estado GHZ, el estado es idealmente:
Este estado es un autoestado simultáneo de un gran conjunto de operadores de Pauli, incluyendo los siguientes:
con autovalor . Como resultado, un operador de la forma actúa sobre el estado GHZ como una multiplicación por el factor de fase , lo cual no afecta a los observables GHZ estándar como la paridad, colectivo, o las poblaciones en base computacional. Por lo tanto, aunque los errores de sobrerrotación son coherentes y sistemáticos, son efectivamente invisibles para las mediciones utilizadas para evaluar la fidelidad GHZ. En este sentido, el circuito GHZ disfruta de una protección de coherencia accidental: ciertos errores coherentes de CX conmutan con la estructura del estado que se está preparando y, por lo tanto, no degradan el rendimiento medido.
El Pauli twirling cambia fundamentalmente esta situación. El twirling no preserva el error de sobrerrotación coherente como un proceso determinista . En cambio, convierte el canal de error coherente en un canal de Pauli estocástico efectivo. Como resultado, el canal de error ahora incluye términos como , , , y , que no conmutan con los estabilizadores GHZ.
Cuando ocurren estos errores estocásticos de Pauli, crean fallos reales de bit-flip y phase-flip en qubits individuales o pares de qubits. Estos errores sacan al estado del subespacio estabilizador GHZ, reducen la interferencia entre y , y disminuyen directamente la fidelidad GHZ y las señales de paridad multi-qubit. En otras palabras, el Pauli twirling elimina la estructura coherente del error, pero también elimina la cancelación basada en simetría que anteriormente hacía que esos errores fueran benignos. El resultado es un estado GHZ ligeramente peor — no porque el twirling añada ruido, sino porque convierte un error coherente mayormente inofensivo en errores estocásticos genuinamente dañinos.
Este ejemplo destaca una lección importante: el Pauli twirling no es una estrategia de mejora universal. Es más beneficioso cuando los errores coherentes se acumulan a lo largo de un circuito de manera destructiva para la fidelidad requerida. En circuitos altamente simétricos como la preparación del estado GHZ, algunos errores coherentes están naturalmente alineados con los estabilizadores del estado, y aleatorizarlos deliberadamente puede eliminar esta protección accidental.
Combinar métodos
En principio se puede combinar el Pauli twirling con el desacoplamiento dinámico. No hemos utilizado DD en este caso por dos razones: primero, no debería haber periodos de inactividad extremadamente largos en este circuito. Segundo, los estados GHZ no almacenan la mayor parte de su información en la coherencia de fase de un solo qubit, particularmente si estamos observando la fidelidad solo en términos de conteos de cadenas de bits, y no en términos de la fase entre las cadenas de bits deseadas y .
Si extendiéramos la preparación GHZ a más de 100 qubits, entonces los retrasos en la medición de los primeros qubits podrían de hecho ser lo suficientemente largos como para que DD fuera útil. Esto es especialmente cierto cuando tenemos en cuenta la profundidad transpilada del circuito.
Pauli twirling en la estructura de eco RTZ
Nuestro último ejemplo de Pauli twirling en el contexto de reducir la acumulación de error coherente utiliza un circuito con capas de combinaciones X-CZ-X-CZ. Esta es una secuencia de puertas bien conocida que se utiliza a menudo para cancelar términos de error coherente ZZ en puertas de dos qubits, incluso sin twirling. Pero con twirling, podemos reducir o aleatorizar otras formas de acumulación de error coherente.
Comenzaremos definiendo una función para construir los circuitos tipo RTZ con un número variable de capas.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Ahora construimos circuitos con un número creciente de capas, hasta alcanzar una profundidad total transpilada de dos qubits razonable.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
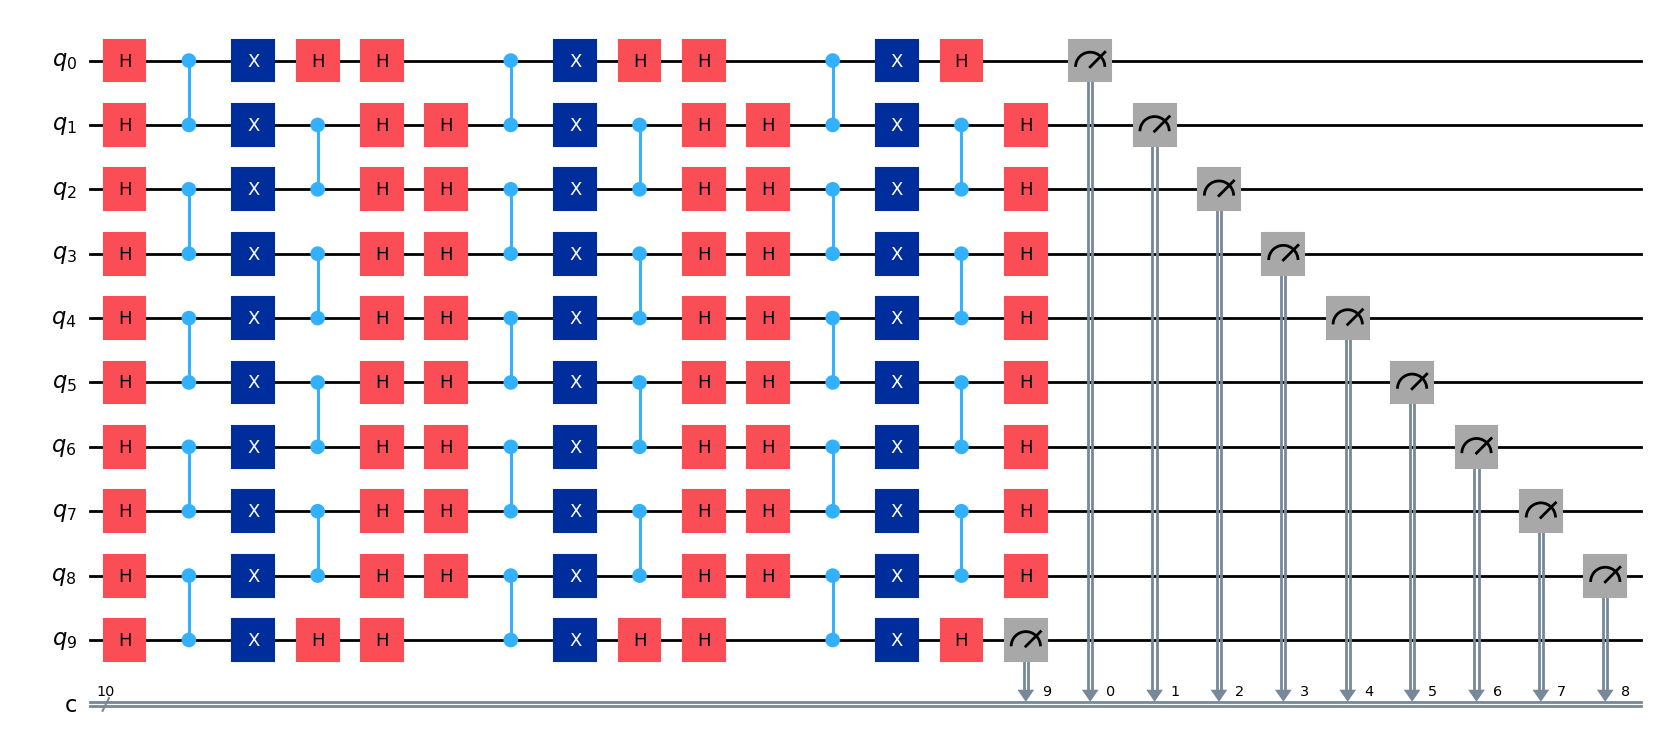
En el extremo superior, algunos de estos son bastante profundos. Usemos el AerSimulator sin modelo de ruido para obtener los estados ideales al final de cada uno de estos circuitos. Luego podemos comparar nuestros resultados de computadoras cuánticas reales utilizando la fidelidad de Hellinger.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Ahora definimos un SamplerV2 con twirling, y otro sin twirling.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Ahora ejecutamos nuestros trabajos.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Obtenemos los conteos de cada una de las ejecuciones en una computadora cuántica real.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Ahora encontramos la fidelidad de Hellinger comparando cada una de estas ejecuciones con los resultados del AerSimulator sin ruido.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Ahora visualizamos nuestros resultados.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
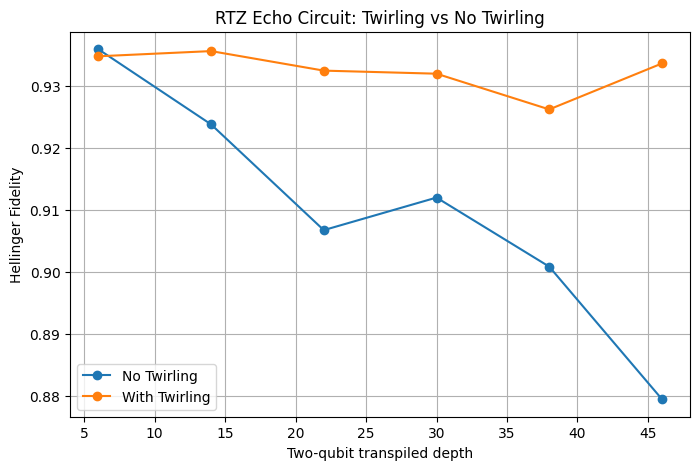
A lo largo de esta lección, hemos examinado casos en los que el Pauli twirling se utiliza para limitar la acumulación de error coherente, un contexto en el que podría describirse como supresión de errores. Sin embargo, el Pauli twirling suele ser más útil como herramienta para remodelar el comportamiento del error, convirtiendo los errores coherentes en una forma más predecible y fácil de modelar. La utilidad de esto se hará más evidente en el contexto de técnicas de mitigación de errores como la extrapolación a ruido cero (ZNE), que dependen de un escalado de ruido razonablemente predecible. Esto se discute en la siguiente lección.