Mitigación de errores
Esta lección ofrece información de fondo sobre diversas técnicas de mitigación de errores para ayudarte a desarrollar intuición sobre cómo y cuándo conviene usarlas. Es importante tener en cuenta que las aplicaciones modernas de estas técnicas aprovecharán herramientas más sofisticadas, como Samplomatic, Shaded Lightcones y Executor. Esos flujos de trabajo se tratarán en lecciones posteriores.
Este video ofrece una visión general de las técnicas de mitigación de errores. El texto que sigue añade más detalle y explora estos métodos usando Qiskit.
Visión general de las técnicas de mitigación de errores
La mitigación de errores se refiere a cualquier proceso que intenta reducir los efectos de los errores en los cálculos cuánticos una vez que ya se han producido. Es distinta de la supresión, que intenta evitar los errores, y de la corrección de errores, que codifica información en muchos qubits físicos y comprueba la coherencia de esa información para preservarla en un único qubit lógico. A lo largo de esta lección, las técnicas de mitigación de errores se entienden mejor como métodos para construir mejores estimadores de valores esperados ideales o mejores muestreadores de distribuciones de probabilidad, no como métodos para corregir estados cuánticos durante la ejecución. Examinaremos a continuación los métodos de mitigación de errores, todos disponibles en Qiskit y en sus addons, y que son herramientas prometedoras en la búsqueda de la ventaja cuántica.
La extinción de errores de lectura con twirling (TREX) aleatoriza el proceso de medición aplicando operaciones de Pauli elegidas al azar antes de la medición y deshaciendo después, de forma clásica, sus efectos conocidos sobre las cadenas de bits observadas. Bajo supuestos adecuados sobre el ruido de medición, esto convierte el canal de error de lectura en una forma más simple y simétrica, que es más fácil de calibrar y mitigar.
La mitigación de medición sin matrices (M3) es una técnica escalable de mitigación de errores de medición que evita construir explícitamente la matriz de asignación o su inversa.
La extrapolación a ruido cero (ZNE) aproxima el valor que tendría un observable en ausencia de ruido escalando artificialmente el ruido por un factor conocido y extrapolando de vuelta al caso sin ruido. Esto requiere que el ruido escale de forma predecible. Esa previsibilidad podría requerir otros métodos tratados en esta lección (estiramiento de pulsos, plegado de puertas y amplificación probabilística de errores (PEA)).
La cancelación probabilística de errores (PEC) es una de las técnicas de mitigación de errores más potentes, pero también de las más costosas computacionalmente. Funciona aprendiendo el comportamiento del ruido del sistema e intentando deshacerlo construyendo estadísticamente una estimación insesgada del cálculo ideal. PEC produce observables corregidos estadísticamente, no resultados corregidos de errores.
Ahora profundizaremos en cada uno de estos métodos.
M3
Los errores de medición son una de las fuentes de ruido más persistentes y específicas del hardware en los dispositivos cuánticos de corto plazo. Incluso cuando un estado cuántico se prepara y evoluciona correctamente, el paso final de lectura puede informar mal del resultado real en la base computacional. Estos errores surgen de una discriminación imperfecta entre los estados físicos correspondientes a y , de la relajación durante la medición y de imperfecciones en la electrónica de medición. Como resultado, la distribución observada de cadenas de bits suele ser una versión distorsionada de la distribución verdadera (ideal), con probabilidad reasignada incorrectamente entre resultados.
La mitigación de medición aborda este problema modelando explícitamente cómo se asignan mal los resultados de medición. En la formulación estándar, este comportamiento se captura mediante una matriz de asignación , cuyos elementos representan la probabilidad de registrar el resultado cuando el verdadero estado de la base era . Si el ruido de medición es clásico y estacionario, el vector de probabilidades observado se relaciona con la distribución ideal mediante una simple relación lineal,
Ten en cuenta que la matriz de asignación es una aplicación estocástica clásica, no un canal cuántico. Actúa sobre lecturas clásicas, no sobre los estados cuánticos subyacentes que se muestrearon para obtener esas lecturas.
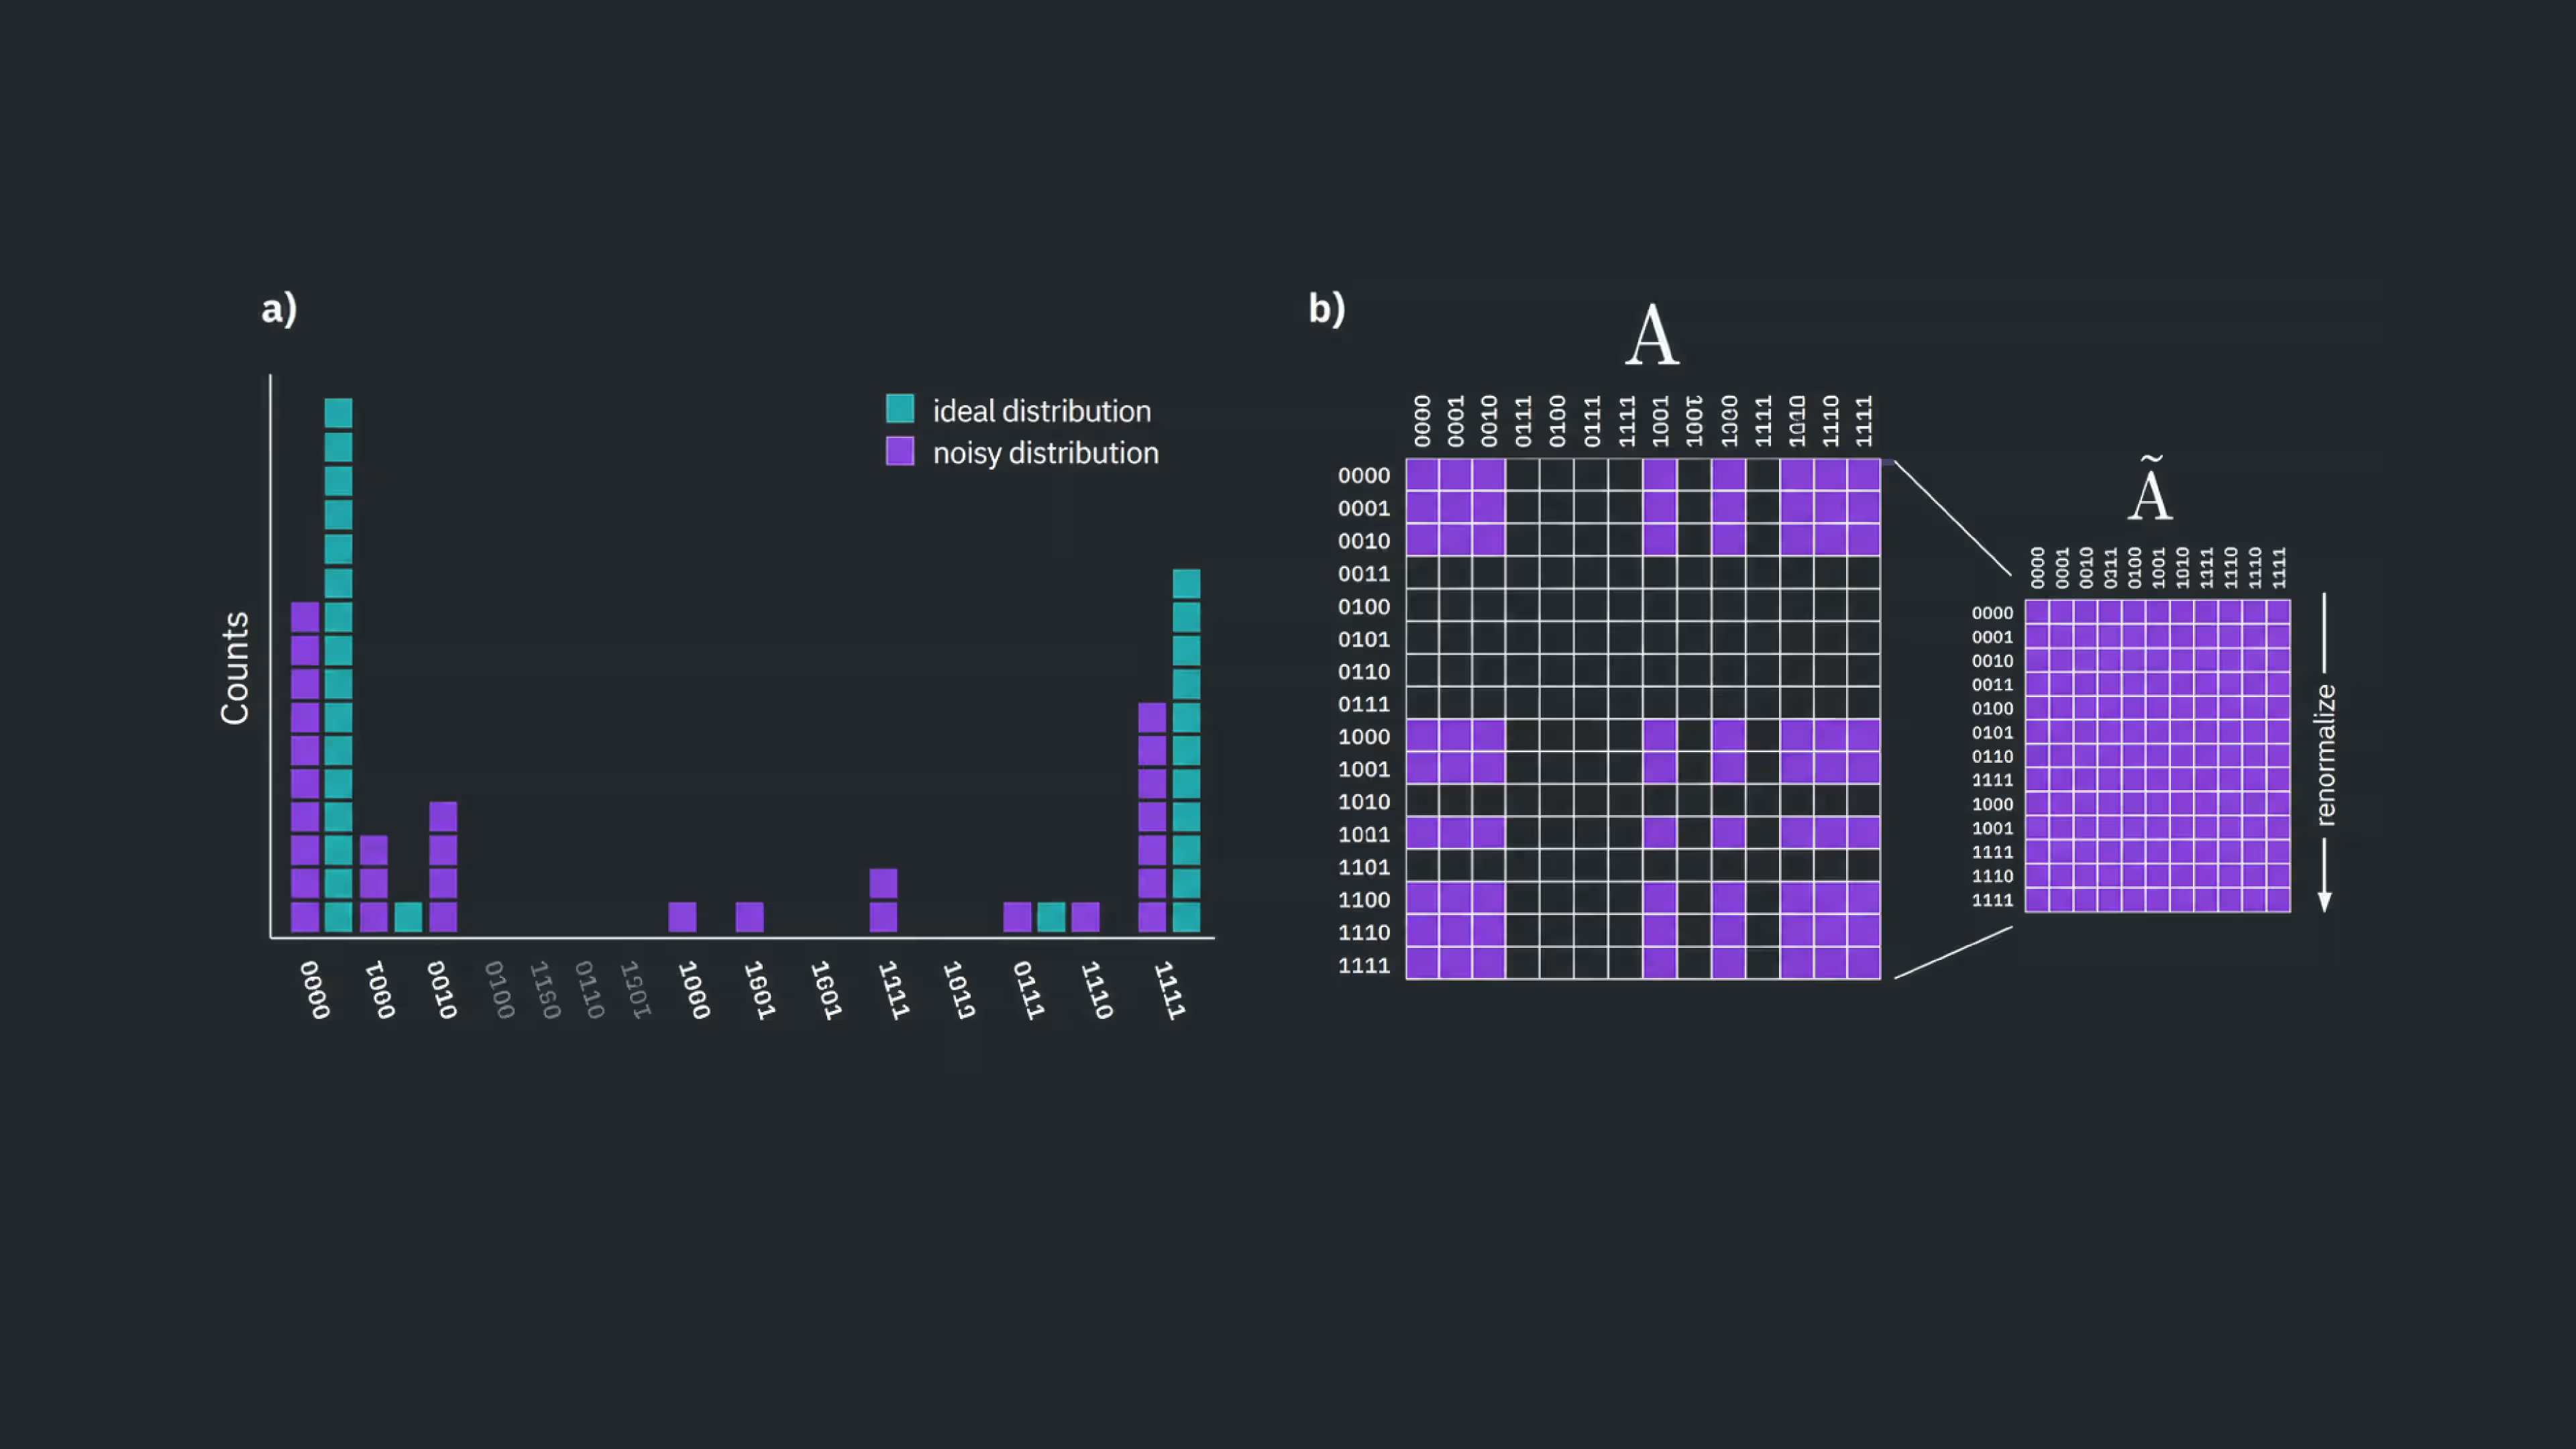
La mitigación de medición sin matrices (M3) usa esta estructura para construir una estimación mitigada de sin formar ni invertir nunca la matriz completa , algo inviable para números grandes de qubits. En su lugar, M3 aprovecha que muchas cargas de trabajo cuánticas de corto plazo producen distribuciones muy picudas o de baja entropía, de modo que la mitigación se centra solo en el subconjunto de resultados que contribuyen de forma significativa a la distribución observada.
Para construir el modelo de asignación, deben ejecutarse experimentos de calibración adicionales en el hardware cuántico. Normalmente consisten en preparar estados conocidos de la base computacional y registrar cómo los informa el sistema de medición. La sobrecarga de calibración escala con el número de qubits medidos, mientras que el coste computacional de la mitigación depende de la estructura de la distribución observada. Este coste es mucho menor que el necesario para caracterizar explícitamente la matriz de asignación completa de . Aunque esta sobrecarga de calibración es real, es ligera en comparación con técnicas a nivel de circuito como la extrapolación a ruido cero o la cancelación probabilística de errores, lo que hace de M3 una herramienta práctica y muy utilizada para mitigar errores de lectura en experimentos cuánticos de corto plazo.
Ten en cuenta que la calibración solo es útil en la medida en que el proceso de medición se mantenga suficientemente estable entre las ejecuciones de calibración y el experimento objetivo.
Primero realizaremos a mano un caso simple para ilustrar cómo funciona; después usaremos las herramientas integradas en Qiskit para mostrar el uso de M3 a una escala más realista.
Ejemplo pequeño de M3
Empezamos construyendo un estado de Bell simple.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Podemos usar un simulador con un modelo de ruido porque limitamos este ejemplo a un circuito muy pequeño. Configuramos explícitamente nuestro modelo de ruido para que tenga un error de lectura de la forma:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Estas tasas de error de lectura son mucho más altas que las que se ven en los ordenadores cuánticos reales de IBM®. Los valores altos se han elegido por motivos pedagógicos, para que podamos ver con claridad el efecto de M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Podemos ejecutar el circuito en el simulador con ruido para observar los efectos del error de lectura.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
En nuestro ejemplo de juguete, definimos nosotros el error de lectura para nuestro modelo de ruido. Pero al usar un ordenador cuántico real, el error de lectura no se conoce a priori. En su lugar, debe estimarse experimentalmente. Para ello, creamos circuitos que preparan un qubit en un estado conocido de la base computacional, o , y lo medimos. En ausencia de error de lectura mediríamos exactamente el estado preparado. Al recopilar estadísticas de estas mediciones, podemos construir una matriz de asignación que describa el error de lectura. En este ejemplo de juguete, debería ser similar a la que definimos.
En un sistema más realista, habría que acumular estadísticas para cada qubit físico. Esto a veces no es trivial, porque la transpilación asigna un circuito abstracto al hardware y el número del qubit cambia. Volveremos a ello en el siguiente ejemplo. En este ejemplo con simulador, asignamos el mismo modelo de error de lectura a todos los qubits, por lo que basta una única caracterización.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Observa que esta matriz es muy parecida a la matriz de error de lectura usada para construir el simulador.
De nuevo, en un ordenador cuántico real tendríamos estadísticas como estas para varios qubits físicos. Para este simulador, suponemos que los dos qubits tienen errores de lectura idénticos e independientes, lo que nos permite construir la matriz de asignación de dos qubits A_2q como producto tensorial de las correspondientes matrices de un qubit. Ten en cuenta también que el objetivo de M3 no es construir la matriz de asignación completa. En cambio, M3 se centra en el subconjunto de resultados que contribuyen de forma significativa a la distribución observada. Construiremos la matriz completa para nuestro ejemplo muy pequeño para ver cómo funciona. La implementación de M3 en qiskit-ibm-runtime es más sofisticada que este ejemplo de juguete porque debe manejar muchos qubits con características de lectura distintas y, aun así, evitar construir la matriz de asignación completa.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Para este ejemplo suponemos que los errores de lectura en distintos qubits son independientes, lo que permite construir la matriz de asignación de dos qubits como producto tensorial de las correspondientes matrices de un qubit.
Obtenemos los resultados sin procesar y los mitigados para compararlos.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
En este punto, hemos caracterizado experimentalmente cómo el proceso de medición distorsiona las probabilidades de los resultados ideales. Nuestro objetivo ahora es deshacer esta distorsión y aplicar la corrección resultante a las probabilidades sin procesar.
Como estamos realizando una inversión lineal en lugar de una corrección física, las "probabilidades" resultantes no siempre tienen por qué ser positivas. Son esperables cuasiprobabilidades negativas muy pequeñas, que reflejan el hecho de que la mitigación de medición produce un estimador en lugar de una distribución de probabilidad física.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Las convertimos a conteos para representarlas gráficamente.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Por último, observamos las distribuciones sin procesar, mitigada e ideal. Los "conteos" mitigados que aparecen abajo son solo una ayuda de visualización obtenida al reescalar las cuasiprobabilidades mitigadas.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
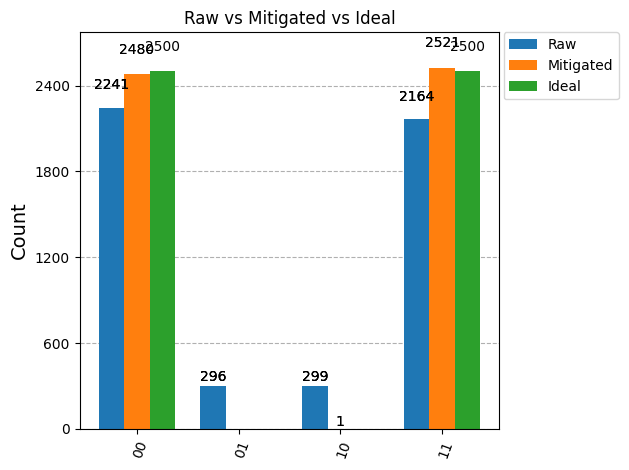
Claramente, los resultados mitigados con M3 se acercan mucho más a las distribuciones ideales, y podemos ver por qué.
Aplicar M3 a flujos de trabajo más realistas es mucho más complejo. Considera:
- Los ordenadores cuánticos reales contienen muchos qubits físicos, cada uno con sus propias características de error de lectura. Estos errores deben modelarse y combinarse de forma adecuada.
- La matriz de asignación completa crece exponencialmente con el número de qubits y rápidamente se vuelve impracticable construirla explícitamente. Por eso M3 se centra en el subconjunto de resultados que contribuyen significativamente a la distribución observada en lugar de construir la matriz de asignación completa.
- En los problemas reales de interés, puede que la distribución ideal no se conozca.
Por todas estas razones, el flujo de trabajo de mitigación completo está encapsulado en el addon de Qiskit mthree.
Ejemplo más grande de M3
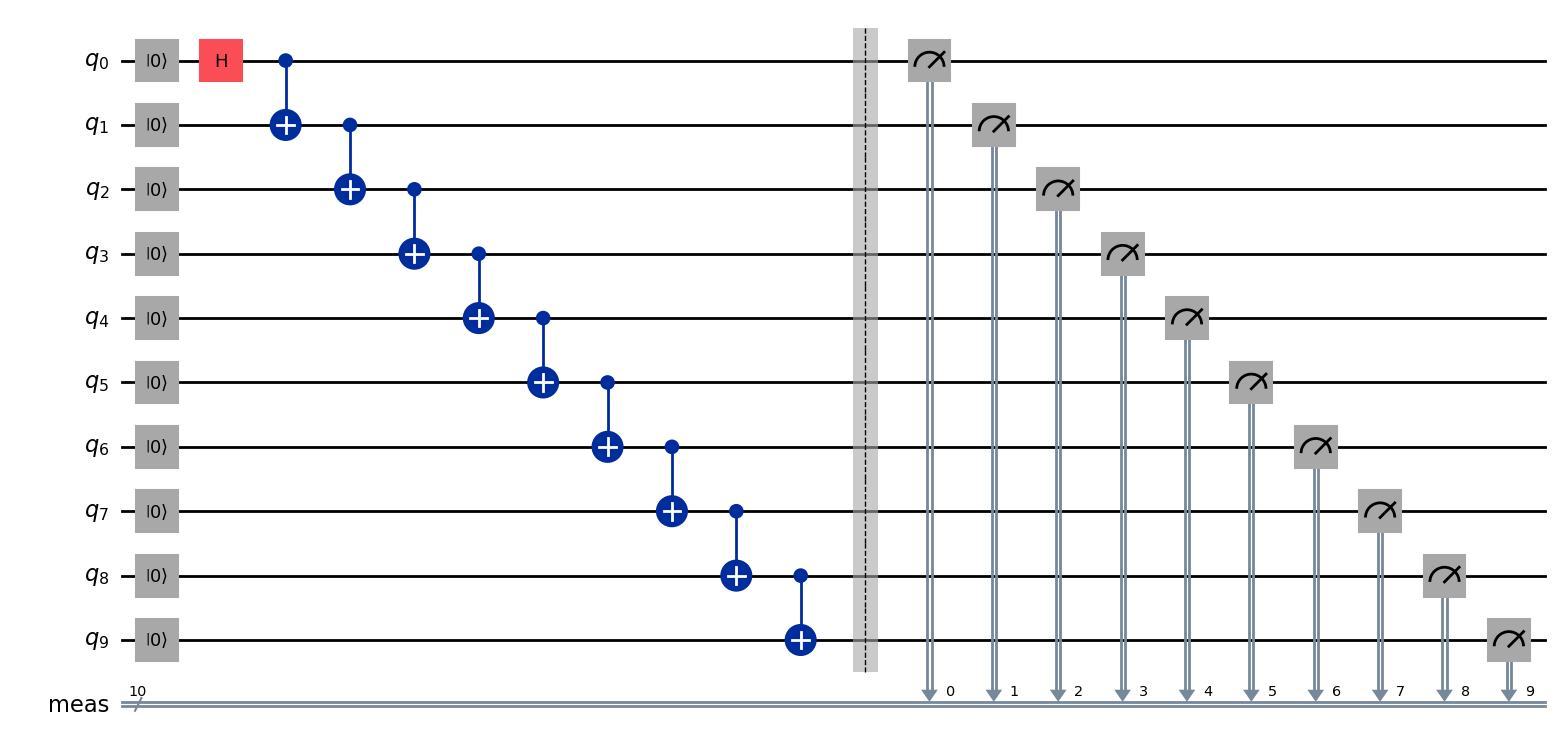
Ahora aplicamos M3 a un circuito más grande, uno para el que determinar a mano el subespacio relevante de sería engorroso, pero que sigue siendo lo bastante simple como para conocer la distribución ideal: un estado GHZ. Empezamos importando el paquete mthree y definiendo un circuito cuántico GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
Para ejecutar esto en un ordenador cuántico real, importamos qiskit_ibm_runtime y otros paquetes necesarios. Usamos SamplerV2 para obtener una distribución de salidas.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Ahora transpilamos el circuito para nuestro backend. Aquí fijamos el nivel de optimización en 0 para centrarnos en los efectos de M3, sin añadir herramientas adicionales. Esto significa que la fidelidad final no será representativa de lo que se puede lograr en el hardware de IBM Quantum® usando el conjunto completo de herramientas disponibles, pero nos permite centrarnos específicamente en la utilidad de M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Ahora configuramos el Sampler, de nuevo desactivando técnicas adicionales de supresión de errores como el desacoplamiento dinámico y el twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Por último, ejecutamos nuestro trabajo.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Podemos extraer los conteos sin procesar del circuito anterior.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Ahora ejecutamos mthree en nuestro backend para caracterizar el modelo de asignación usado en la mitigación de medición. Reescalamos la distribución sin procesar usando esa información. Ten en cuenta que esto a veces puede dar lugar a probabilidades negativas muy pequeñas (de ahí el término cuasiprobabilidades).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
La corrección de mthree produce cuasiprobabilidades, en lugar de conteos. Podemos reescalar a conteos a mano. La función auxiliar siguiente convierte a conteos y redondea a valores enteros. Además, en circuitos grandes habrá muchas cadenas erróneas con muy pocos conteos, pero que saturan un histograma. La segunda función auxiliar siguiente recorta las cadenas con menos conteos que un umbral que elijamos, para darnos una vista clara de los términos dominantes de la distribución.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
También podemos producir fácilmente la distribución teórica ideal, en la que los estados de todo ceros y de todo unos tienen la misma probabilidad y el resto de resultados tienen probabilidad cero, para compararla.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Por último, podemos visualizar nuestros resultados.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
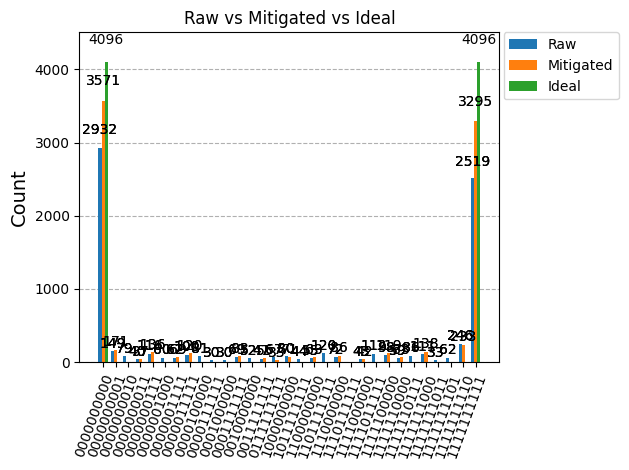
Los resultados mitigados están más cerca de la distribución ideal que los no mitigados. Podemos cuantificarlo mejor usando los conteos de las cadenas de bits ideales.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Esta herramienta simple mejoró nuestra fidelidad un 26 % respecto a la fidelidad sin mitigar, con una sobrecarga bastante baja. Claramente, M3 puede ser muy valioso. Pero el circuito GHZ se eligió como un buen caso de uso porque está muy concentrado en dos estados de salida. Algunos problemas producen conteos distribuidos de forma más uniforme (estados de alta entropía). En circuitos muy profundos con muchos qubits, los errores de puertas y el ruido no relacionado con los errores de medición suelen dar lugar a un estado de alta entropía. En tales casos, M3 opera en un espacio de estados bastante grande. Hay tres enfoques posibles:
(1) Aceptar que esta es una limitación de M3.
(2) Ten en cuenta que el límite superior del espacio de la matriz formada por M3 es num_shots num_shots, en lugar de , siendo el primero mucho menor para un número grande de qubits .
(3) Solo con mucha cautela, eliminar las cadenas de bits de probabilidad muy baja de los conteos sin procesar que se pasan a M3. Esto puede introducir sesgo, y la limitación del soporte de tus estados puede interferir con la convergencia en enfoques como el método de Krylov. Esto solo debe hacerse cuando sepas exactamente por qué lo haces y puedas anticipar todos sus efectos. Por eso este recorte no es una función integrada de M3.
Para más información sobre el addon de Qiskit mthree, consulta ejemplos, instrucciones de instalación, antecedentes y referencias de la API en su documentación.
Extinción de errores de lectura con twirling (TREX)
La extinción de errores de lectura con twirling (TREX) es una técnica de mitigación de errores de medición utilizada en los ordenadores cuánticos modernos. Su objetivo es eliminar el sesgo introducido por los errores de lectura clásicos sin requerir la caracterización completa ni la inversión de la matriz de asignación de medición.
TREX no es corrección de errores y no mejora la fidelidad del estado. En su lugar, garantiza que los estimadores de valores esperados sean insesgados respecto al ruido de lectura, salvo error estadístico, promediando sobre bases de medición aleatorizadas y reescalando. En el hardware de IBM Quantum, TREX es el método de mitigación predeterminado para la estimación de valores esperados y corresponde a resilience_level = 1 en la primitiva Estimator de IBM Quantum.
Naturaleza de los errores de lectura en hardware superconductor
En los qubits superconductores de IBM, los errores de lectura están dominados por:
-
Probabilidades asimétricas de cambio de bit (por ejemplo, con más frecuencia que lo contrario)
-
Relajación dependiente del estado durante la propia medición
-
Diafonía leve pero no despreciable entre resonadores de lectura vecinos
Es importante señalar que estos errores a menudo pueden modelarse como un proceso estocástico clásico que actúa sobre los resultados de medición. TREX aprovecha una idea estándar del ajuste del ruido: la aleatorización (twirling) del procedimiento de medición. TREX normalmente procede en dos etapas:
-
Twirling y "destwirling" clásico
-
Reescalado de los valores esperados usando circuitos de calibración
Supongamos que el valor esperado de un observable se relaciona con estimaciones ruidosas, como la siguiente:
donde es un factor fijo que escala la estimación y es un sesgo procedente de las fuentes descritas arriba. Usamos aquí como recordatorio de que solo estamos abordando el error de lectura; todavía hay que considerar el error de las puertas.
Justo antes de la medición, cada qubit se conjuga aleatoriamente con un operador de Pauli (como I o X). Los resultados de medición se "destwirlean" de forma clásica después.
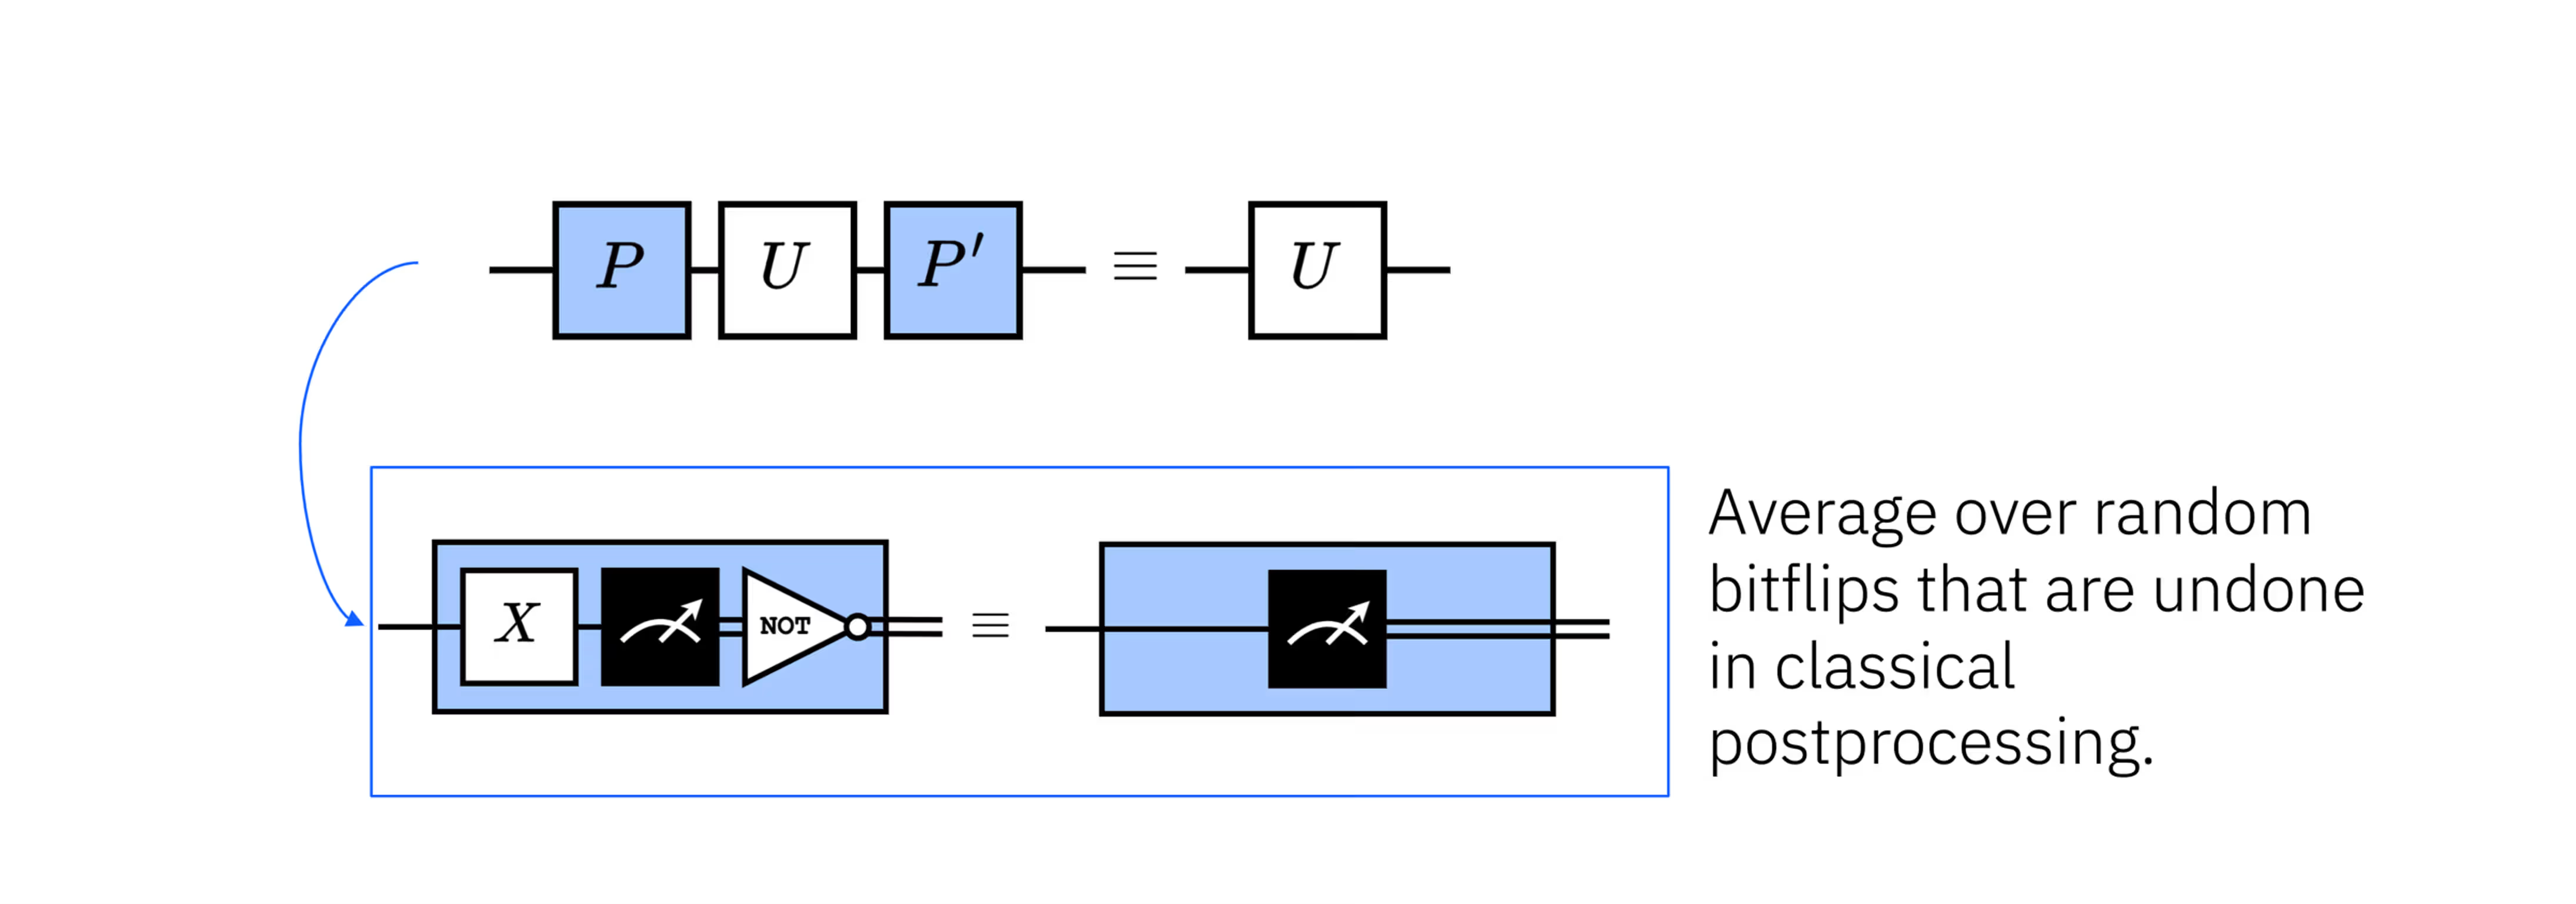
Promediar sobre estas aleatorizaciones simetriza el canal de lectura. Como resultado, las asimetrías sistemáticas del proceso de lectura se convierten en un canal de error más simétrico cuyo efecto restante puede tratarse mediante calibración y reescalado. En términos simples, si, por ejemplo, hubiera un sesgo hacia el estado , nos faltarían algunas mediciones de . Al aplicar twirling alrededor de la medición, intercambiamos aleatoriamente qué resultado lógico se asocia al proceso de lectura física y luego deshacemos ese intercambio de forma clásica. Promediar sobre muchas de estas mediciones aleatorizadas elimina la preferencia sistemática por uno de los resultados informados frente al otro. Esto elimina el sesgo de medición dominante bajo los supuestos del modelo TREX, de modo que tenemos:
Sin embargo, los valores esperados aún pueden necesitar reescalarse. La segunda etapa consiste en usar circuitos de calibración (circuitos con resultados conocidos) para estimar el factor de escala . Este puede usarse después para obtener una estimación muy mejorada.
Los valores esperados de los observables de Pauli pasan a ser estimadores insesgados de sus valores ideales. No se aprende ni se invierte ningún modelo de ruido explícito, por lo que TREX es numéricamente estable y económico. De nuevo, aquí no se ha abordado el error de las puertas.
En la estimación de un valor esperado de un observable , puede haber varianza debida al muestreo finito, muchos tipos de errores incoherentes y coherentes, y también un sesgo, , debido al error de lectura. Este sesgo surge de fuentes como las transiciones asimétricas que hemos comentado. En la práctica, este sesgo suele modelarse bien como un canal estocástico clásico que actúa tras la evolución cuántica. TREX transforma el canal de medición efectivo de modo que el estimador de sea insesgado respecto al error de lectura. Esto es relativamente fácil de ver usando el ejemplo más simple de puertas de twirling: X. Si hay asimetría en frente a , pero intercambiamos aleatoriamente qué estado se lee (revirtiéndolo después de forma clásica), esto elimina obviamente la asimetría sistemática (aunque el muestreo finito siga implicando que puede haber una ligera asimetría estocástica en la medición). En la práctica, las puertas de twirling para TREX no se limitan a I y X, pero esto basta para una explicación.
TREX nos permite obtener una estimación de un valor esperado libre de sesgo debido al error de lectura. Aún podría haber un sesgo de otra fuente (como una sobrerrotación coherente); TREX apunta solo a la lectura. Como TREX sustituye el sesgo sistemático por una simetrización aleatorizada, en general convierte el sesgo en varianza estocástica adicional, aumentando la varianza del estimador a un coste de muestreo fijo.
Comprueba tu comprensión
Supongamos que usamos Estimator en un circuito que ha preparado el estado para estimar . Supongamos además que los errores de medición hacen que los resultados correspondientes a se informen como el 10 % de las veces, mientras que los resultados correspondientes a se informan como solo el 1 % de las veces. La asimetría entre estos errores de informe introduce un sesgo de medición.
(a) En ausencia de tales errores de medición, ¿cuál sería el valor esperado ideal del observable ?
(b) Con los errores de medición o de lectura asimétricos, ¿cuál es el valor esperado del observable ?
(c) Considera un conjunto limitado de puertas de twirling de Pauli: I y X. Supón que I y X se aplican aleatoriamente con un 50 % de probabilidad en múltiples shots. Se siguen aplicando las mismas tasas de error de medición. Después, la puerta de Pauli (I o X) se deshace de forma clásica. Haz una tabla con todos los resultados posibles y sus probabilidades debidas a la superposición inicial, los errores de medición asimétricos y las puertas de Pauli asignadas aleatoriamente.
(d) Usa la tabla para determinar el valor esperado con la estrategia de twirling.
(e) Compara los valores esperados: ideal, sin twirling y con twirling.
(f) ¿Qué se ha omitido en este tratamiento que sí se encuentra en una aplicación completa de TREX?
Respuesta
(a) Puedes usar simplemente la intuición y la simetría para decir que . Para demostrarlo explícitamente:
(b) El estado podría colapsar a o a al medirse, cada uno con un 50 % de probabilidad. Pero del 50 % que colapsa al estado , el 1 % (o el 0,5 % de todos los casos) se informará erróneamente como . Del 50 % que colapsa a , el 10 % (o el 5 % de todos los casos) se informará erróneamente como . Esto nos deja con:
- 54,5 %
- 45,5 % Ignorando todos los demás tipos de errores posibles, obtendríamos una estimación de
(c)
| Pauli | Resultado de medición ideal | Resultado tras Pauli | Error de lectura | Deshacer Pauli | Resultado final informado | Probabilidad |
|---|---|---|---|---|---|---|
| I | 0 | 0 | None | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | None | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | None | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | None | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) De las partes anteriores conocemos los valores esperados de Z en cada uno de los estados finales. Solo necesitamos calcular el promedio ponderado:
(e) En este caso tan simple, nuestra aplicación de twirling recuperó exactamente el valor esperado ideal. Eso no es lo habitual. Lo habitual es que el twirling deshaga sesgos como los introducidos por transiciones asimétricas y devuelva un valor esperado más cercano al ideal.
(f) Esta es una aplicación de un modelo de juguete. Podrían faltar varias cosas. En particular, aquí no hemos ejecutado circuitos de calibración para estimar un factor de reescalado . Esto normalmente es necesario.
Detalles de implementación
TREX se aplica automáticamente al usar la primitiva EstimatorV2 con resilience_level = 1 (el valor predeterminado). Ten en cuenta que no se aplica automáticamente a la primitiva Sampler, porque Sampler devuelve distribuciones de probabilidad completas en lugar de valores esperados.
Cuando TREX está habilitado, el runtime genera variantes del circuito con twirling de medición insertando Paulis aleatorios de un solo qubit inmediatamente antes de la medición. El posprocesamiento clásico revierte estos Paulis. Estas variantes del circuito son aleatorias entre distintos shots y también entre distintos qubits dentro de un shot. Después, todas las variantes del circuito se combinan en un único estimador.
TREX es muy escalable. Requiere circuitos de calibración adicionales, de modo que la sobrecarga de muestreo suele ser un pequeño factor constante (a menudo 2-4x). Pero la mitigación es específica del observable, no preserva la distribución.
TREX está diseñado para integrarse limpiamente con muchos métodos de supresión y mitigación de errores, entre ellos los siguientes:
-
Desacoplamiento dinámico (DD): actúa durante los tiempos de inactividad, ortogonal a la mitigación de lectura.
-
Twirling de puertas o de Pauli: a menudo complementario; TREX ya se basa en el twirling, pero apunta solo al ruido de lectura.
-
Extrapolación a ruido cero (ZNE): ZNE apunta al ruido de las puertas, mientras que TREX gestiona el sesgo de medición. Esta combinación se usa en el nivel de resiliencia 2.
-
Amplificación probabilística de errores y cancelación probabilística de errores en flujos de trabajo de Estimator.
Sin embargo, algunos métodos no pueden (o no deberían) combinarse con TREX:
-
Corrección de probabilidades a nivel de Sampler: TREX no devuelve probabilidades corregidas de cadenas de bits.
-
Mitigación posterior sobre datos ya mitigados con TREX: la doble corrección puede reintroducir sesgo.
Combinar TREX con una mitigación de lectura basada en matrices de asignación como M3 es complicado. M3 asume un canal de medición fijo. TREX aleatoriza deliberadamente la medición, lo que invalida la suposición que usa M3. En ese sentido, no se pueden combinar estas técnicas sin más. Sin embargo, si aplicas twirling de medición durante la calibración que se usa en M3, quizá puedas aprovechar a la vez un enfoque similar al de la matriz de asignación y un enfoque de mitigación por twirling (aunque este enfoque de twirling no es exactamente igual que TREX). Este es un tema recurrente al combinar técnicas de mitigación y supresión: sumar técnicas a ciegas falla; sumarlas con cuidado, de modo que se "reconozcan" entre sí, puede funcionar y resultar muy beneficioso.
TREX solo garantiza valores esperados libres de sesgo debido a errores de lectura; no reduce la varianza ni protege contra otros tipos de sesgo. Ciertamente no corrige todos los errores. Sin embargo, suele suponer una mejora sustancial y se logra con una sobrecarga mucho menor que la de otros métodos que requieren aprender modelos de ruido completos. TREX suele ser la mitigación de lectura más barata y robusta disponible, lo que la convierte en una excelente opción predeterminada en los experimentos.
TREX con Qiskit
Aquí creamos un circuito sencillo de dos qubits y usamos Estimator para estimar el valor esperado de un observable muy simple, ZX. El valor esperado ideal es 1. Compararemos los valores esperados con y sin TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Crea el circuito cuántico simple.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpila el circuito usando un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Aplica al observable el mismo layout obtenido de la transpilación.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Ejecuta el experimento en un ordenador cuántico real. Primero procedemos con reslience_level = 1; este es el valor predeterminado, pero lo hemos hecho explícito para distinguir los dos casos.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Ahora establecemos resilience_level en 0 para ejecutar sin TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
El valor esperado está sustancialmente más cerca del ideal (1) con TREX, como era de esperar. Por supuesto, se trataba de un único valor esperado sobre un único qubit. Ahora preparamos un circuito con puertas no Clifford y muchos qubits para comprobar si la mejora de TREX se mantiene robusta en un contexto distinto.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Aquí, el ángulo de rotación no tiene nada de especial. Simplemente elegimos una superposición desigual cualquiera de y para sondear los efectos de las transiciones erróneas asimétricas y cómo las trata TREX. Dado este estado, el valor esperado ideal de Z en cada qubit, en ausencia de cualquier error (de lectura o de otro tipo), sería:
Por lo tanto, esperamos obtener valores esperados cercanos a -0.924 en todos los qubits. Veremos si TREX mejora cada valor esperado individualmente y también si mejora el promedio de todos los qubits.
Comprueba tu comprensión
Verifica el valor esperado anterior mediante un cálculo directo.
Respuesta
Transpilamos usando un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Ahora construimos un observable por qubit para poder estimar los veinte valores esperados en un único flujo de trabajo. Es decir, para el qubit , queremos un observable con todas las identidades , excepto en la posición , donde queremos una . Recuerda aplicar también a tus observables el layout transpilado.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Ahora podemos ejecutar. La celda de código siguiente usa session mode; si no tienes acceso a sesiones, puedes reemplazarlo por batch mode para ejecutar el mismo flujo de trabajo, pero con posibles tiempos de cola entre circuitos.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Aquí comparamos los errores absolutos medios con y sin TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
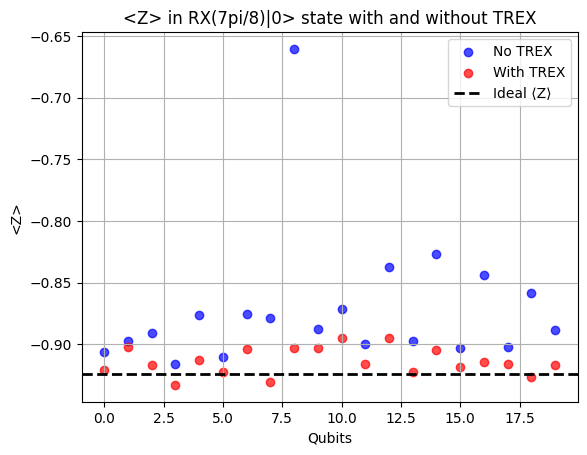
Sin duda TREX parece haber ayudado. El valor esperado en cada qubit ha mejorado, con la única excepción del qubit 16. Es de esperar un valor atípico así. Podemos cuantificar la aplicación global de TREX al circuito tomando los valores promedio.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
En promedio, TREX acercó nuestros resultados un 2.9% a los resultados ideales y nos dejó un resultado que, en promedio, difiere del ideal teórico en solo un 0.4%. Es estupendo, y esta mejora de baja sobrecarga es precisamente la razón por la que TREX es la mitigación de errores predeterminada en Estimator. Pero debemos subrayar una vez más que TREX elimina un sesgo en el error de lectura, no corrige todos nuestros errores. Elegimos un estado inicial con buenas probabilidades de verse afectado por la asimetría en la lectura. El efecto habría sido distinto si hubiéramos preparado cada qubit en un estado diferente. Para un argumento trivial de por qué tiene que ser así, considera qué pasaría si dejáramos cada qubit en el estado fundamental . No habría oportunidad de observar (ni de corregir) una asimetría en el error de lectura entre los estados y .
Extrapolación a ruido cero (ZNE)
La extrapolación a ruido cero (ZNE) es una de las técnicas de mitigación de errores más utilizadas. La estrategia general también es fácil de entender, aunque los detalles de su implementación son complejos. ZNE funciona de la siguiente manera:
-
Ejecuta un circuito objetivo con múltiples "niveles de ruido" — modificaciones del circuito que hacen que su ruido escale de forma predecible
-
Estima el observable de interés para cada escala de ruido.
-
Extrapola de vuelta a ruido cero mediante un modelo de ajuste (lineal, polinómico, exponencial, etc.).
El resultado es una estimación de cuál habría sido el observable en el límite de ruido cero implícito en el modelo de extrapolación.
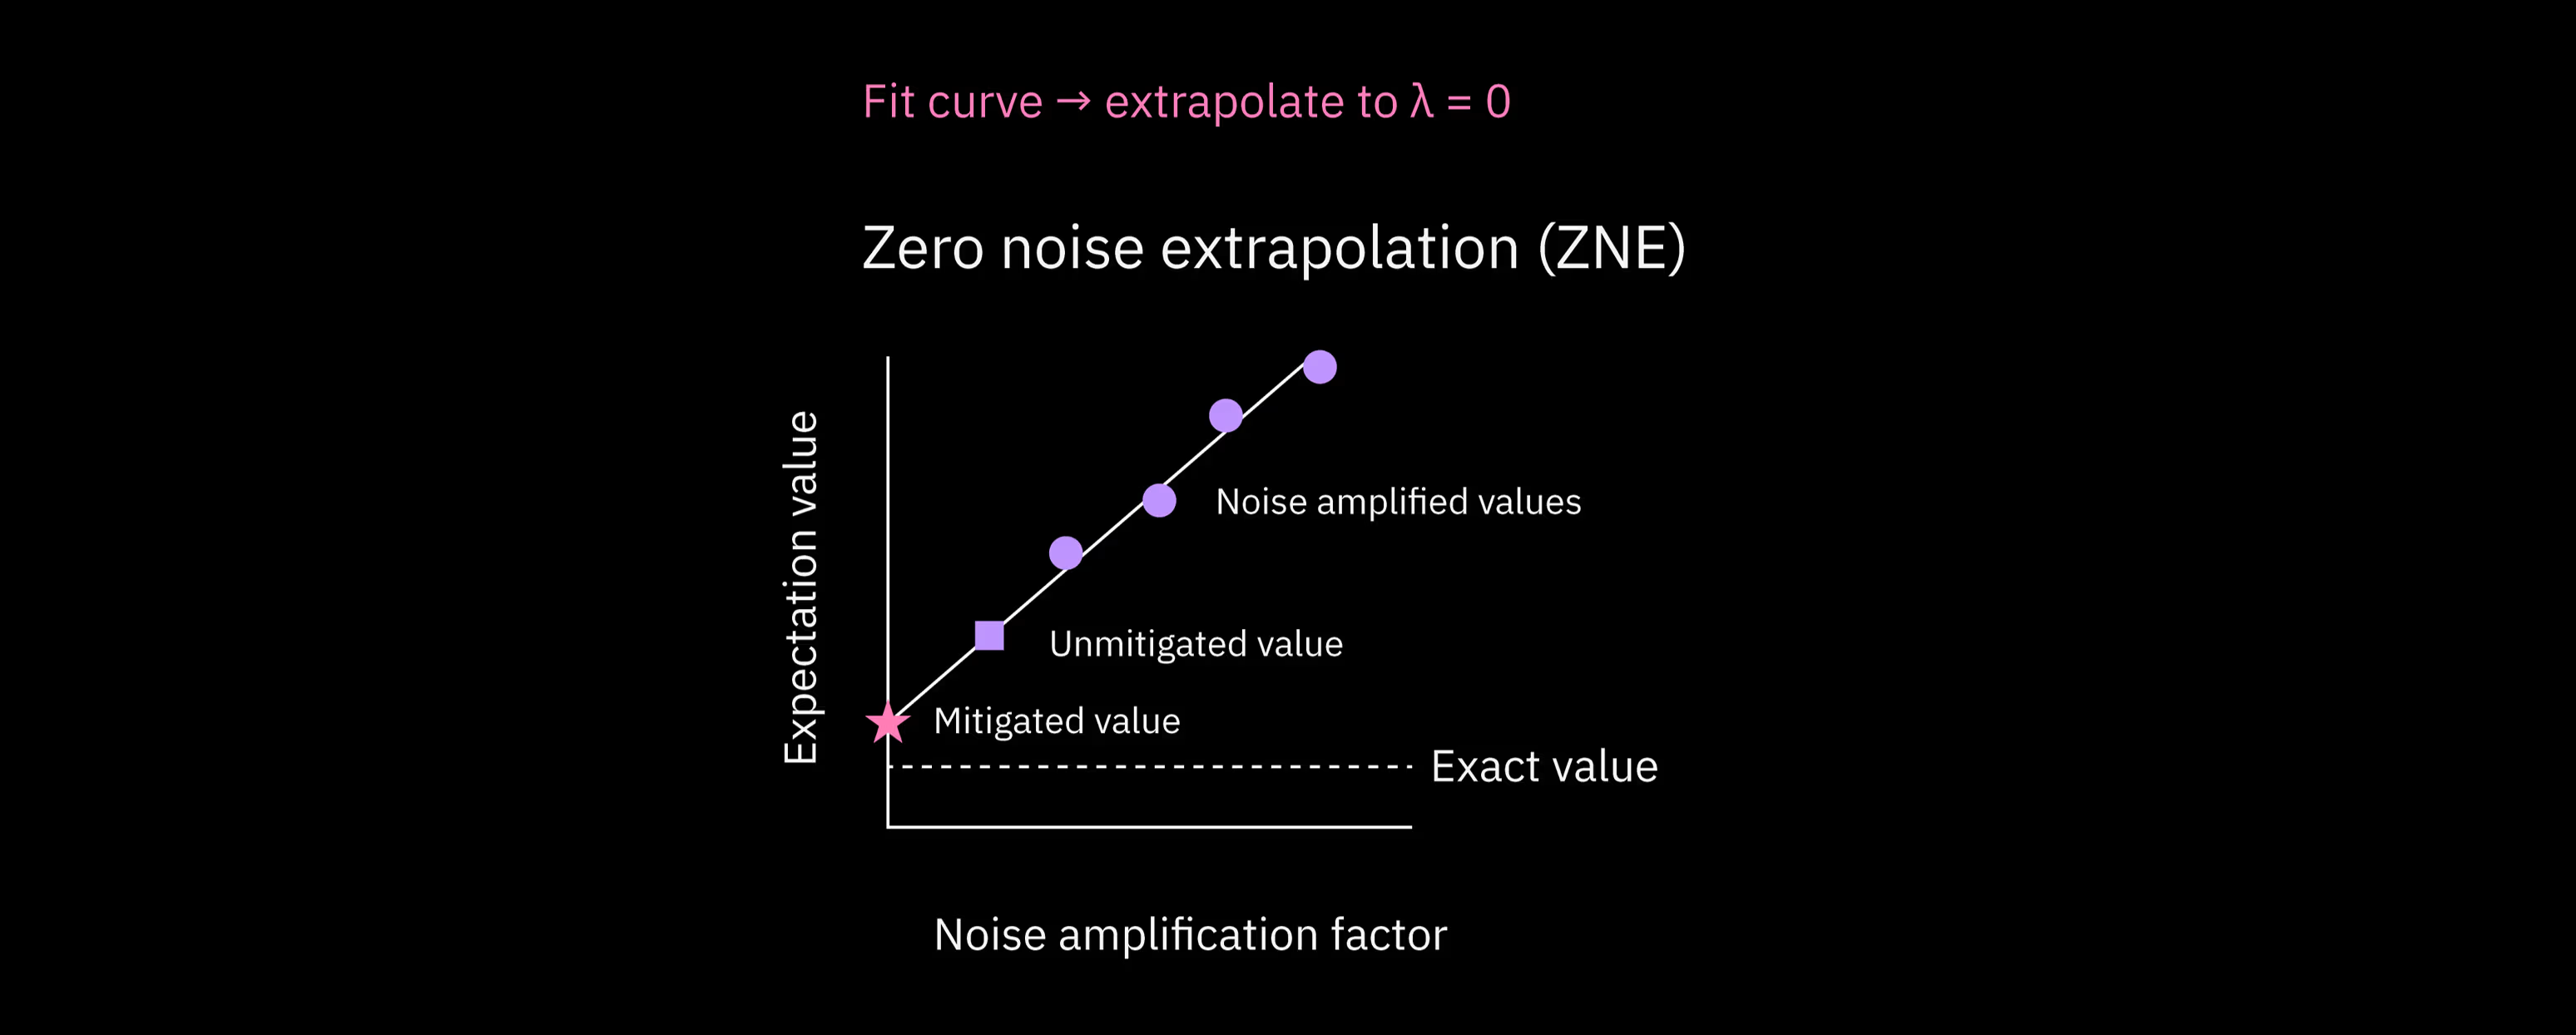
ZNE no garantiza que el ruido aumente de forma suave o lineal a medida que modificamos los circuitos. En cambio, asume que el escalado del ruido se comporta lo bastante bien como para permitir la extrapolación. La complejidad de ZNE reside en cómo se modifican los circuitos para satisfacer esta suposición lo mejor posible. Examinaremos algunos enfoques en esta lección.
Escalado de recursos en ZNE
En ZNE, la sobrecarga es principalmente sobrecarga cuántica. Es decir, para obtener valores esperados en niveles de ruido, tienes que realizar tu experimento en circuitos, cada uno con muchos shots. Para mantener una precisión estadística fija, el número total de muestras suele aumentar a medida que se introducen más circuitos con ruido escalado.
El número de niveles de ruido que examines, , dependerá del método usado para escalar el ruido. Para una técnica sencilla de escalado de ruido (llamada "gate-folding", que se explica más abajo), suele estar entre 3 y 5. Un método diferente (amplificación probabilística del ruido (PNA)) permite factores de ruido no enteros y normalmente produce niveles de ruido más bajos que el gate-folding. La sobrecarga total escala aproximadamente como:
donde es el número de shots de referencia. Otra cosa que debes tener en cuenta es que, si el escalado del ruido implica puertas repetidas, la profundidad del circuito podría aumentar en un factor proporcional al valor de escalado del ruido. El escalado del ruido que acompaña al aumento de profundidad es justamente el objetivo, pero ten presente la profundidad total.
ZNE es muy adecuada para problemas en los que se cumplen los siguientes puntos:
-
Necesitas un método de mitigación de propósito general que sea eficaz con muchos tipos de error.
-
La profundidad del circuito no es demasiado grande; ZNE falla cuando el circuito escalado se vuelve demasiado ruidoso para extrapolar.
-
Puedes tolerar una sobrecarga de tiempo de ejecución moderada a cambio de una mayor precisión.
En la práctica, esto hace que ZNE sea ideal para muchos circuitos variacionales, la estimación de valores esperados y otros algoritmos cuánticos de corto plazo. Está implementada en Estimator mediante resilience_level = 2. Ten en cuenta que ZNE extrapola en un espacio que tiene un único resultado en función del ruido a lo largo del circuito. Eso significa que se presta a problemas de estimación, pero no a problemas de muestreo. No está diseñada para funcionar con distribuciones de bitstrings.
Factores de ruido
¿Cómo podemos aumentar exactamente el nivel de ruido en un circuito? Hay dos formas principales, aunque existen muchas variantes.
-
Reemplaza una puerta o un bloque de puertas por . Como las puertas de los ordenadores cuánticos son unitarias, sabemos que , de modo que, lógicamente: . Sin embargo, cada repetición de o añade un error similar o idéntico, lo que nos permite aumentar los niveles de ruido/error. Ten en cuenta que el reemplazo mostrado arriba nos lleva del ruido original de la puerta (nivel de ruido 1) a tres veces ese nivel de ruido en (nivel de ruido 3). En la práctica, podemos repetir las dos últimas puertas veces: para obtener un nivel de ruido . Esto se llama gate folding y es una técnica de escalado de ruido muy común.
-
Existen otros métodos para aumentar el nivel de ruido, como la amplificación probabilística de errores (PEA). En PEA, primero se aprende un modelo de ruido adecuado para el circuito, normalmente expresado como un canal de Pauli. Después se amplifica el ruido muestreando una versión reescalada de este canal de ruido aprendido. Ajustando el muestreo, puedes escalar de forma continua la intensidad efectiva del ruido, incluso hasta valores no enteros.
En la práctica, el gate folding puede escalar los errores de forma muy fiable, pero también puede dar lugar a circuitos muy profundos. Si solo necesitas tres niveles de ruido (1, 3 y 5), significa aumentar la profundidad de tu circuito en un factor de 5 y aun así obtener resultados razonables. Por lo tanto, si tu circuito objetivo tiene una profundidad transpilada de dos qubits de 60 o más, PEA probablemente sea más adecuada que el gate-folding.
Las puertas se pueden plegar localmente (es decir, repites para cada puerta de dos qubits en cuanto aparece) o se pueden agrupar en un bloque de puertas y repetir el bloque (como las puertas ). A menudo el plegado local es preferible para las suposiciones que hace ZNE, pero ambos son posibles.
El tratamiento estadístico de los resultados con ruido escalado en ZNE tiene muchos matices. Por ejemplo, con cinco veces el nivel de ruido tus resultados tendrán sin duda mayor varianza y serán menos fiables. ¿Debería tratarse con el mismo peso que los puntos de datos de menor ruido? No. Sin embargo, para ver ZNE en acción, ignoraremos parte de esta complejidad en un experimento de modelo simplificado, en el que construiremos circuitos plegados a mano y haremos una extrapolación ingenua con ponderaciones iguales para ilustrar los pasos clave. Pero a continuación haremos un experimento con la funcionalidad de ZNE integrada en Qiskit y veremos que maneja bastante mejor la complejidad que estamos omitiendo.
ZNE a mano
Empezamos seleccionando un circuito cuántico y un observable para los que podamos calcular el valor esperado ideal en ausencia de ruido y errores. Elegimos un estado GHZ , con un número par de qubits. Nuestro observable es . Lo elegimos por varias razones:
- El valor esperado es trivial de calcular en el caso ideal. Como el número de qubits es par, obtenemos un
1de cada , multiplicados entre sí, o un-1de cada , multiplicados entre sí un número par de veces. - Será bastante sensible a errores y ruido, ya que un solo error en un qubit puede cambiar el resultado global de ese shot de +1 a -1.
- El valor esperado está lejos de 0. ZNE puede encontrar dificultades cuando el valor esperado ideal está muy cerca de cero, porque los niveles altos de ruido tienden a aleatorizar los resultados, haciéndolos positivos tan a menudo como negativos. El resultado es que los valores de ruido altos acabarán dando valores cercanos al ideal; esto puede hacer que la extrapolación sea muy complicada.
Con esta motivación en mente, construyamos nuestros circuitos.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Observa la sutileza de que aquí . Aunque se dijo que el gate folding consiste en operadores de la forma , aquí esa misma estructura se ve como CNOT CNOT CNOT.
Asegurémonos de que nuestro circuito es efectivamente el circuito GHZ normal:
ghz_amp[0].draw("mpl")
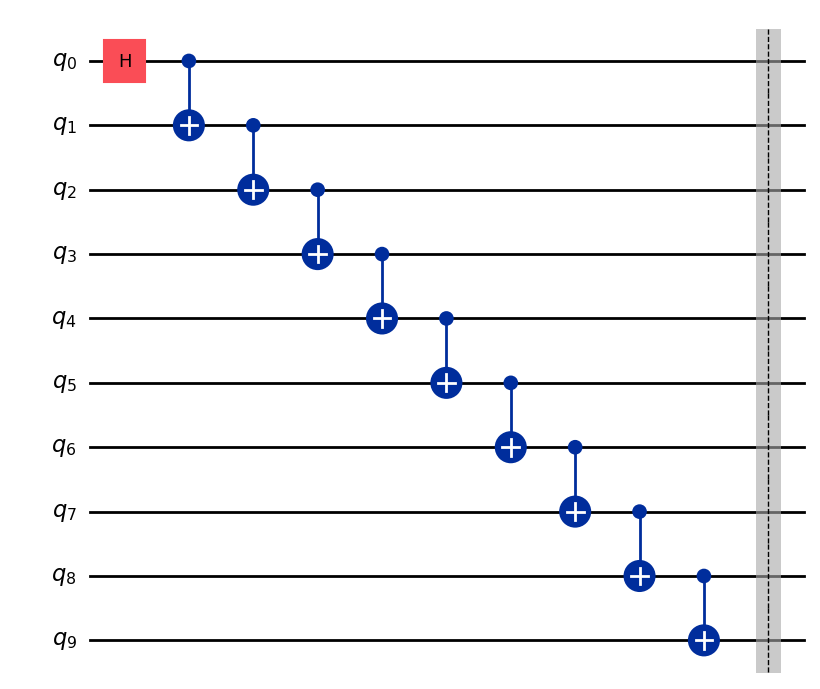
Puedes examinar los demás circuitos para verificar que tienen la estructura esperada.
Ahora construimos nuestros observables.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Construimos un pass manager y lo aplicamos a nuestros circuitos. Después tomamos los layouts y los aplicamos a nuestros observables.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Da formato a los pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Ahora ejecutamos Estimator. Queremos centrarnos en el papel de ZNE, por lo que podríamos establecer resilience_level = 0 para evitar confundir los efectos del twirling con el efecto de ZNE. Sin embargo, también queremos comparar nuestra ZNE "a mano" con los ajustes de ZNE integrados en Qiskit, que incluyen twirling. Por eso establecemos aquí resilience_level = 1. Establecer resilience_level = 2 invoca los ajustes de ZNE de Qiskit, que usaremos en breve.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Ahora imprimimos los niveles de ruido y los valores esperados.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Esta es la parte en la que somos más displicentes: hacemos un ajuste lineal a estos datos sin prestar atención a la varianza de cada valor obtenido y sin intentar predecir teóricamente si el ajuste debe ser lineal. De nuevo, la ZNE integrada hace un trabajo mucho mejor que lo que hacemos a mano.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Procedemos a graficar esto antes de interpretarlo.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
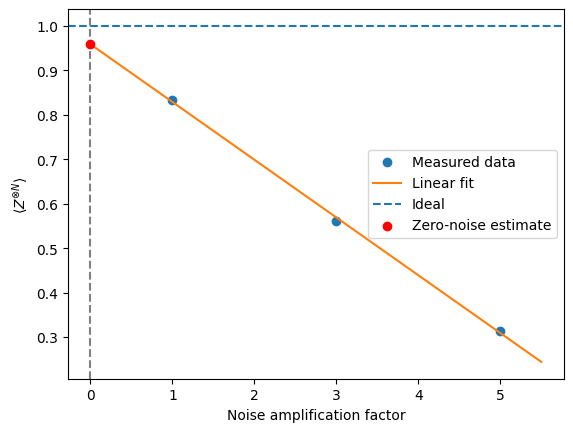
En el momento de crear esta lección, a partir de la extrapolación al caso de ruido cero obtenemos un valor esperado de 0.959. Tus valores pueden diferir. Esto es sustancialmente mejor que el valor esperado del circuito sin procesar, de 0.83, alrededor de un 13% más cerca del valor ideal. Pero también puedes ver que estamos usando un punto de datos en el que el valor esperado bajó hasta 0.31. Obviamente este punto de datos es de peor calidad. Si a ese punto se le hubiera dado menos peso en nuestra aproximación lineal y la recta se hubiera ajustado más a los dos primeros puntos, vemos que la estimación extrapolada a cero habría sido mayor (más cercana al valor ideal). Este tipo de consideración se maneja automáticamente en la ZNE integrada en Estimator.
ZNE integrada en Estimator
Ahora veamos qué sucede cuando usamos la funcionalidad de ZNE integrada en Estimator. Empezamos definiendo un circuito GHZ simple, sin ningún gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Definimos el mismo observable que antes.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Una vez más definimos un pass manager, usando optimization_level = 1. Volveremos a esta elección más adelante.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpila el circuito y aplica el layout a los observables.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Ejecutamos Estimator usando ZNE y twirling, y comparamos los resultados con nuestra implementación de ZNE a mano. En particular, los comparamos con el resultado sin ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Podemos recuperar los valores en cada factor de ruido con la sintaxis job_zne.result()[0].data.evs_noise_factors. Como antes, podríamos usar ingenuamente estos resultados para obtener un ajuste lineal y extrapolar al caso de ruido cero, pero el estimador con resilience_level = 2 ya ha hecho un mejor trabajo, teniendo en cuenta la varianza y otras consideraciones. A continuación mostramos lo que daría una extrapolación lineal y lo que dio realmente la ZNE integrada.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
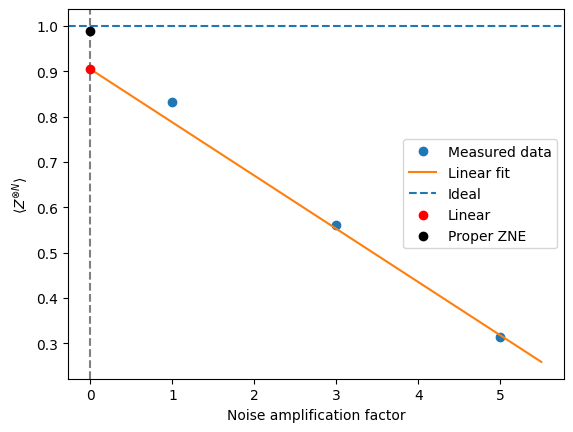
Vemos que la ZNE integrada mejoró nuestra estimación en más de un 15% y funcionó bastante mejor que nuestro intento a mano.
Antes de continuar, ten en cuenta que, a lo largo de esta exploración de ZNE, hemos establecido optimization_level = 1 en el pass manager. Los niveles de optimización más altos reducen el error, y a veces esa reducción puede hacer que los errores escalen de forma menos predecible. Como suele ocurrir, hay un equilibrio: reducir los errores, salvo cuando los aumentas intencionadamente en un factor conocido.
Combinación de métodos
ZNE se basa en lo siguiente:
-
Un parámetro de escalado del ruido bien definido
-
Un escalado de los valores esperados con suficientemente suave y predecible
-
El mismo canal de ruido efectivo, con diferentes intensidades
-
Ningún sesgo introducido que no escale con
ZNE se combina bien con técnicas que eliminan sesgos que no escalan (como M3) o que hacen el ruido más regular (como el twirling), pero entra en conflicto con técnicas que intentan cancelar el ruido por completo (PEC) o remodelarlo dinámicamente (DD).
En particular, M3 aborda únicamente el error de medición/lectura, que en la práctica puede tratarse como independiente de los errores de las puertas (que son el foco de los procesos de escalado de errores en ZNE). M3 es en gran medida independiente del gate folding; se puede combinar limpiamente con ZNE. TREX es muy similar y se puede combinar con ZNE.
El twirling de Pauli sí se centra en las puertas, a diferencia de M3 y TREX. Sin embargo, recuerda que el twirling de Pauli no mitiga directamente el error/ruido; más bien lo cambia para hacerlo más predecible. El twirling de Pauli podría ser beneficioso para el proceso de ZNE al hacer que los errores de las puertas escalen de forma más lineal y, por tanto, que la extrapolación sea más precisa.
El desacoplamiento dinámico (DD) es más matizado. DD altera dinámicamente el comportamiento del ruido cancelando parcialmente ciertos errores mediante la adición de secuencias de puertas. Si es posible construir los circuitos de modo que DD se comporte igual incluso cuando se pliegan puertas o bloques, en principio se podrían combinar ZNE y DD, pero en la práctica DD a veces interfiere con el escalado. Si quieres combinarlos, algunas cosas que debes considerar son las siguientes:
- ¿Se aplica DD de forma coherente en todos los niveles de ruido?
- ¿Conserva el plegado la estructura de DD?
- ¿Sigue comportándose el escalado de ruido resultante de forma monótona?
El último método de mitigación de errores que analizaremos como enfoque independiente no es compatible con ZNE: la cancelación probabilística de errores.
Cancelación probabilística de errores (PEC)
A diferencia de ZNE o de la mitigación de mediciones, PEC intenta cancelar el ruido a nivel de puerta reconstruyendo el canal ideal en valor esperado. La cancelación probabilística de errores (PEC) es la técnica de mitigación de errores más potente y más costosa de las tratadas en esta lección. PEC se basa en la inversión explícita del canal de ruido, realizada de forma estadística y no física. PEC funciona de la siguiente manera:
-
Caracteriza el modelo de ruido en términos de una base de "operaciones de error".
-
Expresa la inversa del canal de ruido como una distribución de cuasi-probabilidad sobre operaciones físicas.
-
Muestrea de esta distribución durante la ejecución del circuito para construir estadísticamente una estimación insesgada del cálculo ideal.
Conceptualmente, PEC es como una corrección de errores virtual — "deshace" el ruido combinando operaciones ruidosas en patrones aleatorios cuidadosamente ponderados. Sin embargo, desde el punto de vista procedimental, PEC no está estrechamente relacionada con los códigos de corrección o detección de errores. La estimación insesgada que hace PEC del valor esperado ideal y sin ruido tiene el coste de una sobrecarga de muestreo muy grande y una fuerte dependencia de una caracterización precisa del ruido.
En los ordenadores cuánticos de IBM, PEC se considera mejor como una herramienta de precisión que como una capa de mitigación de propósito general: es más apropiada para circuitos pequeños o pequeñas porciones de circuitos más grandes, tareas de benchmarking y estudios de alta precisión en los que una sobrecarga cuántica elevada es aceptable.
Caracterización del canal de ruido
En PEC, cada puerta ideal de un circuito cuántico se modela como un canal unitario ideal seguido de un proceso de ruido. Sea la matriz de densidad del estado cuántico. La puerta ideal se representa mediante una matriz unitaria , que induce un canal cuántico:
En hardware real, esta evolución ideal se ve corrompida por el ruido. Modelamos la implementación física de la puerta como un canal ruidoso efectivo:
donde es un canal de ruido que captura los errores estocásticos asociados a la puerta. A lo largo de esta discusión, , y son aplicaciones lineales que actúan sobre operadores de densidad. El canal ideal es unitario y reversible, mientras que el canal de ruido (y por tanto ) es una aplicación completamente positiva que preserva la traza (CPTP).
PEC asume que el canal de ruido es conocido o aproximadamente conocido. En el hardware de IBM Quantum, esta información se obtiene normalmente a partir de datos de calibración del dispositivo, tasas de error inferidas de experimentos de benchmarking y modelos de ruido simplificados, como aproximaciones de Pauli o despolarizantes para conjuntos pequeños de puertas. Aunque PEC no requiere un modelo de ruido perfectamente exacto, su rendimiento se degrada rápidamente a medida que el canal de ruido asumido se aleja del comportamiento real del hardware.
Descomposición en cuasi-probabilidades del canal de ruido inverso
La idea central de PEC es cancelar el efecto del ruido en valor esperado construyendo una aproximación estocástica a la inversa del canal de ruido. Formalmente, el objetivo es aplicar una aplicación lineal que deshaga aproximadamente , de modo que:
en valor esperado sobre muchas ejecuciones del circuito.
La inversa se define aquí como la inversa algebraica de tratada como un superoperador lineal que actúa sobre operadores. Esta inversa existe solo si es de rango completo; los procesos de ruido no invertibles no pueden mitigarse exactamente con PEC.
Cuando la inversión es posible, PEC expresa el canal de ruido inverso como una combinación lineal de operaciones físicamente implementables:
Aquí, cada es una operación ruidosa que se puede ejecutar en el hardware (normalmente puertas nativas o secuencias cortas de puertas), y los coeficientes reales forman una distribución de cuasi-probabilidad. A diferencia de las probabilidades ordinarias, los coeficientes pueden ser negativos o superar 1.
La norma de cuasi-probabilidad:
cuantifica el coste de la inversión del ruido. Para cualquier canal de ruido no trivial, . En el hardware de IBM Quantum, esta descomposición se realiza normalmente:
- por puerta o por conjunto pequeño de puertas,
- asumiendo modelos de ruido restringidos (a menudo aproximaciones diagonales de Pauli),
- usando operaciones nativas específicas del backend y restricciones de planificación.
Reconstrucción Monte Carlo del circuito ideal
Para estimar el valor esperado de un observable , PEC usa muestreo Monte Carlo basado en la descomposición anterior. Para cada aparición de una puerta ruidosa en el circuito, se aplica el siguiente procedimiento:
-
Selecciona aleatoriamente una operación con probabilidad:
-
Asigna un peso clásico:
-
Ejecuta el circuito ruidoso aleatorizado resultante en el backend cuántico.
-
Multiplica el resultado medido por el producto de todos los pesos acumulados.
-
Promedia los resultados ponderados sobre muchas ejecuciones del circuito.
El estimador resultante satisface
siempre que el modelo de ruido describa con exactitud el hardware. Por lo tanto, PEC no introduce ningún sesgo sistemático en valor esperado, pero sustituye el sesgo por una gran varianza estadística. Cada ejecución produce una estimación ruidosa pero ponderada; solo tras promediar muchas de estas ejecuciones emerge el valor esperado ideal.
Interpretación conceptual
A veces se describe PEC como corrección de errores virtual. Aunque esta expresión no es del todo incorrecta, no debe confundirse con la verdadera corrección cuántica de errores. PEC no implica codificación lógica, ni extracción de síndromes, ni retroalimentación en tiempo real. Los errores no se previenen ni se corrigen durante la ejecución del circuito.
En cambio, PEC cancela el ruido estadísticamente, combinando muchas realizaciones ruidosas del circuito con pesos clásicos con signo, de modo que los errores se cancelan solo tras el posprocesamiento clásico. La información no se protege durante la ejecución; los resultados ideales se reconstruyen a posteriori.
Escalado de recursos y coste
El coste dominante de PEC proviene de la amplificación de la varianza. La varianza del estimador de PEC escala como:
lo que implica:
Este escalado es fundamental y no se puede mejorar mediante posprocesamiento clásico.
Para circuitos con muchas puertas ruidosas, cada puerta aporta un factor , lo que hace que la norma de cuasi-probabilidad total crezca aproximadamente de forma multiplicativa:
donde es la profundidad del circuito. En el hardware de IBM Quantum, esto suele provocar un crecimiento exponencial del coste de muestreo con la profundidad del circuito, con una sensibilidad especialmente fuerte a los errores de las puertas de dos qubits. Este escalado impone límites prácticos a la aplicabilidad de PEC.
Actualmente PEC solo es práctica cuando se cumplen una o todas las siguientes condiciones:
-
Los circuitos son muy pequeños o poco profundos (a menudo puertas),
-
Los modelos de ruido son simples y están bien validados (por ejemplo, ruido de Pauli),
-
Un coste estadístico alto es aceptable,
-
El objetivo es la precisión y no el rendimiento.
Por este motivo, PEC se aplica a menudo a:
-
Subcircuitos aislados dentro de flujos de trabajo más grandes,
-
Pasos de evolución de tiempo corto,
-
Rutinas de preparación de estados o de medición,
-
Experimentos de benchmarking y validación.
El stack de software de IBM (IBM Quantum Compute y las herramientas de mitigación de errores) lo refleja tratando PEC como una opción especializada, no como una capa de mitigación predeterminada.
Los casos de uso típicos de PEC incluyen:
-
Evaluación comparativa de precisión del hardware cuántico,
-
Verificación de algoritmos cuánticos pequeños,
-
Química cuántica de alta precisión en sistemas reducidos,
-
Verificación cruzada de ZNE u otros métodos de mitigación.
Relación de PEC con otros métodos de mitigación
Muchas otras técnicas de mitigación sacrifican precisión a cambio de escalabilidad; PEC hace justo lo contrario, y se centra en la precisión por encima de todo.
Dado que PEC puede usarse solo en un subcircuito, aquí es especialmente importante preguntarse qué otros métodos de mitigación pueden combinarse con él. Para razonar con claridad sobre la compatibilidad con PEC, conviene clasificar las técnicas según lo que hacen con el ruido. Considera estas categorías generales:
-
Cancelación de ruido: intentan invertir los canales de error
-
Escalado de ruido: aumentan deliberadamente el ruido para extrapolar
-
Remodelación del ruido: cambian la estructura o el espectro del ruido
-
Eliminación de sesgo: corrigen errores que no escalan con el ruido de las puertas
PEC se sitúa claramente en la categoría (1). Cualquier método que cambie o reescale el canal de ruido debe examinarse con cuidado.
Tabla resumen (nivel general)
| Técnica | Compatible con PEC | Notas |
|---|---|---|
| ZNE | No | Deshacer frente a escalar y, a veces, adaptar el error |
| Pauli twirling | Sí (con cuidado) | Afecta al comportamiento del error, pero puede facilitar su aprendizaje |
| TREX | Sí | Sin solapamiento en el flujo de trabajo. Totalmente compatible. |
| Desacoplamiento dinámico | Normalmente no | Cambia el canal de error |
PEC y ZNE abordan las mismas fuentes de error (errores de las puertas) mediante supuestos o flujos de trabajo mutuamente incompatibles, o ambos. Por ejemplo, en ZNE suponemos que el error puede expandirse en un parámetro :
y que el error puede escalarse de forma efectiva para modelar esta expansión. PEC desharía precisamente el error en el que nos apoyamos para el escalado. El parámetro perdería todo sentido. Otra forma de verlo es:
-
Aplicar ZNE antes de PEC cambia el canal de ruido que intentas invertir.
-
Aplicar PEC antes de ZNE elimina justo el ruido en el que ZNE se apoya para extrapolar.
PEC y ZNE deben considerarse paradigmas alternativos de mitigación de errores, no capas componibles. Compararlos lado a lado resulta instructivo, mientras que combinarlos no.
PEC y Pauli twirling son generalmente compatibles y a menudo beneficiosos. El twirling puede ayudar a PEC porque convierte los errores coherentes en errores de Pauli estocásticos. Esto simplifica el canal de ruido y facilita su representación e inversión. Para PEC esto es extremadamente valioso, por las siguientes razones:
-
Las descomposiciones en cuasi-probabilidades son mucho más simples para los canales de Pauli
-
La norma de cuasi-probabilidad suele ser significativamente menor
-
Se reduce la varianza del muestreo
Muchas demostraciones de PEC suponen o incorporan ruido sometido a Pauli twirling. Es importante aclarar que el Pauli twirling no mitiga los errores por sí mismo; remodela el ruido en una forma que la cancelación probabilística de errores puede manejar con mayor eficiencia.
PEC puede y debe combinarse con TREX. Estos enfoques son totalmente compatibles y desempeñan funciones ortogonales. TREX opera solo en la medición, elimina el sesgo de lectura mediante twirls aleatorizados del canal de medición, y no afecta al ruido de las puertas ni a la dinámica del circuito. PEC opera sobre el ruido de las puertas. Como el error de medición es aditivo y no composicional, es independiente de las secuencias de puertas. Es seguro, y a menudo deseable, aplicar TREX junto con PEC.
El orden de estos métodos es el que cabría esperar:
- Ejecutar el circuito aleatorizado de PEC
- Aplicar TREX para mitigar el error de lectura
- Aplicar la ponderación y el promedio de PEC
PEC y DD son generalmente incompatibles, a menos que la caracterización del ruido usada para PEC se realice con DD activo. PEC supone que es estacionario, repetible y caracterizable con precisión. DD remodela explícitamente el canal de ruido en el tiempo al modular las interacciones sistema-entorno e introducir efectos no triviales de temporización de pulsos. Como resultado, el ruido efectivo con DD no es el mismo canal que sin DD. Esto se complica aún más porque el canal de ruido puede depender de manera sensible de la planificación del circuito. El resultado final es que la inversión del ruido queda mal definida o es inválida.
En teoría es posible caracterizar el ruido con DD activo y construir un modelo de PEC en consecuencia, pero esto es muy avanzado y actualmente no es un flujo de trabajo recomendado.
Aplicar PEC a mano
PEC es complejo y no se recomienda implementarlo a mano. Aun así, queremos desarrollar las matemáticas de una aplicación básica sobre un solo qubit para entender qué pasos implica el proceso. Elegimos un estado mixto pero no trivial para poder ver con claridad los efectos numéricos.
Toma un qubit que debería estar en el estado puro
La matriz de densidad ideal es:
Hemos elegido esta matriz de densidad porque no es diagonal y es solo para un único qubit, de modo que resulta manejable examinarla "a mano".
Ahora aplicamos un modelo de ruido muy simple pero realista: un canal despolarizante de un solo qubit, con una intensidad pequeña .
Para que la aritmética sea amigable, toma . Este canal es completamente positivo y conserva la traza (CPTP), como debe ser. Es un canal de ruido realista para hardware real, o al menos realista para describir parte del ruido. Además, este canal de ruido es analíticamente invertible, como aplicación lineal. En otras palabras, existe una matriz inversa, pero eso no significa que la matriz corresponda a un canal físico CPTP, y desde luego no corresponde a un unitario que pueda implementarse en hardware.
Ahora aplicamos nuestro canal de ruido despolarizante a nuestra matriz de densidad de un solo qubit y obtenemos:
Con : y .
So:
Aplicando esto a nuestro estado:
Calculamos explícitamente:
Esta sigue siendo una matriz de densidad física y todavía tiene traza uno — pero ahora está más mezclada.
Ahora calculamos el canal inverso ideal, pero muy preparados para la posibilidad de que no sea físico. Comprobaremos si lo es. Matemáticamente, la aplicación lineal inversa es:
Si esta acción inversa fuera en sí misma un canal físico válido, nos sentiríamos tentados a intentar implementarla exactamente. Por supuesto, aún tendríamos que averiguar cómo implementarla mediante operaciones unitarias y pasos clásicos, pero ese sería el objetivo. Sin embargo, resulta que esto no es CPTP, y en general no hay garantía de que tales aplicaciones inversas sean CPTP. Eso es crítico para nuestra discusión actual, porque es la razón por la que existe PEC.
Quizá puedas ver que no es CPTP con solo mirarlo. Una comprobación infalible es aplicarlo a una matriz de densidad y ver si devuelve resultados físicos. Esto se deja como ejercicio para comprobar tu comprensión.
Comprueba tu comprensión
Comprueba si la aplicación inversa anterior es CPTP aplicándola a una nueva matriz de densidad:
Interpreta los resultados como físicos o no físicos.
Respuesta
Como matriz de densidad física, esto corresponde a una probabilidad clásica mayor que 1 de que el sistema esté en el estado y a una probabilidad negativa de estar en el estado . Claramente, esta aplicación puede producir matrices de densidad sin sentido. Además, por inspección podemos ver que los valores propios de la matriz de densidad resultante son 1.0625 y -0.0625, lo que significa que no todos los valores propios son positivos. Por lo tanto, la aplicación no es "completamente positiva", la "CP" de CPTP.
Comprueba tu comprensión
Comprueba mediante un cálculo explícito que la operación inversa anterior deshace el canal de ruido y devuelve el estado libre de ruido.
Respuesta
Aplícala al estado con ruido:
Este es exactamente el estado original (salvo redondeo).
Lo repetimos para que quede absolutamente claro: no podemos invertir el canal de ruido exactamente; la inversa no es CPTP, ni es un canal físico válido. Sin embargo, sí podemos invertir el canal de forma efectiva como una combinación lineal de canales físicos.
Para el canal despolarizante:
donde: etc.
La inversa puede escribirse como:
with:
-
= canales de Clifford físicamente implementables
-
= cuasi-probabilidades
-
Some
Esta es la idea central de PEC:
-
Muestrear canales según ∣
-
Asignar signos a los resultados de medición
-
Los valores esperados convergen al valor libre de ruido
Aplicamos PEC "a mano" a la estimación de usando la matriz de densidad y vemos si podemos recuperar los resultados de . Para esperamos:
Observa también que, para la matriz de densidad con ruido, obtenemos:
Tiene el orden de magnitud correcto, pero está significativamente lejos del caso ideal.
Ahora vemos paso a paso cómo, con el proceso de PEC, podemos reconstruir el valor esperado sin sesgo a partir de la matriz de densidad con ruido. En los flujos de trabajo reales, esto es probabilístico y se automatiza. En este flujo "a mano" elegiremos valores probabilísticos que son realistas, pero quizá convenientes para nuestra presentación. Esto no debe interpretarse como una afirmación de que PEC sea perfecto. Es simplemente para mostrarte un escenario plausible que podría ocurrir dentro de los paquetes de PEC.
Recuerda que nuestro canal de ruido tiene la forma:
La inversa puede escribirse (exactamente):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Para esta introducción es más simple centrarse en el efecto del canal sobre nuestra matriz de densidad. Esto nos permite trabajar con objetos familiares como las matrices de densidad y los valores esperados. Con ese fin, considera qué debe cumplirse sobre los efectos de esta operación inversa en nuestro proceso de estimación: el estimador producido por PEC debe estar normalizado y no tener sesgo. Esto corresponde a dos condiciones:
-
Normalización: para asegurar que esta operación no cambie la escala del observable, exigimos que . Para ver por qué ocurre esto, podríamos considerar la acción de la inversa sobre una matriz de densidad, o su acción sobre el valor esperado de algo trivial como el propio .
-
Calibración: en un flujo de trabajo real, usamos circuitos de calibración para aprender el comportamiento del ruido a nivel de puerta. Luego usamos ese conocimiento a nivel de puerta y la linealidad de los valores esperados para aplicar el modelo de ruido aprendido al circuito más grande. En nuestro caso, partimos del conocimiento artificial de que el valor esperado ideal es . Pero sería muy fácil idear un estado para el que sepamos teóricamente que este sería el valor ideal, y luego usar mediciones reales para la calibración. Un punto clave es que, en PEC, normalmente no se aprende un modelo de ruido completo de todo el circuito. En su lugar, se aprenden modelos de ruido locales para puertas individuales o capas del circuito y se usan para construir la descomposición en cuasi-probabilidades.
Usamos estas condiciones para determinar y . Consideramos el ansatz
and apply it to an arbitrary single-qubit density matrix .
Recuerda que los canales de Pauli actúan por conjugación:
Aplicar a da:
Tomando la traza, obtenemos:
Cada operador de Pauli es unitario, por lo que la conjugación conserva la traza:
Therefore,
Para que el estimador de PEC esté normalizado, la aplicación inversa efectiva debe conservar la traza de todas las matrices de densidad. Es decir, exigimos:
Esto implica la restricción de normalización:
Pero en nuestro caso, esto da la condición:
Ahora usamos la información de calibración para relacionar el valor esperado observado con el ideal conocido.
Or equivalently,
Resolviendo nuestras dos condiciones para y , obtenemos:
Estos coeficientes suman 1, pero uno de ellos es negativo.
Podemos recuperar el valor esperado ideal modificando el circuito de forma aleatoria, midiendo, multiplicando el resultado por un peso con signo y promediando. En particular, no se reconstruye ninguna matriz de densidad ni se implementa físicamente ningún canal inverso.
El paso clave: esto es PEC
Para nuestra intensidad de ruido , el canal inverso puede escribirse como:
Hechos importantes:
-
Los coeficientes suman 1
-
Un coeficiente es negativo
-
Cada término es físicamente implementable
-
La negatividad pasa al posprocesamiento clásico
Formamos una distribución de muestreo a partir de los valores absolutos de los pesos:
(para cada uno de X, Y, Z)
Peso total:
Para obtener las probabilidades de muestreo, divide entre W.
| Operación | Probabilidad | Signo |
|---|---|---|
| No hacer nada () | 1.1875 / 1.375 ≈ 0.864 | + |
| Aplicar X | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplicar Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplicar Z | 0.0625 / 1.375 ≈ 0.045 | - |
El signo proviene del coeficiente original, no de la probabilidad.
Cada shot consta de estos pasos:
-
Preparar el estado
-
Dejar que el hardware aplique el circuito con ruido
-
Elegir aleatoriamente una operación de la tabla anterior usando las probabilidades asociadas
-
Apply it
-
Medir , obteniendo
-
Multiplicar el resultado por
-
Registrar ese número
Ahora veamos ejemplos de varios shots.
Shot 1 (caso de la identidad)
Supongamos que nuestra operación elegida al azar es la identidad (o, equivalentemente: no hacer nada). Según los argumentos y la tabla anteriores, esto ocurrirá el 86.4% de las veces. Como el coeficiente de en la inversa del canal de ruido es positivo, seleccionamos el signo . Nuestra medición de Z podría dar fácilmente . Supongamos que da .
La contribución corregida por PEC de este shot sería:
Shot 2 (de nuevo la identidad)
Supongamos que de nuevo obtenemos como operación aleatoria (por lo que el signo del término sigue siendo inicialmente ), pero esta vez nuestra medición de Z da . Esta vez la contribución es:
Shot 3 (se elige X)
Esta vez nuestra operación aleatoria es X. Este término en la inversa es negativo, así que mantenemos un signo . Aplicamos X y luego medimos Z. De nuevo, podríamos obtener cualquiera de los dos valores propios; digamos que obtenemos . La contribución de este término es:
Shot 4 (se elige Z)
La operación aleatoria es Z. Esto nos da un signo según la tabla. Supongamos que medimos Z y obtenemos . La contribución es:
Shot 5 (se elige Y)
La operación aleatoria es Y. Esto nos da un signo según la tabla. Supongamos que medimos Z y obtenemos . La contribución es:
Promedio de los resultados
Imagina que recopilamos muchos resultados ponderados por PEC como estos:
Por construcción, aplicamos la identidad el 86.4% de las veces. Aplicamos cada una de las otras puertas el 4.5% de las veces. En un flujo de trabajo real, no conocemos los estados subyacentes precisos, ni todo el canal de ruido. Pero sí conocemos el factor de ponderación de arriba, y la probabilidad relativa con la que aplicamos cada operación. En un flujo de trabajo real, dependemos de la matriz de densidad desconocida para obtener los resultados de medición. Aquí verificaremos que este procedimiento daría los resultados correctos.
Queremos calcular el promedio de todas las mediciones ponderadas y con signo, incluyendo las aplicaciones de operadores de Pauli antes de la medición. Llama al número total de shots. Llama al conjunto de todos los shots en los que se aplicó el Pauli y usa para indexar esos shots. Llama al resultado de medición del -ésimo shot bajo la aplicación del -ésimo Pauli. Podemos escribir este promedio como:
El operador de Pauli se aplica de forma probabilística con probabilidad . En el límite de un gran número de shots,
Podemos usar esto para escribir:
donde es el valor esperado de Z solo sobre el conjunto de shots en los que se aplicó . Esto es útil porque sabemos cuál debe ser cada uno de estos valores esperados a partir de la matriz de densidad. De nuevo, en un flujo de trabajo real, esto surgiría de la medición, no de una matriz de densidad conocida.
Comprueba tu comprensión
Verifica los valores esperados anteriores mediante cálculo o razonamiento lógico.
Respuesta
Y y Z proceden exactamente como se explicó antes.
Ahora podemos reescribir nuestro valor esperado global como:
Si conocemos los parámetros y del ruido de nuestra puerta (o más parámetros para canales de ruido más complejos), eso basta para determinar (1) el factor de peso global y (2) las probabilidades con las que debemos aplicar los operadores de Pauli. Lo que muestra el resultado anterior es que, si hacemos eso, mitigamos el ruido y recuperamos valores esperados sin sesgo. El promedio de todas estas shots convergió a , a pesar de que:
-
Las shots individuales aportan contribuciones mayores que ±1
-
Algunas shots tienen peso estadístico negativo
-
Cada operación cuántica fue física
Resumen del flujo de trabajo de PEC
En PEC, todos los pasos en el ordenador cuántico son:
-
Aprendizaje del ruido
-
Preparación del estado para tu circuito objetivo
-
Aplicar puertas de Pauli de forma probabilística como se describió antes
-
Measurement
El mapa de ruido inverso efectivo se realiza de forma estadística en el posprocesamiento clásico. Esto permite una inversión más general de canales de ruido que, de otro modo, habría requerido pasos no físicos, como probabilidades negativas.
El precio que pagamos por ello es la varianza. Cada shot tenía antes una "magnitud" igual a las magnitudes posibles de los resultados de medición . Tras escalar por el factor de peso , tiene magnitud (1.375 en nuestro ejemplo anterior).
Ese es el origen de la sobrecarga de muestreo de PEC.
PEC integrada
Ahora usaremos PEC tal como está integrada en las primitivas de IBM Quantum. Aquí es fundamental distinguir entre la PEC completa a nivel de puerta y un modelo local de aprendizaje de ruido para una PEC más escalable, que es la que usan las primitivas de IBM Quantum. La sobrecarga de usar la PEC completa limitaría su aplicación a circuitos pequeños. Eso está bien, pero es más útil contar con una herramienta que escale hasta un tamaño en el que la computación cuántica se vuelva valiosa para problemas del mundo real. Por esta razón, las primitivas de IBM Quantum usan una PEC por capas con un modelo de ruido de Pauli-Lindblad aprendido, con salvaguardas agresivas de escalabilidad. En esta implementación de PEC, el ruido se aprende por cada capa de circuito repetida, no por cada instancia de puerta, y el modelo de ruido es de Pauli-twirling, local y markoviano. Las puertas de Clifford se absorben en el modelo de ruido, mientras que las puertas que no son de Clifford dominan el coste de la mitigación. La sobrecarga de muestreo está limitada para evitar explosiones exponenciales.
Aplicaremos la PEC integrada en las primitivas de IBM Quantum a dos escalas: pequeña (seis qubits) y mediana (30 qubits), para ver cómo se mantiene manejable el coste en esta versión de PEC. En cada experimento de cada tamaño, también compararemos explícitamente los resultados de PEC con los obtenidos sin mitigación, con ZNE y con el valor ideal.
Comenzamos importando algunos paquetes necesarios.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Elegimos un observable para estimar. El observable siguiente es el hamiltoniano de una cadena de espines tipo Ising con acoplamiento solo entre vecinos más próximos en la componente de su interacción, y un término de un solo qubit en , como si se debiera a un campo externo en .
No hay ninguna razón especial para elegir este hamiltoniano. Simplemente necesitamos una combinación de observable y circuito que no sea trivial para que la mitigación de errores pueda hacer su trabajo. Escalamos explícitamente el hamiltoniano (mediante los coeficientes), dividiendo por el número de qubits para que la energía se mantenga en el mismo orden de magnitud a medida que aumentamos el número de qubits. Empezamos con solo seis.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Al igual que en la elección del hamiltoniano, el circuito de preparación de estado siguiente no se ha elegido por ninguna razón física. Más bien, se ha elegido para tener suficiente profundidad de dos qubits y suficientes puertas que no son de Clifford como para que PEC pueda ser útil. No hay motivo para pensar que este circuito sea una buena aproximación del estado fundamental de esta cadena de espines, por ejemplo.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
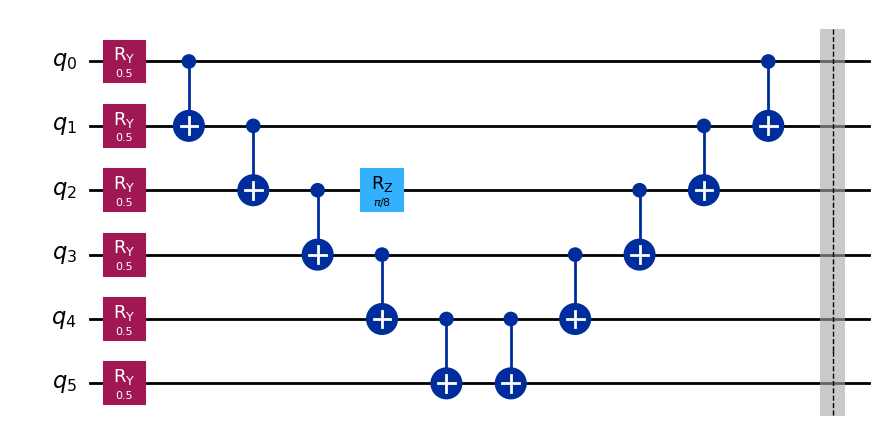
Transpilamos nuestro circuito y aplicamos el layout resultante a nuestros observables.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Obtenemos el valor esperado ideal usando el simulador Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Esperamos que otros valores ideales sean de tamaño similar. Ahora ejecutamos esto en un ordenador cuántico real de IBM sin mitigación de errores.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Ahora aplicamos ZNE al mismo problema.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Por último, aplicamos PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
A continuación representamos gráficamente nuestros resultados y los comparamos.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
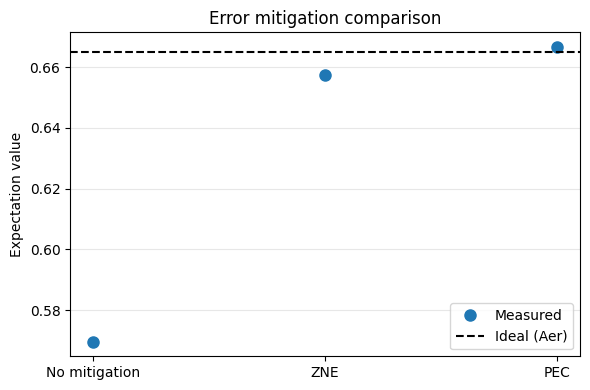
Esto funcionó muy bien. Nuestra estimación con PEC está a solo un 0.2 % del valor ideal.
Pero recuerda que la sobrecarga cuántica crece exponencialmente. Impusimos una sobrecarga máxima de max_overhead = 100. A juzgar por el tiempo y la calidad de los resultados, parece que quizá no llegamos a ese máximo. Sin embargo, si aumentamos la escala de nuestro cálculo y mantenemos ese máximo, lo alcanzaremos y nuestros resultados se resentirán.
Podemos ver qué ocurre cuando aumentamos nuestro circuito a 30 qubits. Curiosamente, en muchos portátiles el simulador Statevector empezará a agotar el tiempo de espera hacia los 24-28 qubits. Podríamos encontrar formas computacionales de sortearlo. Pero, en cambio, aceptemos el hecho de que los ordenadores cuánticos podrán resolver algunos problemas a una escala a la que los ordenadores clásicos no pueden seguirles el ritmo. Ese es el punto. Entonces, ¿qué podemos hacer para validar nuestros resultados de computación cuántica en esos casos? Hay varias respuestas posibles:
- Algunos problemas son difíciles de resolver pero fáciles de comprobar (como la factorización en primos del algoritmo de Shor).
- Algunos problemas tienen regímenes de parámetros o variantes que reducen su complejidad y pueden resolverse de forma clásica, o incluso analítica, para comparar unos pocos puntos. En este caso, elegimos un hamiltoniano intrínseco (dividimos por el número de qubits). El valor esperado ideal debería ser bastante estable. Veamos cómo varía el valor esperado ideal con el número de qubits y si podemos hacer predicciones clásicas sobre el valor con 30 qubits.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
En efecto, vemos que hemos seleccionado un hamiltoniano y un estado que no cambian con el número de qubits. Esto es un uso muy pobre para una aplicación de investigación de la computación cuántica, pero excelente para evaluar técnicas de mitigación de errores. Podemos usar con confianza este valor esperado fijo como resultado ideal, incluso cuando aumentamos el número de qubits para probar la mitigación de errores.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Ahora ejecutamos este circuito más grande con ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Por último, ejecutamos el ejemplo de 30 qubits con PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
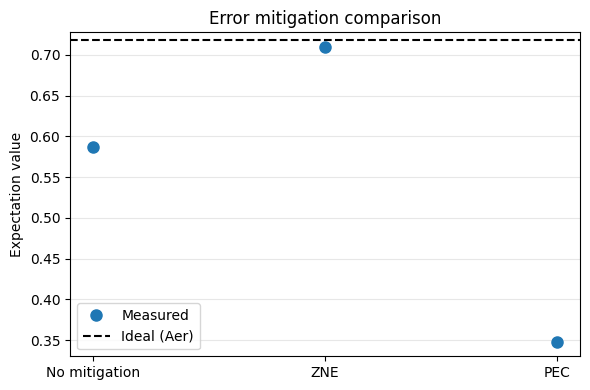
PEC no solo tardó mucho más que las otras opciones, sino que claramente alcanzamos nuestro umbral máximo de sobrecarga. Los resultados de PEC pagaron el precio de la sobrecarga, pero el límite impidió una cancelación suficientemente precisa del modelo de ruido aprendido. Esto es fundamental. Con seis qubits pudimos aprovechar PEC y obtener mejores resultados con solo un aumento modesto de la sobrecarga cuántica (aproximadamente un factor de 5). Con 30 qubits pagamos un precio mucho mayor (aproximadamente 60 veces más) y los resultados fueron incluso peores que la estimación sin mitigar. Esto no quiere decir que PEC nunca pueda funcionar con 30 qubits; eso podría depender del circuito. El mensaje es simplemente que el crecimiento exponencial de la sobrecarga cuántica dificulta su ejecución en circuitos grandes.
Conclusiones clave:
-
La mitigación de mediciones suele ayudar y normalmente conlleva poca sobrecarga: elimina un sesgo que no escala con la profundidad del circuito y se combina limpiamente con casi todo.
-
Algunas técnicas no se pueden combinar. Incluso cuando se puede, asegúrate de combinarlas de manera coherente, de modo que una no deshaga a la otra. Un buen ejemplo es asegurarse de que el twirling esté activado durante la calibración de M3 si se van a combinar esos métodos.
-
PEC y ZNE deben considerarse alternativas entre sí. Resuelven el mismo problema con compromisos opuestos:
-
PEC: produce valores esperados sin sesgo a costa de una varianza exponencial.
-
ZNE suele producir un sesgo residual que depende del modelo de extrapolación, pero a un coste moderado.
-
-
DD puede ayudar con periodos de inactividad largos, pero remodela el modelo de ruido y puede invalidar los supuestos de extrapolación o inversión.
-
El Pauli twirling no reduce el ruido. Lo remodela y a menudo permite que otras técnicas funcionen mejor (ZNE y PEC).