Rimay Quantum Feature Extraction - una Qiskit Function de Kipu Quantum
Consulta la referencia de la API.
Qiskit Functions es una función experimental disponible solo para los usuarios del Premium Plan, el Flex Plan y el On-Prem Plan (a través de la API de IBM Quantum Platform) de IBM Quantum®. Están en estado de versión preliminar y sujetas a cambios.
Descripción general
Rimay amplía los pipelines de aprendizaje automático clásico con características generadas en hardware cuántico. La función toma datos tabulares clásicos y devuelve un conjunto de características transformadas cuánticamente. Cuando un sistema cuántico procesa los datos, genera características ricas que capturan relaciones no lineales entre las entradas. Puedes usar las características generadas por sí solas, o combinadas con tus características originales, para entrenar cualquier modelo clásico. En conjuntos de datos pequeños y medianos, las características transformadas cuánticamente pueden mejorar la calidad de la predicción en comparación con las líneas base puramente clásicas.
Esta función está pensada para los siguientes usuarios:
-
Equipos de ciencia de datos con un pipeline de aprendizaje automático existente sobre conjuntos de datos tabulares pequeños y medianos, donde la calidad de la predicción se ha estancado. Añades Rimay como un paso de preprocesamiento adicional, sin construir tú mismo ningún circuito cuántico.
-
Investigadores que exploran métodos cuánticos para tareas de aprendizaje automático.
Descripción
El algoritmo de extracción de características cuánticas [1] combina dos principios del aprendizaje automático cuántico. El primero son los mapas de características cuánticos, que incrustan los datos en un espacio de Hilbert de alta dimensión y, por tanto, producen representaciones más expresivas. El segundo es la computación de reservorio cuántico, que usa la dinámica de un sistema cuántico de muchos cuerpos como transformación no lineal de la entrada.
Rimay codifica los valores de las características y la información mutua entre ellas en los campos locales y en los coeficientes de acoplamiento de un hamiltoniano de vidrio de espín. La dinámica cuántica contradiabática hace evolucionar el sistema hacia sus estados de baja energía, que contienen mezclas no lineales de las correlaciones de los datos de entrada. Rimay extrae estas correlaciones midiendo valores esperados de uno y dos cuerpos. Los valores esperados son las características transformadas cuánticamente que introduces en tu modelo de aprendizaje automático.
Flujo de trabajo
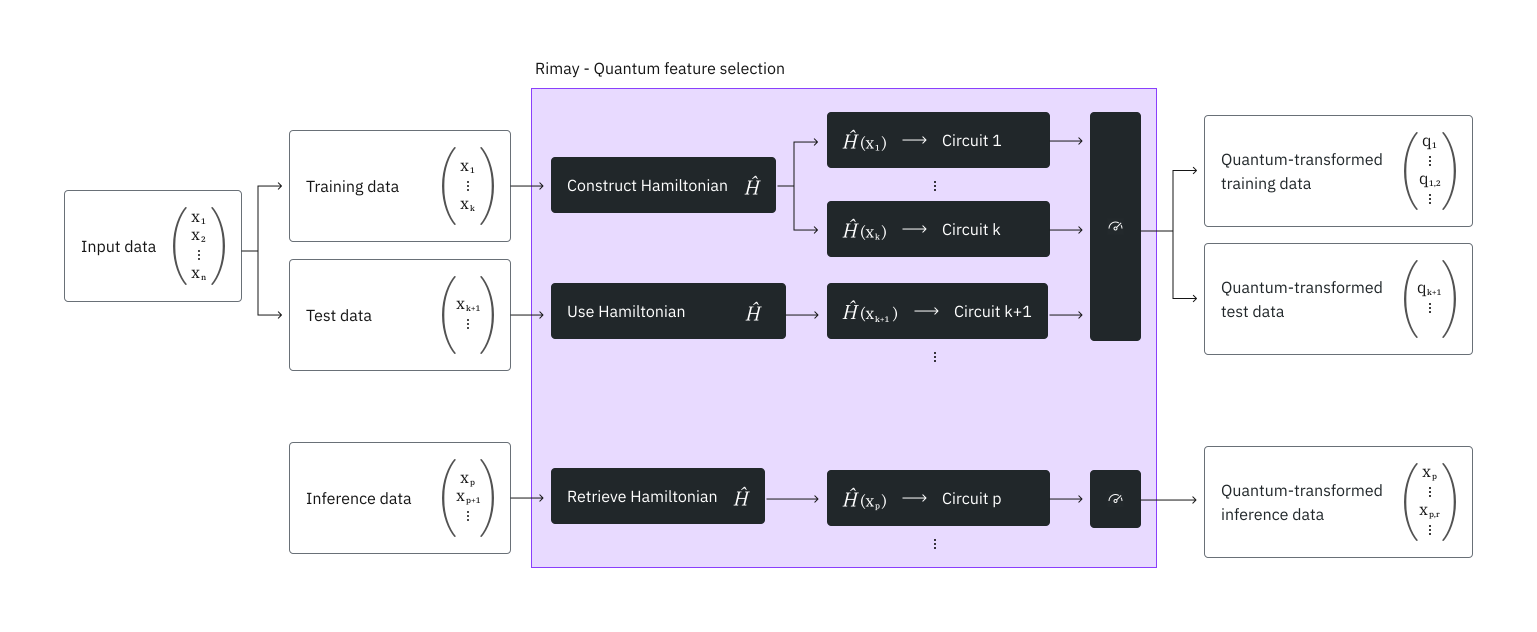
-
Preprocesa tus datos tabulares como lo harías para el aprendizaje automático clásico. Rimay necesita características numéricas, así que convierte las características categóricas en numéricas, por ejemplo con el
OneHotEncoderde scikit-learn. -
Divide los datos en un conjunto de entrenamiento y un conjunto de prueba, y sube ambos a la función, como se muestra en la sección Ejemplo.
-
Rimay usa los datos de entrenamiento para construir el hamiltoniano que representa los datos. Cada característica corresponde a un qubit, y el conjunto de entrenamiento completo decide qué características, y por tanto qué qubits, interactúan. Rimay almacena esta estructura para mapear los datos de prueba y los datos de inferencia posteriores con el mismo hamiltoniano.
-
Para cada muestra, los valores de las características establecen los campos locales del hamiltoniano, y la información mutua entre las características establece los coeficientes de acoplamiento de la estructura del paso 3. Rimay digitaliza la evolución contradiabática de este hamiltoniano en un circuito y ejecuta los circuitos en la QPU.
-
Rimay mide las cadenas de bits resultantes y luego calcula los valores esperados de un cuerpo y los valores esperados de dos cuerpos de los qubits acoplados físicamente.
-
Descargas los valores esperados en una forma que puedes introducir directamente en tu modelo o combinar con tus características originales.
Debido a esta estructura, el número de qubits que necesita una ejecución es igual al número de características, y el número de circuitos que envía es igual al número de muestras.
Después de ajustar un mapeo, puedes mapear datos nuevos a través de él, por ejemplo para la inferencia. Rimay recupera entonces el hamiltoniano que creó durante el ajuste y construye a partir de él los circuitos para las muestras nuevas.
Integra Rimay en tu pipeline de aprendizaje automático
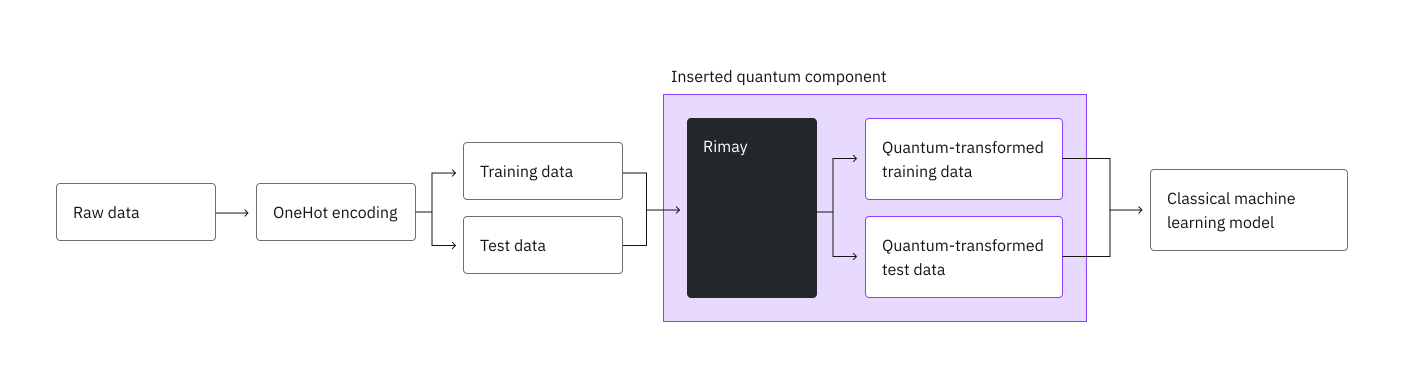
Igual que en un pipeline clásico, empiezas preprocesando los datos brutos, por ejemplo codificando en one-hot las características categóricas, y los divides en un conjunto de entrenamiento y un conjunto de prueba. En lugar de introducir ambos conjuntos directamente en tu modelo, los introduces primero en Rimay y entrenas tu modelo con las características transformadas cuánticamente.
Benchmarks
Kipu Quantum evaluó Rimay con el conjunto de datos German credit de OpenML [2], que clasifica a 1000 solicitantes de crédito como buenos o malos riesgos crediticios. Tiene 13 atributos categóricos y siete numéricos. La codificación one-hot de los atributos categóricos da como resultado 48 características numéricas. El benchmark reserva el 20 % de las muestras como conjunto de prueba.
Como referencia, se entrenaron varios modelos clásicos con las características clásicas. Con Rimay, se entrenó un random forest de dos maneras: solo con las características transformadas cuánticamente (Random forest Q) y con las características transformadas cuánticamente combinadas con las clásicas (Random forest H, de híbrido). La tabla muestra solo el random forest, porque fue el que mejor rindió con las características transformadas cuánticamente.
| Modelo | Características | Exactitud | AUC | Puntuación F1 | Precisión | Exhaustividad |
|---|---|---|---|---|---|---|
| CatBoost | Clásicas | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Clásicas | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Clásicas | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Clásicas | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Cuánticas | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Híbridas | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Las características híbridas mejoran todas las métricas del random forest excepto la precisión, y el random forest híbrido alcanza un AUC, una puntuación F1 y una exhaustividad más altos que CatBoost con las características clásicas. El mayor efecto se da en la exhaustividad, que sube de 0.921 a 0.957. Las características transformadas cuánticamente por sí solas no alcanzan la precisión de los modelos clásicos.
El conjunto de prueba contiene solo 200 muestras, así que predecir correctamente una muestra más cambia la exactitud en 0.005. Interpreta las diferencias como una tendencia que requiere más verificación, no como un efecto significativo. La exactitud de la predicción también puede depender del ruido inducido por el hardware en las características extraídas. Por tanto, usa suficientes shots para que el ruido de shots no limite el resultado.
El benchmark usó los siguientes recursos:
| Ejemplo | Número de qubits | Número de muestras | Número de shots | Tiempo total (min) | Uso de QPU (min) | Procesador |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
El número de muestras, que es el número de circuitos, determina el tiempo de QPU. Usa el tipo de procesador Nighthawk r2, porque reduce enormemente el tiempo de QPU necesario.
Entradas
El mode determina qué parámetros necesita una ejecución. Para una descripción de cada parámetro de entrada, consulta la referencia de la API.
Archivos de entrada
-
Sube cada archivo con
catalog.file_upload()antes de ejecutar la función. -
Una subida reemplaza cualquier archivo anterior con el mismo nombre, incluso para un trabajo que enviaste pero que aún no ha comenzado. Para ejecutar varios trabajos al mismo tiempo, da a los archivos de cada trabajo nombres propios, por ejemplo
run1_x_train.csvyrun2_x_train.csv. -
Cada archivo es un archivo CSV con una fila de encabezado. Cada columna de un archivo de características es una característica, y todos los valores deben ser numéricos.
-
y_traincontiene exactamente una columna numérica, con una etiqueta por cada fila dex_train. Asigna números a las etiquetas categóricas, por ejemplo 1 y 0 para bueno y malo. -
x_testyx_inferencedeben tener las mismas columnas quex_train, en el mismo orden.
El mapping_id es la única forma de acceder al mapeo que produjo tu ajuste, y no se puede consultar ni recuperar. Autoriza el uso de ese mapeo, así que trátalo como una credencial y no lo compartas. Si lo pierdes, tendrás que ajustar un mapeo nuevo, lo que cuesta otra ejecución en hardware cuántico. Registra también el backend_name del ajuste, porque el mapeo solo se ejecuta en ese procesador.
Límites
-
Cada característica se mapea a un qubit, así que el procesador debe tener al menos tantos qubits como características tienen tus datos. Si tienes más características, redúcelas primero con una técnica de selección de características.
-
Cada muestra se convierte en un circuito, y una ejecución cuenta juntas las muestras de entrenamiento y de prueba. Una ejecución puede contener como máximo 15,000 muestras.
-
Un solo trabajo puede solicitar como máximo 10 millones de ejecuciones, así que el número de muestras multiplicado por
shotsno debe superar los 10 millones. -
Un trabajo debe terminar en 24 horas, incluido el tiempo que sus circuitos esperan en la cola del procesador. Un trabajo que dura más se detiene sin resultado. En un procesador ocupado, mantén los conjuntos de datos grandes muy por debajo de estos límites.
Salidas
job.result() devuelve un diccionario. Las características transformadas cuánticamente se escriben en archivos CSV que descargas con catalog.file_download(). Para una descripción de cada clave del diccionario, consulta la referencia de la API. Para conocer el tiempo que tardó cada fase de ejecución, consulta Metadatos de la ejecución.
Cada archivo de salida contiene una fila por cada fila de entrada, en el orden del archivo de entrada, y una columna por cada característica transformada cuánticamente. Las columnas cuyos nombres empiezan por corr_ son los valores esperados de dos cuerpos. Los archivos no contienen una columna de etiquetas. Las etiquetas de tus datos de entrenamiento permanecen en tu archivo y_train.
Metadatos de la ejecución
resource_usage contiene una entrada por cada fase de ejecución por la que pasó la ejecución: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" y, en una QPU, normalmente "RUNNING: WAITING_FOR_QPU". Cada entrada contiene CPU_TIME, el tiempo real de la fase en segundos, y QPU_TIME, el tiempo de QPU en segundos. En una QPU, el tiempo de QPU facturado por IBM se registra bajo "RUNNING: MAPPING", la fase en la que se ejecutaron los circuitos.
"RUNNING: WAITING_FOR_QPU" es el tiempo que tus trabajos esperaron en la cola de IBM. La ejecución toma este tiempo de las marcas de tiempo de los trabajos de IBM y no lo cuenta en "RUNNING: MAPPING". Si IBM no informa de esas marcas de tiempo para cada trabajo, la entrada no aparece y la espera forma parte de "RUNNING: MAPPING".
IBM® termina su cálculo de uso algún tiempo después de que finaliza un trabajo. La ejecución espera hasta aproximadamente un minuto por él. El uso que aún se está calculando pasado ese tiempo no se incluye en QPU_TIME, y el uso final se muestra en IBM Quantum Platform. Si la ejecución no puede leer el uso de IBM, QPU_TIME es None.
Por ejemplo:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Primeros pasos
Autentícate con tu clave de API de IBM Quantum Platform y selecciona la Qiskit Function de la siguiente manera:
El siguiente código supone que has guardado tus credenciales. Si no lo has hecho, sigue las instrucciones de Instalar el cliente de Qiskit Functions Catalog para guardar tu cuenta con tu clave de API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Tamaños de la función
Cada trabajo se ejecuta con un tamaño: S, M o L. Si el tamaño especificado es demasiado pequeño, el trabajo se rechaza. Si el tamaño es mayor de lo necesario, se ejecuta en un perfil de cómputo más grande de lo que requiere el trabajo.
El tamaño de un trabajo de Rimay depende del número de muestras que mapea: las filas de x_train y x_test para fit-transform, y las filas de x_inference para transform. Las etiquetas de y_train no cuentan, y una ejecución delete no mapea ninguna muestra.
| Tamaño | Muestras por trabajo | Perfil de cómputo | vCPU | RAM |
|---|---|---|---|---|
S | Hasta 2,999 | 8x32 | 8 | 32 GB |
M | De 3,000 a 9,999 | 8x32 | 8 | 32 GB |
L | De 10,000 a 15,000 | 16x128 | 16 | 128 GB |
El número de muestras es el único criterio. Un tamaño no cambia nada salvo el perfil de cómputo: los límites de características, muestras y shots son los mismos para todos los tamaños. S y M se ejecutan en el mismo perfil de cómputo y se diferencian en el número de muestras que cubre cada uno.
El valor predeterminado es M, que se usa cuando un trabajo no solicita un tamaño. Por tanto, un trabajo de más de 9,999 muestras debe solicitar L.
También puedes leer el mapeo directamente de la propia función con rimay.sizes_map, y el tamaño con el que se ejecuta un trabajo cuando no solicita ninguno con rimay.default_size.
Calcula el tamaño antes de enviar
Ejecuta esto con tus propias entradas. Solo las lee y no hace nada más: no se envía ningún trabajo y no se reserva nada, así que puedes llamarlo tantas veces como quieras.
Pasa los conjuntos de datos en sí, no sus nombres de archivo, en el mismo orden que input_file, junto con el mode de la ejecución. El paso 2 del ejemplo muestra la llamada.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Si el tamaño es demasiado pequeño, el trabajo falla con el error 4600 y el mensaje indica el tamaño que debes usar en su lugar. Si es mayor de lo necesario, el trabajo se ejecuta con normalidad y registra un evento de aviso 4601.
Ejemplo
Este ejemplo muestra cómo subir datos, ejecutar la función y recuperar las características transformadas cuánticamente. Para un ejemplo de extremo a extremo que incluye el preprocesamiento y el entrenamiento del modelo clásico, consulta el tutorial.
1. Sube los datos
Este ejemplo usa un pequeño conjunto de datos sintético con cuatro características numéricas y una etiqueta binaria, de modo que una ejecución solo necesita cuatro qubits y termina rápido. La siguiente celda lo escribe en cuatro archivos CSV: las características de entrenamiento, las etiquetas de entrenamiento, las características de prueba y las características para el paso 4 de este ejemplo. Para usar tus propios datos, escribe en su lugar tus conjuntos de entrenamiento y de prueba preprocesados en archivos con el mismo formato.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Sube los archivos de entrenamiento y de prueba. Subirás x_inference.csv en el paso 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Ejecuta la función
Calcula el tamaño de la ejecución a partir de los datos que subiste, con la calculadora de Tamaños de la función.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Selecciona un procesador con al menos tantos qubits como características tienen tus datos y ejecuta la función en modo fit-transform con ese tamaño. Los datos de ejemplo tienen cuatro características, así que cualquier procesador de IBM Quantum puede ejecutarlos.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Comprueba el estado de la carga de trabajo o devuelve los resultados de la siguiente manera:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Recupera los resultados
Descarga las características transformadas cuánticamente. Pasa target_name para que cada archivo se guarde con su propio nombre.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Mapea datos nuevos
Después de entrenar tu modelo, mapea datos nuevos con el mapeo ajustado, por ejemplo para ejecutar la inferencia. Este ejemplo mapea x_inference.csv, que escribió la primera celda de este ejemplo. Pasa el mapping_id que devolvió el ajuste, para que las filas nuevas se mapeen con el mismo mapeo en lugar de con uno nuevo.
Un mapeo se construye para la disposición de qubits de un procesador, así que pasa el mismo backend_name que el ajuste, que este devolvió en result["backend_name"]. No uses least_busy() para elegir el procesador, porque podría devolver uno distinto. Rimay rechaza cualquier otro procesador antes de enviar nada. El número de shots también proviene del ajuste.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Elimina un mapeo
Cuando ya no necesites un mapeo ajustado, elimínalo. Una ejecución delete no realiza trabajo cuántico, así que no necesita procesador, ni shots, ni tamaño de función. No puedes deshacer una eliminación. Tras la eliminación, el mapping_id ya no hace referencia a nada y una ejecución transform con él falla.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Obtener mensajes de error
Si el estado de tu carga de trabajo es ERROR, usa job.error_message() para obtener el mensaje de error, de la siguiente manera:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Cada error que informa Rimay incluye un código de los códigos de error de IBM Quantum, un mensaje y una solución que nombra el valor que pasaste y el valor permitido. La siguiente tabla enumera los errores más comunes:
| Código | Causa |
|---|---|
1221 | Falta un parámetro o tiene un tipo incorrecto, mode no es válido, un archivo indicado en input_file no se subió, los archivos no coinciden entre sí, una característica no es numérica o el mapping_id no coincide con un mapeo almacenado. |
1221 | Una ejecución "transform" indica un backend_name distinto del ajuste que produjo su mapeo. |
1216 | Tu instancia no tiene ningún procesador con el backend_name que pasaste. La solución enumera los procesadores que sí tiene. |
1200 | Tu clave de API no tiene acceso a la instancia bajo la que se ejecuta el trabajo. |
3200 | backend_name no empieza por ibm_. |
4500 | Los datos tienen más características que qubits tiene el procesador. |
6000 | El número de muestras multiplicado por shots supera los 10 millones de ejecuciones. |
6001 | shots es menor que 1. |
6002 | Los datos tienen más muestras de las que permite una ejecución. |
Casos de uso
En clasificación tabular sobre conjuntos de datos pequeños y medianos, Kipu Quantum ha aplicado la extracción de características cuánticas a lo siguiente:
Más allá de los datos tabulares, las redes neuronales congeladas pueden transformar imágenes en características numéricas, que la extracción de características cuánticas mapea después en características transformadas cuánticamente:
Obtener soporte
Para obtener soporte, contacta con support@kipu-quantum.com.
Próximos pasos
-
Visita la referencia de la API de esta Qiskit Function.
-
Prueba el tutorial Clasificar el riesgo crediticio con la extracción de características cuánticas Rimay de Kipu Quantum.
Referencias
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Información adicional
Rimay es una palabra quechua que significa "explicar".