Clasifica el riesgo crediticio con la extracción cuántica de características Rimay de Kipu Quantum
Las Qiskit Functions son una característica experimental disponible solo para los usuarios del Plan Premium, el Plan Flex y el Plan On-Prem (a través de la API de IBM Quantum Platform) de IBM Quantum®. Están en estado de versión preliminar y sujetas a cambios.
Estimación de uso: 2 minutos en un procesador Nighthawk r2. (NOTA: Esto es solo una estimación. Tu tiempo de ejecución puede variar.)
Resultados de aprendizaje
-
Preparar datos tabulares con columnas categóricas y numéricas para la Qiskit Function Rimay.
-
Ajustar un mapeo de características cuántico con los datos de entrenamiento y mapear los datos de prueba en la misma ejecución.
-
Entrenar modelos clásicos con características transformadas cuánticamente, solas y combinadas con las características originales.
-
Comparar los resultados con una línea base puramente clásica.
Requisitos previos
Antes de comenzar este tutorial, debes estar familiarizado con los siguientes temas:
-
Clasificación supervisada con scikit-learn
Contexto
Muchos problemas de aprendizaje automático en la industria involucran conjuntos de datos tabulares pequeños o medianos, donde agregar más datos no es una opción y la precisión del modelo se estanca. La puntuación del riesgo crediticio es un ejemplo típico. Un prestamista usa unas pocas docenas de atributos para decidir si es probable que el solicitante devuelva el crédito.
Rimay, una Qiskit Function de Kipu Quantum, añade un paso de preprocesamiento cuántico a un flujo de trabajo de este tipo. Implementa el algoritmo de extracción cuántica de características contradiabática digitalizada [1]. Cada característica de entrada se asigna a un qubit. Los valores de las características y la información mutua entre ellas determinan los campos locales y los acoplamientos de un hamiltoniano de vidrio de espín. A continuación, la dinámica contradiabática hace evolucionar el sistema cuántico hacia sus estados de baja energía, y los valores esperados de uno y dos cuerpos medidos al final se convierten en las nuevas características transformadas cuánticamente. Estas características capturan correlaciones no lineales entre las entradas, y puedes alimentar con ellas cualquier modelo clásico.
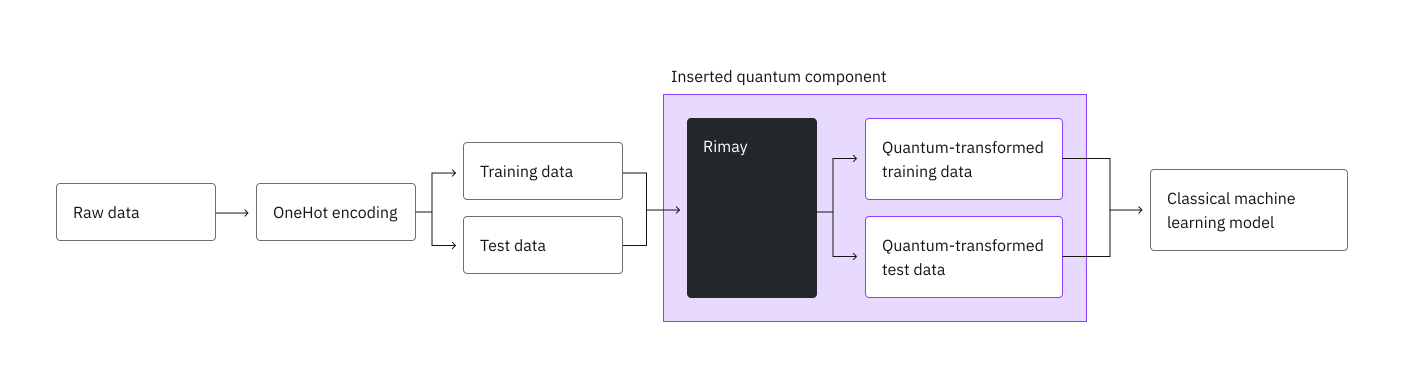
Este tutorial usa el conjunto de datos German credit de OpenML [2], con 1000 solicitantes y 20 atributos, para entrenar un clasificador de bosque aleatorio. Primero estableces una línea base clásica, luego envías los datos a Rimay y, por último, entrenas el mismo tipo de modelo con las características transformadas cuánticamente, solas y combinadas con las características originales.
Requisitos
Antes de comenzar este tutorial, asegúrate de tener instalados los siguientes paquetes:
-
Cliente de IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
También necesitas acceso a la función Rimay del catálogo de Qiskit Functions.
Configuración
Importa los paquetes y define dos funciones auxiliares: una que entrena un bosque aleatorio y otra que calcula las métricas usadas a lo largo del tutorial.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Configura las credenciales de IBM Quantum
Autentícate con tu clave de API de IBM Quantum Platform, carga la función Rimay y selecciona el procesador cuántico menos ocupado disponible para tu instancia.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Paso 1: Asignar entradas clásicas a un problema cuántico
Rimay asigna cada característica numérica de entrada a un qubit, por lo que el primer paso es convertir la tabla original en características numéricas.
Carga el conjunto de datos
Carga el conjunto de datos German credit directamente desde OpenML. La columna class contiene la etiqueta: good para los solicitantes que devolvieron su crédito y bad para los que no.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Codifica las características
Convierte la etiqueta a un valor binario y aplica codificación one-hot a las 13 columnas categóricas. El código elimina la primera categoría de cada columna para evitar características redundantes, lo que da como resultado 48 características numéricas.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Divide en conjuntos de entrenamiento y de prueba
Reserva el 20 % de los solicitantes como conjunto de prueba. Una división estratificada mantiene igual la proporción de créditos buenos y malos en ambos conjuntos.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Establece una línea base clásica
Entrena un bosque aleatorio con las características clásicas. En el Paso 4, compararás las características transformadas cuánticamente con sus métricas.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Sube los datos a Rimay
Rimay lee sus entradas de archivos CSV que subes a la función. Las características y las etiquetas van en archivos separados. También subes el conjunto de prueba, para que Rimay lo asigne con la misma asignación que ajusta con el conjunto de entrenamiento.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Paso 2: Optimizar el problema para la ejecución en hardware cuántico
Rimay construye y transpila los circuitos para el procesador que seleccionas, por lo que no hay ningún circuito que optimizar a mano. Especifica el número de shots por circuito, dentro de las siguientes restricciones:
-
Cada característica necesita un qubit, por lo que el procesador debe tener al menos tantos qubits como características tiene el conjunto de datos.
-
Rimay ejecuta un circuito por fila, con las filas de entrenamiento y de prueba juntas. Un solo trabajo puede solicitar como máximo 10 millones de ejecuciones, por lo que el número de filas multiplicado por
shotsdebe mantenerse dentro de ese presupuesto.
Comprueba ambos límites antes de enviar el trabajo.
Un trabajo también debe terminar en un plazo de 24 horas, incluido el tiempo que sus circuitos esperan en la cola; de lo contrario, se detiene sin devolver un resultado.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Calcula el tamaño de la función
Cada trabajo se ejecuta con un tamaño de función, S, M o L, que selecciona los recursos de cómputo en los que se ejecuta. En el caso de Rimay, el tamaño depende del número de filas que asigna un trabajo, con las filas de entrenamiento y de prueba juntas. Si solicitas un tamaño demasiado pequeño, el trabajo falla con el error 4600. Para conocer los tamaños y sus límites, consulta Function sizes en la guía de Rimay.
La siguiente celda define el calculador de tamaño. Se ejecuta en tu máquina, lee solo los datos que le pasas y no envía nada.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Pasa los conjuntos de datos en el mismo orden que los archivos de input_file, junto con el modo de la ejecución:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Paso 3: Ejecutar con las primitivas de Qiskit
Ejecuta Rimay en modo fit-transform. Ajusta una asignación cuántica de características con x_train.csv y y_train.csv, y asigna con ella tanto el conjunto de entrenamiento como el de prueba. El orden de los archivos en input_file importa. Indica primero las características de entrenamiento, luego las etiquetas de entrenamiento y, por último, las características de prueba opcionales. Pasa el tamaño que calculaste como function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Monitorea el trabajo
Comprueba el estado del trabajo mientras se ejecuta. job.result() bloquea hasta que el trabajo ha terminado.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
El resultado contiene un mapping_id, que identifica la asignación que ajustó esta ejecución. No lo necesitas en este tutorial, porque el conjunto de prueba se asignó en la misma ejecución. Guarda este ID si quieres asignar filas nuevas más adelante con mode="transform". Es la única forma de acceder a la asignación ajustada y, sin él, debes ajustar y pagar una nueva. La asignación se construye para la disposición de qubits de este procesador, por lo que una ejecución transform posterior debe pasar el mismo backend_name.
mapping_id = result["mapping_id"]
Paso 4: Posprocesar y devolver el resultado en el formato clásico deseado
Descarga las características transformadas cuánticamente
Descarga los archivos que escribió el trabajo, usando los nombres de output_files. Cada nombre empieza con el ID del trabajo, por lo que los archivos de esta ejecución siguen disponibles después de ejecuciones posteriores. Pasa target_name para que cada archivo se guarde con su propio nombre.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Entrena con las características transformadas cuánticamente
Entrena un bosque aleatorio solo con las características transformadas cuánticamente.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Entrena con las características clásicas y cuánticas combinadas
Apila las características originales y las transformadas cuánticamente, y entrena el mismo modelo con la combinación.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Compara los resultados
Compara los tres modelos en el conjunto de prueba.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

El AUC mide qué tan bien un modelo ordena los créditos buenos por encima de los malos, independientemente de un umbral de decisión, lo que lo convierte en la métrica más informativa en este conjunto de datos desbalanceado (70 % de créditos buenos). En los benchmarks de Kipu Quantum, las características transformadas cuánticamente por sí solas alcanzaron un AUC similar al de la línea base clásica, y el modelo híbrido, que combina ambas, alcanzó el AUC y la puntuación F1 más altos. Por lo tanto, las características transformadas cuánticamente aportan información que las características clásicas no proporcionan por sí solas.
Limpieza (opcional)
Una asignación ajustada permanece disponible hasta que la elimines. Si no quieres asignar más datos con ella, elimínala. Una eliminación no realiza trabajo cuántico, no usa tiempo de QPU y no se puede deshacer.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Conclusión
Lo que lograste
En este tutorial, lograste lo siguiente:
-
Preparaste un conjunto de datos reales de riesgo crediticio con atributos categóricos y numéricos para la extracción cuántica de características.
-
Estableciste una línea base de bosque aleatorio clásico.
-
Usaste Rimay para ajustar una asignación cuántica de características en hardware cuántico y asignar los conjuntos de entrenamiento y de prueba en una sola ejecución.
-
Entrenaste el mismo modelo con características transformadas cuánticamente y con características combinadas, y las comparaste con la línea base.
Puntos clave
-
Rimay encaja en un flujo de aprendizaje automático existente como un paso adicional de preprocesamiento. Conservas tu preparación de datos y tu modelo clásico.
-
El número de qubits limita el número de características de entrada, y el número de filas multiplicado por
shotslimita el tamaño de un solo trabajo. -
Usa por defecto las características transformadas cuánticamente combinadas con las características originales, porque el modelo puede aprovechar ambas.
Próximos pasos
- Lee la guía de Rimay para conocer todas las entradas, asignar datos nuevos con
mode="transform"y ver más benchmarks. - Lee cómo se aplicó la extracción cuántica de características a la clasificación de imágenes satelitales [3].
Referencias
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.