Optimization Solver: una Qiskit Function de Q-CTRL Fire Opal
Consulta la referencia de API
Las Qiskit Functions son una función experimental disponible únicamente para usuarios del Plan Premium, el Plan Flex y el Plan On-Prem (a través de la API de IBM Quantum Platform) de IBM Quantum®. Se encuentran en estado de versión preliminar y están sujetas a cambios.
Versiones de paquetes
El código de esta página fue desarrollado con los siguientes requisitos. Recomendamos usar estas versiones o más recientes.
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
Descripción general
Con el Fire Opal Optimization Solver, puedes resolver problemas de optimización a escala utilitaria en hardware cuántico sin necesidad de experiencia en computación cuántica. Simplemente introduce la definición del problema de alto nivel y el Solver se encarga del resto. Todo el flujo de trabajo es consciente del ruido y aprovecha la Gestión del rendimiento de Fire Opal internamente. El Solver ofrece de manera consistente soluciones precisas a problemas difíciles de resolver de forma clásica, incluso a escala de dispositivo completo en los QPUs IBM® más grandes.
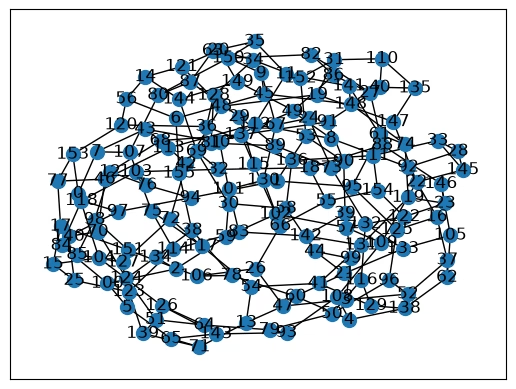
El Solver es flexible y puede utilizarse para resolver problemas de optimización combinatoria definidos como funciones objetivo o grafos arbitrarios. No es necesario mapear los problemas a la topología del dispositivo. Se pueden resolver tanto problemas sin restricciones como con restricciones, y las restricciones se imponen como restricciones estrictas de peso de Hamming 1, no como términos de penalización. Los ejemplos incluidos en esta guía demuestran cómo resolver un problema de optimización a escala utilitaria sin restricciones y uno con restricciones, usando diferentes tipos de entrada del Solver. El primer ejemplo involucra un problema max-cut definido en un grafo 3-regular de 156 nodos, mientras que el segundo aborda un problema de partición de grafos de 50 nodos definido por una función de costo.
Para obtener acceso al Optimization Solver, contacta a Q-CTRL.
Descripción de la función
El Solver optimiza y automatiza por completo todo el algoritmo, desde la supresión de errores a nivel de hardware hasta el mapeo eficiente del problema y la optimización clásica en bucle cerrado. En segundo plano, el pipeline del Solver reduce los errores en cada etapa, habilitando el rendimiento mejorado necesario para escalar de manera significativa. El flujo de trabajo subyacente está inspirado en el Quantum Approximate Optimization Algorithm (QAOA), que es un algoritmo híbrido cuántico-clásico. Para un resumen detallado del flujo de trabajo completo del Optimization Solver, consulta el manuscrito publicado.
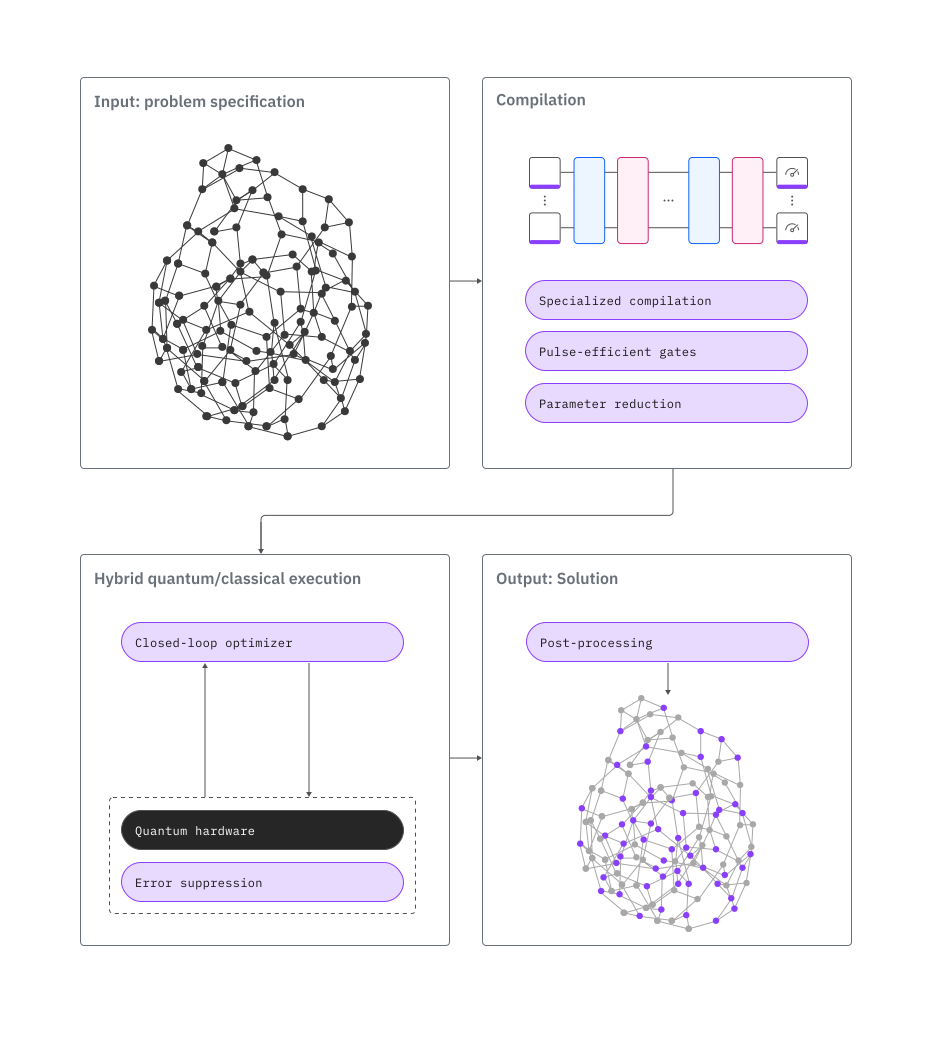
Para resolver un problema genérico con el Optimization Solver:
- Define tu problema como una función objetivo, un grafo o una cadena de espín
SparsePauliOp. - Conéctate a la función a través del Qiskit Functions Catalog.
- Ejecuta el problema con el Solver y recupera los resultados.
Formatos de problema aceptados
-
Representación en expresión polinómica de una función objetivo. Idealmente creada en Python con un objeto SymPy Poly existente y formateada como cadena de texto usando sympy.srepr.
-
Representación en grafo de un tipo de problema específico. El grafo debe crearse usando la librería networkx en Python. Luego debe convertirse a cadena de texto usando la función de networkx
nx.readwrite.json_graph.adjacency_data. -
Representación en cadena de espín de un problema específico. La cadena de espín debe representarse como un objeto
SparsePauliOp; consulta la documentación para más detalles.
Si deseas usar un backend que esta función no admite actualmente, contacta a Q-CTRL para añadir soporte.
Benchmarks
El rendimiento puede depender tanto de la instancia del problema como de los pasos de procesamiento posteriores. En algunos casos, las muestras clásicas y las muestras generadas cuánticamente podrían lograr una calidad de solución final similar después de un posprocesamiento equivalente. Por lo tanto, la evaluación debería considerar el flujo de trabajo de optimización completo.
Los resultados de benchmarking publicados muestran que el Solver resuelve con éxito problemas con más de 120 qubits, superando incluso resultados previamente publicados en recocido cuántico y dispositivos de iones atrapados. Las siguientes métricas de benchmark ofrecen una indicación aproximada de la precisión y escalabilidad de los tipos de problemas basándose en algunos ejemplos. Las métricas reales pueden variar según diversas características del problema, como el número de términos en la función objetivo (densidad) y su localidad, el número de variables y el orden polinómico.
El "Número de qubits" indicado no es una limitación estricta, sino que representa umbrales aproximados donde puedes esperar una precisión de solución extremadamente consistente. Se han resuelto con éxito problemas de mayor tamaño, y se alienta a hacer pruebas más allá de estos límites.
La conectividad arbitraria de qubits está soportada en todos los tipos de problemas.
| Tipo de problema | Número de qubits | Ejemplo | Precisión | Tiempo total (s) | Uso de runtime (s) | Número de iteraciones |
|---|---|---|---|---|---|---|
| Problemas cuadráticos con conectividad dispersa | 156 | max-cut 3-regular | 100% | 1764 | 293 | 16 |
| Optimización binaria de orden superior | 156 | Modelo de vidrio de espín de Ising | 100% | 1461 | 272 | 16 |
| Problemas cuadráticos con conectividad densa | 50 | max-cut completamente conectado | 100% | 1758 | 268 | 12 |
| Problema restringido con restricciones estrictas | 50 | Partición de grafos ponderada con 8% de densidad de aristas | 100% | 1074 | 215 | 10 |
Primeros pasos
Primero, autentícate usando tu clave API de IBM Quantum. Luego, selecciona la Qiskit Function de la siguiente manera. (Este fragmento de código asume que ya has guardado tu cuenta en tu entorno local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"networkx": "networkx", "numpy": "numpy", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "sympy": "sympy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
Ejemplo: Optimización sin restricciones
Ejecuta el problema de corte máximo (max-cut). El siguiente ejemplo demuestra las capacidades del Solver en un problema max-cut de grafo 3-regular no ponderado de 156 nodos, aunque también puedes resolver problemas de grafos ponderados.
Además de qiskit-ibm-catalog, también necesitarás los siguientes paquetes para ejecutar este ejemplo: networkx y numpy. Puedes instalarlos descomentando la siguiente celda si estás ejecutando este ejemplo en un notebook con el kernel de IPython.
# %pip install networkx numpy
1. Define el problema
Puedes ejecutar un problema max-cut definiendo un problema de grafo y especificando problem_type='maxcut'.
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
El Solver acepta una cadena de texto como entrada para la definición del problema.
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. Ejecuta el problema
Cuando uses el método de entrada basado en grafos, especifica el tipo de problema.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Comprueba el estado de la carga de trabajo de tu Qiskit Function o recupera los resultados de la siguiente manera:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. Recupera el resultado
Recupera el valor de corte óptimo del diccionario de resultados.
El mapeo de las variables a la cadena de bits puede haber cambiado. El diccionario de salida contiene un subdiccionario variables_to_bitstring_index_map que ayuda a verificar el orden.
# Poll for results
maxcut_result = maxcut_job.result()

# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])

# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
Puedes verificar la precisión del resultado resolviendo el problema de forma clásica con solvers de código abierto como PuLP si el grafo no tiene conectividad densa. Los problemas de alta densidad pueden requerir solvers clásicos avanzados para validar la solución.
Ejemplo: Optimización con restricciones
El ejemplo anterior de max-cut es un problema común de optimización binaria cuadrática sin restricciones. El Optimization Solver de Q-CTRL también puede resolver problemas de optimización con restricciones pasando restricciones estrictas directamente al Solver a través de la entrada constraint, en lugar de codificarlas como términos de penalización en la función objetivo. El Solver actualmente admite restricciones de peso de Hamming 1: cada restricción especifica un grupo de variables donde exactamente una variable debe ser igual a 1 y el resto debe ser igual a 0.
El siguiente ejemplo demuestra cómo construir una función de costo y un conjunto de restricciones estrictas para un problema de optimización con restricciones, el particionamiento de grafos, asignando cada nodo de un grafo a exactamente uno de varios grupos mientras se minimiza el peso total de las aristas cuyos extremos caen en el mismo grupo.
Además de los paquetes qiskit-ibm-catalog y qiskit, también usarás los siguientes paquetes para ejecutar este ejemplo: numpy, networkx y sympy. Puedes instalar estos paquetes descomentando la siguiente celda si estás ejecutando este ejemplo en un notebook con el kernel de IPython.
# %pip install numpy networkx sympy
1. Define el problema
Define un problema aleatorio de particionamiento de grafos generando un grafo con nodos de peso aleatorio.
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
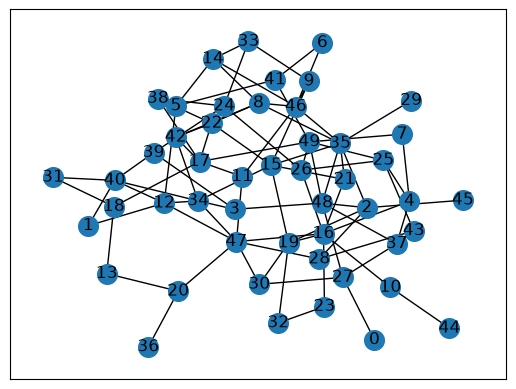
Un modelo de optimización estándar para el particionamiento de grafos ponderados puede formularse de la siguiente manera. Divide los nodos del grafo en tres grupos , y sea si el nodo está asignado al grupo , y en caso contrario. El objetivo es minimizar el peso total de las aristas cuyos extremos están asignados al mismo grupo, donde el peso de una arista es el peso combinado de sus dos extremos, :
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
Cada nodo debe asignarse a exactamente uno de los tres grupos. Esta es una restricción de peso de Hamming 1: para cada nodo , exactamente uno de debe ser igual a 1, y el resto debe ser igual a 0:
En lugar de codificar este requisito como un término de penalización en la función de costo, pásalo directamente al Solver como una restricción estricta usando la entrada constraint.
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
No necesitas añadir todas las variables a constraint. Cualquier variable que se deje fuera del diccionario permanece sin restricciones, por lo que puedes combinar grupos de variables con restricciones estrictas con variables libres en el mismo problema.
2. Ejecuta el problema
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Comprueba el estado de la carga de trabajo de tu Qiskit Function o recupera los resultados de la siguiente manera:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. Obtén el resultado
Recupera la solución y analiza los resultados. El costo de la solución representa el peso total de las aristas cuyos extremos terminaron en el mismo grupo, por lo que un costo más bajo indica un mejor particionamiento del grafo.
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
Obtener soporte
Para cualquier pregunta o problema, contacta a Q-CTRL.
Registro de cambios
-
2026-08-10: Se añadió soporte para restricciones estrictas (peso de Hamming 1) a través de la entrada
constraint, y se actualizó el ejemplo de optimización con restricciones para usarlas. -
2026-02-11: Ahora se admite
ibm_miami.
Próximos pasos
-
Solicita acceso al Q-CTRL Optimization Solver.
-
Visita la referencia de API de esta Qiskit Function.
-
Prueba el tutorial Resuelve problemas de optimización binaria de orden superior con el Optimization Solver de Q-CTRL.
-
Revisa el caso de estudio de Mazda.
-
Revisa el caso de estudio de Network Rail.
-
Revisa el caso de estudio del Ejército Australiano.
-
Revisa el caso de estudio de Transport for New South Wales.