Parity Twine Optimizer: una función de Qiskit de ParityQC
Consulta la referencia de la API
Las Qiskit Functions son una función experimental disponible únicamente para los usuarios de los planes IBM Quantum® Premium Plan, Flex Plan y On-Prem (a través de la API de IBM Quantum Platform). Se encuentran en estado de versión preliminar y están sujetas a cambios.
Información general
El Parity Twine Optimizer permite a los usuarios resolver problemas de optimización con computadoras cuánticas utilizando el método Parity Twine. Este enfoque, basado en la Parity Architecture, utiliza el compilador de ParityQC para minimizar el número de puertas y la profundidad del circuito necesarios para ejecutar un algoritmo cuántico, teniendo en cuenta la conectividad del dispositivo.
Esta reducción de recursos permite resolver problemas de optimización relevantes para la industria en tamaños que resultan inviables con los métodos de transpilación estándar, que hacen un uso intensivo de SWAP. El Parity Twine Optimizer automatiza los pasos de transpilación y puede utilizarse con una mínima intervención del usuario.
El enfoque Parity Twine supera a todos los demás métodos de compilación en términos de reducción del número de puertas y de la profundidad de los circuitos para algoritmos cuánticos como el algoritmo de optimización aproximada cuántica (QAOA) y la transformada cuántica de Fourier (QFT). Al abstraer la información cuántica de los qubits físicos, las interacciones no locales se implementan sin puertas SWAP. En cambio, las cadenas Parity Twine (secuencias de puertas CNOT) distribuyen sistemáticamente la información de paridad lógica entre los qubits.
El optimizador utiliza el QAOA para minimizar la energía de una función de costo dada. El QAOA es un algoritmo variacional híbrido cuántico-clásico diseñado para resolver problemas de optimización combinatoria aproximando el estado fundamental de un hamiltoniano de costo (). Un término de mezcla () impulsa las transiciones entre estados para explorar el espacio de soluciones. Una secuencia alternante de estos términos, controlada por los parámetros y , define la unitaria , que actúa sobre el estado inicial.
La codificación de la unitaria del problema, exp(), requiere codificar todos los operadores lógicos de rotación de cuerpos (exp()). Esto puede lograrse utilizando generadores de cuerpos (Parity Twine Networks), que reducen la profundidad del circuito de QAOA y el número de puertas de dos qubits.
Descripción
La entrada del Parity Twine Optimizer consiste en un problema de optimización, el nombre del hardware de IBM Quantum elegido y argumentos opcionales adicionales para personalizar los ajustes de transpilación y de ejecución en el hardware. La función optimizadora dirige la definición del problema al Parity Twine Compiler. La Figura 1 muestra un resumen del flujo de trabajo de la función.
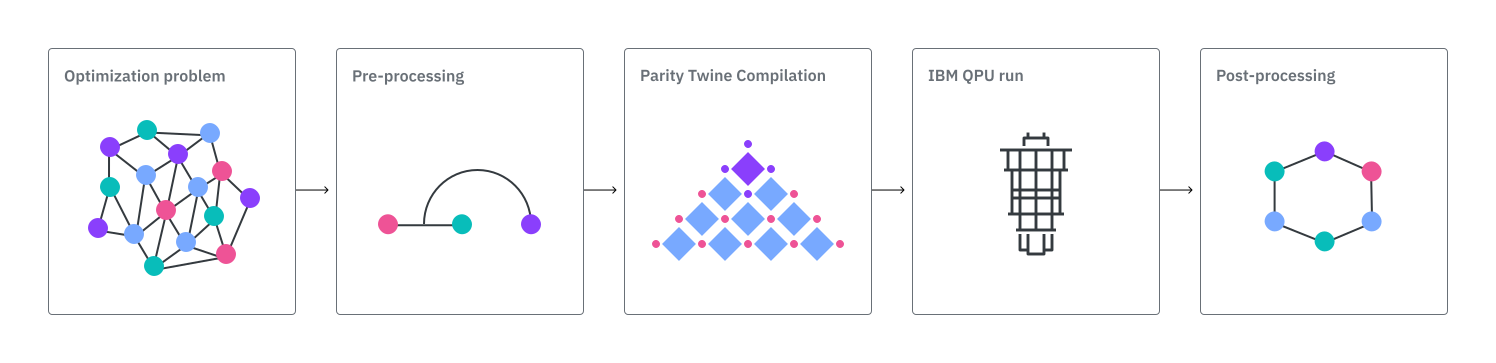
El problema de optimización de entrada se preprocesa para obtener un hamiltoniano (normalizado). A continuación, el compilador de ParityQC construye un circuito ansatz parametrizado de Parity Twine, que se transpila a un ansatz lógico que coincide con el conjunto nativo de puertas del hardware elegido.
Los parámetros del circuito de QAOA se optimizan de forma clásica utilizando el enfoque "efficient depth one" y se asignan al circuito transpilado. Como se utiliza una sola ronda de QAOA, los parámetros óptimos y se obtienen mediante una búsqueda en cuadrícula en una CPU, sin necesidad de una costosa optimización iterativa sobre muchas llamadas al circuito. Esto minimiza en gran medida el tiempo de ejecución en la QPU requerido por el optimizador. El tiempo de ejecución por circuito está determinado principalmente por la sobrecarga constante de ejecutar un trabajo en la QPU. Una vez configurados los parámetros del circuito, el trabajo se envía a la QPU de IBM® especificada.
Los resultados sin procesar se posprocesan a continuación. Este paso utiliza una búsqueda voraz local que recorre aleatoriamente la cadena de solución e invierte los valores de los bits si esto reduce el valor de la función de costo.
Benchmarks
El rendimiento puede depender tanto de la instancia del problema como de los pasos de procesamiento posteriores. En algunos casos, las muestras clásicas y las muestras generadas cuánticamente pueden alcanzar una calidad de solución final similar después de un posprocesamiento equivalente. Por lo tanto, la evaluación debe considerar el flujo de trabajo de optimización completo.
Modelo de Sherrington-Kirkpatrick
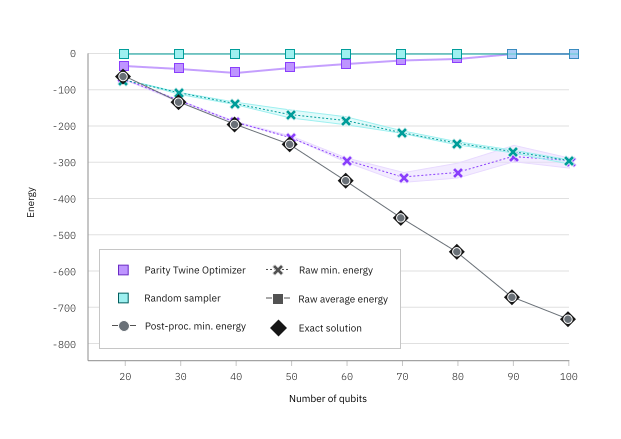
La Figura 2 demuestra la eficacia del Parity Twine Optimizer. En ella se comparan los resultados obtenidos con el optimizador frente al muestreo aleatorio para el modelo de Sherrington-Kirkpatrick con un número creciente de qubits.
El posprocesamiento tanto de los resultados aleatorios como de los del optimizador conduce a estados fundamentales exactos, pero la salida de energía mínima sin procesar de Twine QAOA siempre es mejor que los valores aleatorios. Para los números de qubits más grandes considerados (90 y 100), el ruido del hardware degrada el resultado del optimizador, que revierte a valores sin procesar equivalentes al muestreo aleatorio.
Consulta este tutorial para una introducción al modelo de Sherrington-Kirkpatrick y detalles sobre cómo resolverlo con el Parity Twine Optimizer.
Problema Market Split
La Tabla 1 muestra métricas de rendimiento específicas para el Parity Twine Optimizer aplicado a varias instancias del problema Market Split (MS). Estas se obtuvieron de la QOBLIB - Quantum Optimization Benchmarking Library y corresponden a envíos realizados a la biblioteca utilizando el Parity Twine Optimizer.
MS violation es una métrica de precisión que mide qué tan lejos está la solución de satisfacer todas las restricciones, definida como . Valores más bajos de esta métrica indican soluciones más precisas.
La Tabla 1 reporta los valores promediados de cinco ejecuciones de cada instancia utilizando el Parity Twine Optimizer con el dispositivo ibm_boston como backend y 100 000 shots.
Se reporta la MS violation mínima obtenida de las ejecuciones de cada instancia.
| Instancia | Qubits | Puertas de dos qubits | Profundidad de dos qubits | MS violation | Tiempo de mapeo (s) | Tiempo de ejecución en QPU (s) | Tiempo de posprocesamiento (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Tabla 1: Métricas de rendimiento para diferentes instancias del problema Market Split. Los nombres de las instancias corresponden a los ejemplos de la biblioteca de problemas QOBLIB. Como se mencionó anteriormente en la sección de descripción, el tiempo de QPU es mínimo y casi constante, ya que solo se utiliza una ronda de QAOA con parámetros óptimos del circuito obtenidos en una CPU.
Consulta este tutorial para una introducción al problema Market Split y detalles sobre cómo resolverlo con el Parity Twine Optimizer.
Problema del conjunto independiente máximo
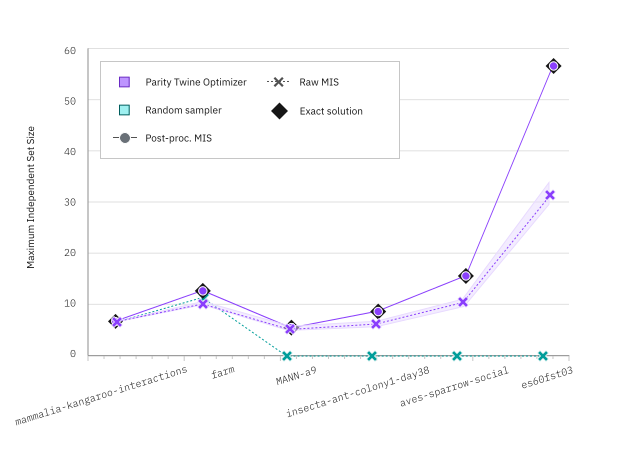
La Figura 3 compara los resultados obtenidos con el optimizador Parity Twine frente al muestreo aleatorio para el problema del conjunto independiente máximo en instancias seleccionadas obtenidas de la QOBLIB - Quantum Optimization Benchmarking Library. Estas van desde 18 (mammalia-kangaroo-interactions) hasta 114 (es60fst03) qubits.
Para instancias pequeñas, los resultados sin procesar del tamaño del conjunto independiente máximo del optimizador y del muestreo aleatorio son similares, pero para instancias más grandes, el optimizador ofrece resultados mucho mejores. El posprocesamiento de los resultados tanto del muestreo aleatorio como del optimizador conduce nuevamente a tamaños de conjunto que concuerdan con los valores exactos.
Primeros pasos
Autentícate utilizando tu token de la API de IBM Quantum Platform y selecciona la Qiskit Function de la siguiente manera:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Ejemplo
El Parity Twine Optimizer puede aplicarse a un ejemplo sencillo de QUBO de la siguiente manera. El problema se define primero mediante un diccionario:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Luego, el tipo de variable debe definirse como binary o spin:
variable_type = "spin"
Esto define la función objetivo donde .
Elige un backend. Por ejemplo:
backend_name = "ibm_phoenix"
Utiliza catalog.backends() para ver una lista de los backends disponibles de la cuenta/instancia del usuario.
Si no se especifica un backend, se selecciona automáticamente el backend menos ocupado (el que tiene el menor número de trabajos pendientes).
Una vez cargado el optimizador (ver más arriba), puedes ejecutarlo sobre el problema utilizando las opciones predeterminadas:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Comprueba el estado del trabajo de la siguiente manera:
# Monitor the job status
function_job.status()
Obtén los resultados de la siguiente manera:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
Al imprimir los resultados se obtiene lo siguiente:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
El diccionario solution corresponde a los qubits definidos en el problema ( y ) y proporciona sus valores de spin optimizados.
El objective_value es el costo o la energía del problema de optimización. Cuantifica la calidad de la solution.
metadata proporciona información sobre la transpilación (número de puertas/profundidad de dos qubits, puertas utilizadas, qubits activos) y varios tiempos de ejecución tanto para el cómputo cuántico como para el clásico.
Además, metadata ofrece una visión del funcionamiento interno del algoritmo. Puedes ver los parámetros variacionales optimizados (beta y gamma) y revisar cómo mejoró la distribución de las cadenas de bits medidas después de aplicar el posprocesamiento clásico a los resultados cuánticos sin procesar.
Todas las cadenas de bits de la salida del resultado pueden asignarse a las variables del problema utilizando variable_mapping.
Por ejemplo, puedes asignar 'solution_bitstring': '100' con 'variable_mapping': {'0': 0, '1': 1, '2': 2} a la solución binaria: {'0': 1, '1': 0, '2': 0}.
Como estás resolviendo el problema en términos de variables de spin, necesitas aplicar la transformación de binario a spin (0 -> 1, 1 -> -1 ).
Luego llegas a la solución final 'solution': {'0': -1, '1': 1, '2': 1}.
Consulta la referencia de la API para conocer todos los detalles de la entrada y la salida de la función Parity Twine Optimizer.
Registro de cambios
[1.0.2] - 2026-09-15
Notes
Esta versión marca la primera versión estable de producción de la Qiskit Function Parity Twine Optimizer. Se espera que las próximas versiones incorporen lo siguiente:
- compilación de problemas de orden superior,
- algoritmos de optimización adicionales, y
- mejoras en el preprocesamiento y el posprocesamiento.
Características
- Resuelve problemas QUBO dispersos y densos con el eficiente Parity Twine Compiler.
Documentación
- Guía de usuario para primeros pasos.
- Tutoriales con ejemplos para los problemas Market Split y Sherrington-Kirkpatrick.
- Documentación de la API.
Obtén ayuda
Contacta con ParityQC si tienes preguntas o problemas.
Próximos pasos
- Solicita acceso a la función completando este formulario.
- Visita la referencia de la API para esta Qiskit Function.
- Prueba el tutorial para aplicar el Parity Twine Optimizer al problema de Market Split.
- Prueba el tutorial para aplicar el Parity Twine Optimizer al modelo de Sherrington-Kirkpatrick.
- Revisa el preprint de ArXiv Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025).