Acotar la dimensión del subespacio
En esta guía práctica mostraremos el efecto de la dimensión del subespacio en la técnica de recuperación de configuraciones autoconsistente.
A priori, no sabemos cuál es la dimensión correcta del subespacio para obtener un nivel de precisión objetivo. Sin embargo, sí sabemos que aumentar la dimensión del subespacio aumenta la precisión del método. Por lo tanto, podemos estudiar la precisión de las predicciones en función de la dimensión del subespacio. Especifica la molécula y sus propiedades.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Genera algunas cadenas de bits aleatorias que hagan de sustituto de las muestras de QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Llama a SQD con tamaños de lote crecientes.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
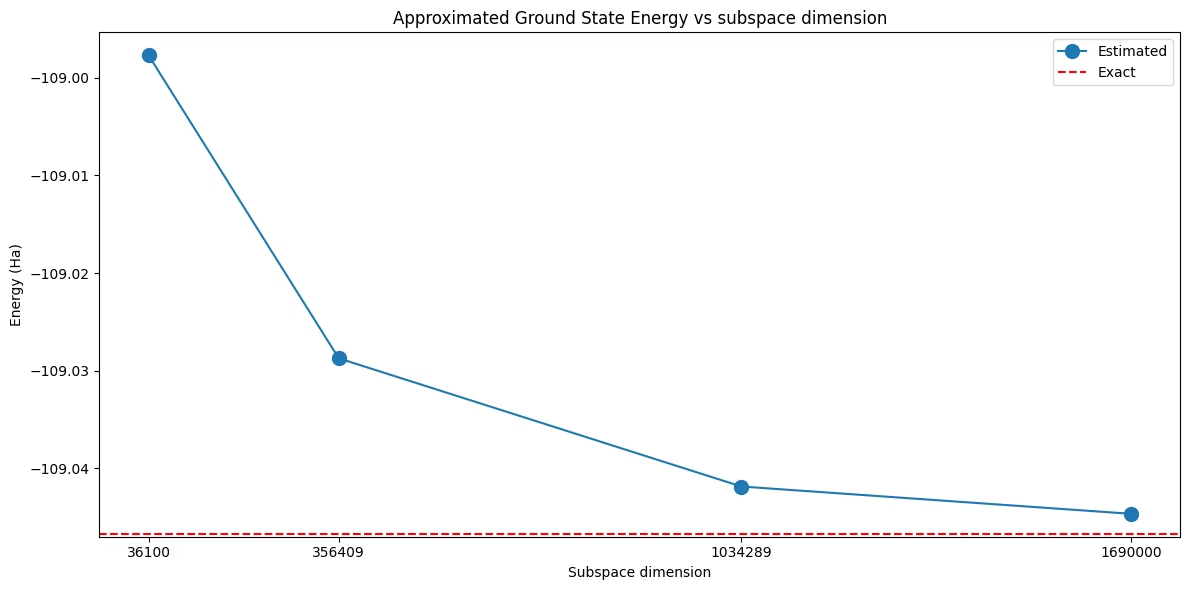
Este gráfico muestra que aumentar la dimensión del subespacio produce resultados más precisos.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Establecer un límite explícito con max_dim
En el barrido anterior, la dimensión del subespacio se controló solo de forma indirecta. samples_per_batch establece cuántas cadenas de bits se extraen en cada lote, pero la dimensión del subespacio resultante viene determinada por cuántas cadenas de espín alfa y espín beta distintas contienen esas cadenas de bits, y el conjunto de configuraciones disponible para el submuestreo crece de una iteración de recuperación de configuraciones a la siguiente. Por eso las dimensiones del subespacio en el eje horizontal anterior son números irregulares que no elegimos nosotros.
El argumento max_dim de diagonalize_fermionic_hamiltonian acota la dimensión directamente. Limita el número de cadenas CI que se conservan en cada sector de espín y, dado que el subespacio está generado por el producto cartesiano de los dos sectores, su dimensión es el producto de las dimensiones de ambos sectores:
-
max_dim=dlimita ambos sectores adcadenas, por lo que la dimensión del subespacio es como máximod ** 2. -
max_dim=(d_a, d_b)limita por separado los sectores de espín alfa y espín beta, por lo que la dimensión del subespacio es como máximod_a * d_b. Cuandosymmetrize_spin=True, los dos límites deben ser iguales. -
max_dim=None, el valor predeterminado, no impone ningún límite.
Cuando un lote contiene más cadenas de las que permite el límite, se descartan las menos importantes: primero se conservan las cadenas pasadas mediante include_configurations, después las cadenas arrastradas de la iteración anterior (consulta carryover_threshold) y los espacios restantes se rellenan con las cadenas muestreadas, en orden decreciente de la frecuencia con que fueron muestreadas.
Dado que max_dim limita el tamaño de la mayor diagonalización que se le pedirá realizar al solucionador de estados propios, es una forma cómoda de mantener el solucionador dentro de un presupuesto de tiempo de ejecución y memoria: elige un samples_per_batch generoso y deja que max_dim decida hasta qué tamaño puede crecer el subespacio.
A continuación repetimos el estudio, esta vez manteniendo fijo samples_per_batch y aumentando max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
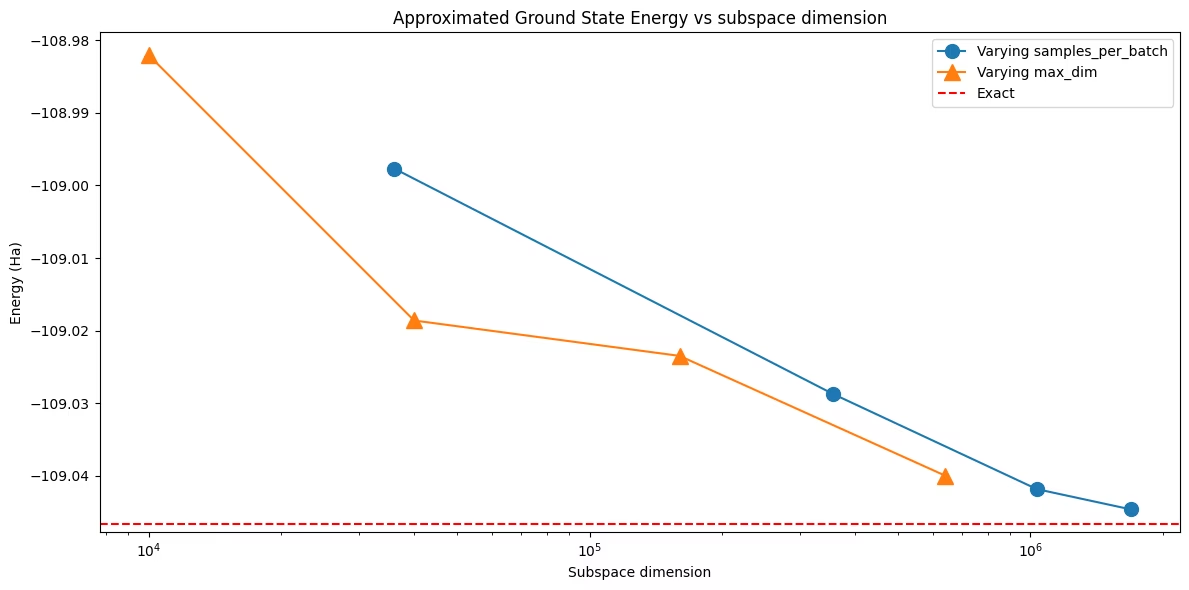
Ahora la dimensión del subespacio es exactamente max_dim ** 2 en cada ejecución: se eligió en lugar de descubrirse. Representar ambos barridos juntos muestra que la precisión depende de la propia dimensión del subespacio, sea cual sea el argumento utilizado para llegar a ella. Sin embargo, las dos curvas no tienen por qué coincidir exactamente. Las ejecuciones con max_dim extraen 600 cadenas de bits por lote y luego conservan las cadenas muestreadas con más frecuencia, por lo que, para una dimensión dada, pueden retener un mejor conjunto de configuraciones que una ejecución que llegó a esa dimensión muestreando menos cadenas de bits desde el principio.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()