Actualiza las propiedades del backend con evaluación comparativa en tiempo real
Estimación de uso: 3 minutos en ibm_kingston (NOTA: Esto es solo una estimación. Tu tiempo de ejecución puede variar.)
Resultados de aprendizaje
-
Por qué las propiedades reportadas por una QPU pueden quedar rezagadas respecto al comportamiento actual del dispositivo, y cuándo vale la pena volver a medirlas tú mismo
-
Qué mide cada uno de los cinco experimentos de caracterización estándar (lectura, benchmarking aleatorizado de un qubit, benchmarking aleatorizado de dos qubits en capas, , y )
-
Cómo ejecutar la suite completa de caracterización en una sola llamada o paso a paso, y obtener de vuelta un objeto backend con propiedades actualizadas
-
Cómo comparar las propiedades medidas con las reportadas, y por qué algunas diferencias reflejan la metodología de medición en lugar de la deriva del dispositivo
Prerrequisitos
-
El flujo de trabajo de patrones de Qiskit
-
Modos de ejecución de Qiskit Runtime, en particular batch mode
-
Cómo explorar la información de la QPU, como las propiedades del backend y los datos de calibración
Contexto
Cada QPU de IBM Quantum® reporta un conjunto de propiedades que describen qué tan bien está funcionando actualmente cada uno de sus qubits: tiempos de relajación (), tiempos de coherencia (), errores de lectura, y errores de compuerta de uno y dos qubits. Estos números importan en la práctica. El transpiler los usa para decidir en qué qubits físicos debería ejecutarse tu circuito, las técnicas de mitigación de errores dependen de ellos, y podrías usarlos para juzgar si un dispositivo funciona lo suficientemente bien para un experimento.
Las propiedades reportadas provienen de procedimientos de calibración que normalmente se ejecutan aproximadamente una vez al día. Sin embargo, los qubits superconductores pueden derivar en escalas de tiempo más cortas, y los defectos transitorios (los llamados sistemas de dos niveles) pueden degradar temporalmente un qubit que se veía excelente en el momento de la calibración. Además, un trabajo a menudo se transpila mucho antes de que realmente se ejecute, por lo que las decisiones basadas en las propiedades reportadas pueden basarse en información obsoleta. El tutorial Evaluación comparativa en tiempo real para la selección de qubits muestra cuánto pueden fluctuar estas propiedades de un día a otro, y construye a mano un flujo de trabajo de caracterización completo a partir de Qiskit Experiments individuales.
Este tutorial muestra la versión optimizada de ese flujo de trabajo, usando la utilidad BackendCharacterization de Qiskit Device Benchmarking, que empaqueta la construcción de experimentos, el envío de trabajos y el ajuste de curvas en unas pocas llamadas. Gastas aproximadamente 70 segundos de tiempo de QPU y obtienes de vuelta un objeto backend cuyas propiedades reflejan el dispositivo en este momento, listo para ser comparado con los valores reportados o pasado a herramientas posteriores.
Los experimentos de caracterización
El conjunto mide cinco propiedades, cada una con un experimento estándar:
-
Error de lectura (
readout): Cada qubit se prepara en o y se mide inmediatamente. La probabilidad de leer el estado incorrecto da el error de preparación y medición del estado (SPAM). -
Error de compuerta de un qubit (
rb_1q): El benchmarking aleatorizado (RB) ejecuta secuencias de compuertas Clifford de un qubit aleatorias que idealmente componen la identidad. La forma en que la probabilidad de supervivencia decae con la longitud de la secuencia da el error promedio por compuerta, independiente de los errores SPAM. -
Error de compuerta de dos qubits (
rb_2q): La misma idea de RB aplicada a capas completas de compuertas de dos qubits que no se superponen ejecutadas simultáneamente, como en un experimento de fidelidad de capa. Debido a que muchas compuertas se ejecutan a la vez, las tasas de error resultantes incluyen efectos de crosstalk y son más cercanas a lo que realmente experimenta un circuito profundo. -
(
t1): Cada qubit se excita y se mide después de retrasos crecientes. El decaimiento de la población del estado excitado da el tiempo de relajación. -
(
t2): Un experimento de eco de Hahn coloca cada qubit en una superposición, aplica un pulso de eco a la mitad de un retraso, y mide qué tan rápido se pierde la coherencia de fase. Por defecto se usa un solo eco; al final de este tutorial se demuestra una variante multi-eco (estilo CPMG).
Qué hace y qué no hace la actualización
Ten en cuenta tres puntos al usar este flujo de trabajo:
-
Las propiedades actualizadas viven solo en el objeto backend que se te devuelve. Nada cambia en el dispositivo en sí ni en los datos de calibración que IBM Quantum reporta a otros usuarios.
-
Los valores medidos son una instantánea tomada con una metodología particular. Algunos de ellos, notablemente los errores de dos qubits en capas y los valores de de eco único en paralelo, se miden de manera diferente a los datos de calibración reportados, por lo que parte de cualquier brecha que observes es metodológica en lugar de deriva. Este tutorial señala dónde ocurre eso.
-
La caracterización en sí cuesta tiempo de QPU (unos 70 segundos para el conjunto completo en un procesador Heron r2), que es el precio de tener información actualizada.
El flujo de trabajo sigue los cuatro pasos de un patrón de Qiskit:
-
Paso 1: Mapear entradas clásicas a un problema cuántico. Elige el dispositivo y el conjunto de propiedades a medir.
-
Paso 2: Optimizar el problema para la ejecución en hardware cuántico. La utilidad construye los circuitos del experimento directamente en las compuertas nativas del dispositivo y los paraleliza a través del chip.
-
Paso 3: Ejecutar usando primitivas de Qiskit. Los experimentos se ejecutan como trabajos de Sampler dentro de un batch.
-
Paso 4: Post-procesar y devolver el resultado en el formato clásico deseado. Ajusta los datos de medición a mapas de error por qubit, actualiza el backend, y compara las propiedades medidas con las reportadas.
Requisitos
Antes de comenzar este tutorial, asegúrate de tener instalado lo siguiente:
-
Qiskit SDK v2.0 o posterior, con soporte de visualización
-
Qiskit Runtime v0.40 o posterior (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, que también instala Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Configuración
Importa las bibliotecas necesarias.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
El conjunto de caracterización construye varios experimentos, envía múltiples trabajos, y ajusta los resultados, lo que puede tardar un par de minutos en total. Habilita el registro de nivel INFO para que cada etapa imprima su progreso a medida que ocurre.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Ejemplo de simulador a pequeña escala
Este tutorial no incluye un ejemplo de simulador. El flujo de trabajo mide las imperfecciones físicas de un dispositivo específico: qué tan rápido se relajan y desfasan sus qubits, y con qué frecuencia fallan sus compuertas y su lectura. Un simulador ideal no tiene ninguna de estas imperfecciones, por lo que no hay nada que caracterizar. Podrías adjuntar un modelo de ruido sintético a un backend simulado, pero los experimentos entonces solo recuperarían los números que tú mismo introdujiste. Por esa razón, procedemos directamente al hardware, dividido en los cuatro pasos de un patrón de Qiskit.
Ejemplo de hardware a gran escala
Paso 1: Mapear entradas clásicas a un problema cuántico
En este flujo de trabajo el "problema" es el propio dispositivo: las entradas clásicas son la QPU que quieres caracterizar y la lista de propiedades a medir, y los experimentos cuánticos son los circuitos de caracterización generados a partir de ellas.
Primero, selecciona un backend. Este tutorial usa ibm_kingston, un procesador Heron r2 de 156 qubits; puedes sustituirlo por cualquier dispositivo de IBM Quantum al que tengas acceso (o elegir uno con service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
A continuación, elige qué propiedades medir. Puedes pasar cualquier subconjunto de los siguientes experimentos:
-
readout: experimento SPAM (preparación y medición del estado) -
rb_1q: benchmarking aleatorizado de un qubit aislado -
rb_2q: benchmarking aleatorizado simultáneo de dos qubits a partir de un experimento de fidelidad de capa -
t2: experimento de eco de Hahn de (un solo eco por defecto) -
t1: experimento de relajación de
Ejecuta el conjunto completo para obtener una imagen completa del dispositivo; elimina entradas de la lista si solo te interesan algunas propiedades y quieres ahorrar tiempo de QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Paso 2: Optimizar el problema para la ejecución en hardware cuántico
En la mayoría de los tutoriales aquí es donde transpilarías tus circuitos. En este caso, BackendCharacterization se encarga de eso internamente. Construye los circuitos del experimento directamente en las compuertas nativas del dispositivo, ejecuta los experimentos de un qubit en todos los qubits en paralelo, y programa el benchmarking de dos qubits sobre capas disjuntas del mapa de acoplamiento de modo que todo el dispositivo quede cubierto con un puñado de trabajos. Debido a esta paralelización, todo el conjunto consume solo unos 70 segundos de tiempo de QPU.
Inicializa la clase que gestiona el flujo de trabajo:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Paso 3: Ejecutar usando primitivas de Qiskit
El método run_experiments construye los circuitos y los envía como trabajos de Sampler. Ejecútalo dentro de un contexto Batch para que los trabajos se programen juntos en la QPU, y el método retorna una vez que todos los trabajos se han enviado. (También puedes ejecutarlo fuera de un batch, o dentro de una Session.)
Es posible que veas una advertencia sobre un backend que se pasa mientras un gestor de contexto de sesión está abierto. Esto es esperado y se puede ignorar de forma segura.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
El método devuelve los trabajos enviados como un diccionario indexado por experimento, lo cual es útil para rastrearlos en el panel de IBM Quantum Platform o para depuración.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Paso 4: Post-procesar y devolver el resultado en el formato clásico deseado
Analizar los resultados
El método analyze_results espera a que los trabajos terminen y ajusta los datos de medición: decaimientos exponenciales para y , decaimientos de probabilidad de supervivencia para los experimentos de RB, y matrices de asignación para la lectura. Devuelve un diccionario de mapas de error, una entrada por propiedad medida, cada una asignando a un qubit (o par de qubits) su valor medido.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Los mapas cubren el error de lectura, los errores de las compuertas de un qubit x y sx, los errores de dos qubits en capas (lf_error_map, del experimento de fidelidad de capa), y los tiempos y en segundos.
Actualizar las propiedades del backend
El método update_backend escribe los valores medidos en las propiedades de una copia del backend y la devuelve. El objeto backend original conserva los datos de calibración reportados, para que podamos comparar ambos, como se muestra a continuación. Recuerda que esta actualización es puramente local a tu sesión de Python; no cambia nada en el dispositivo ni para otros usuarios.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Comparar las propiedades medidas con las reportadas
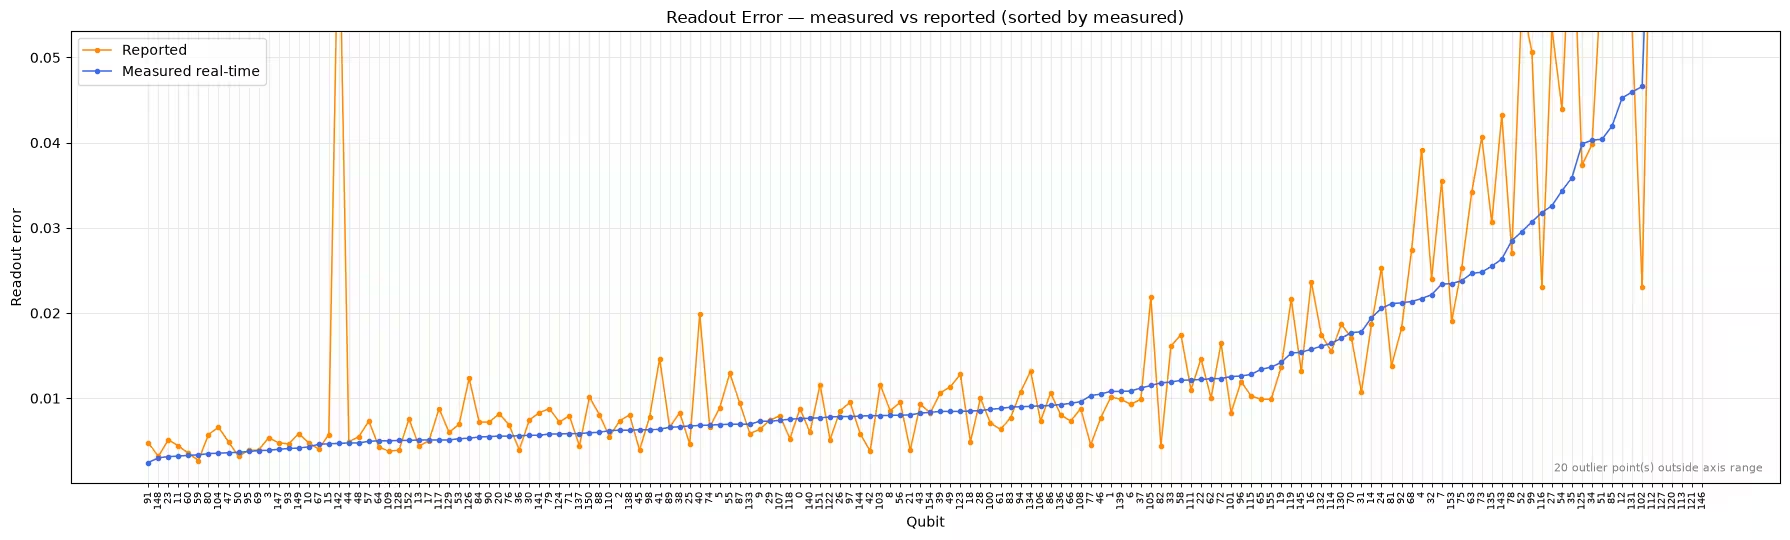
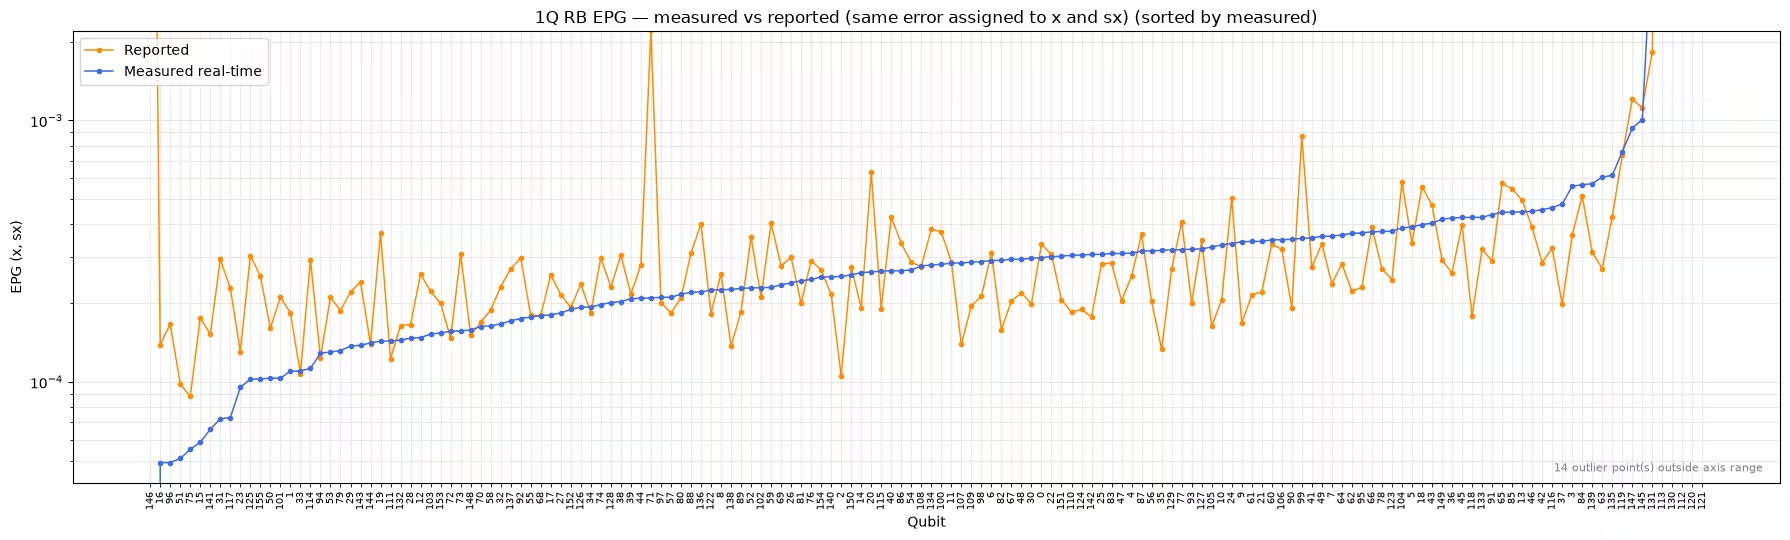
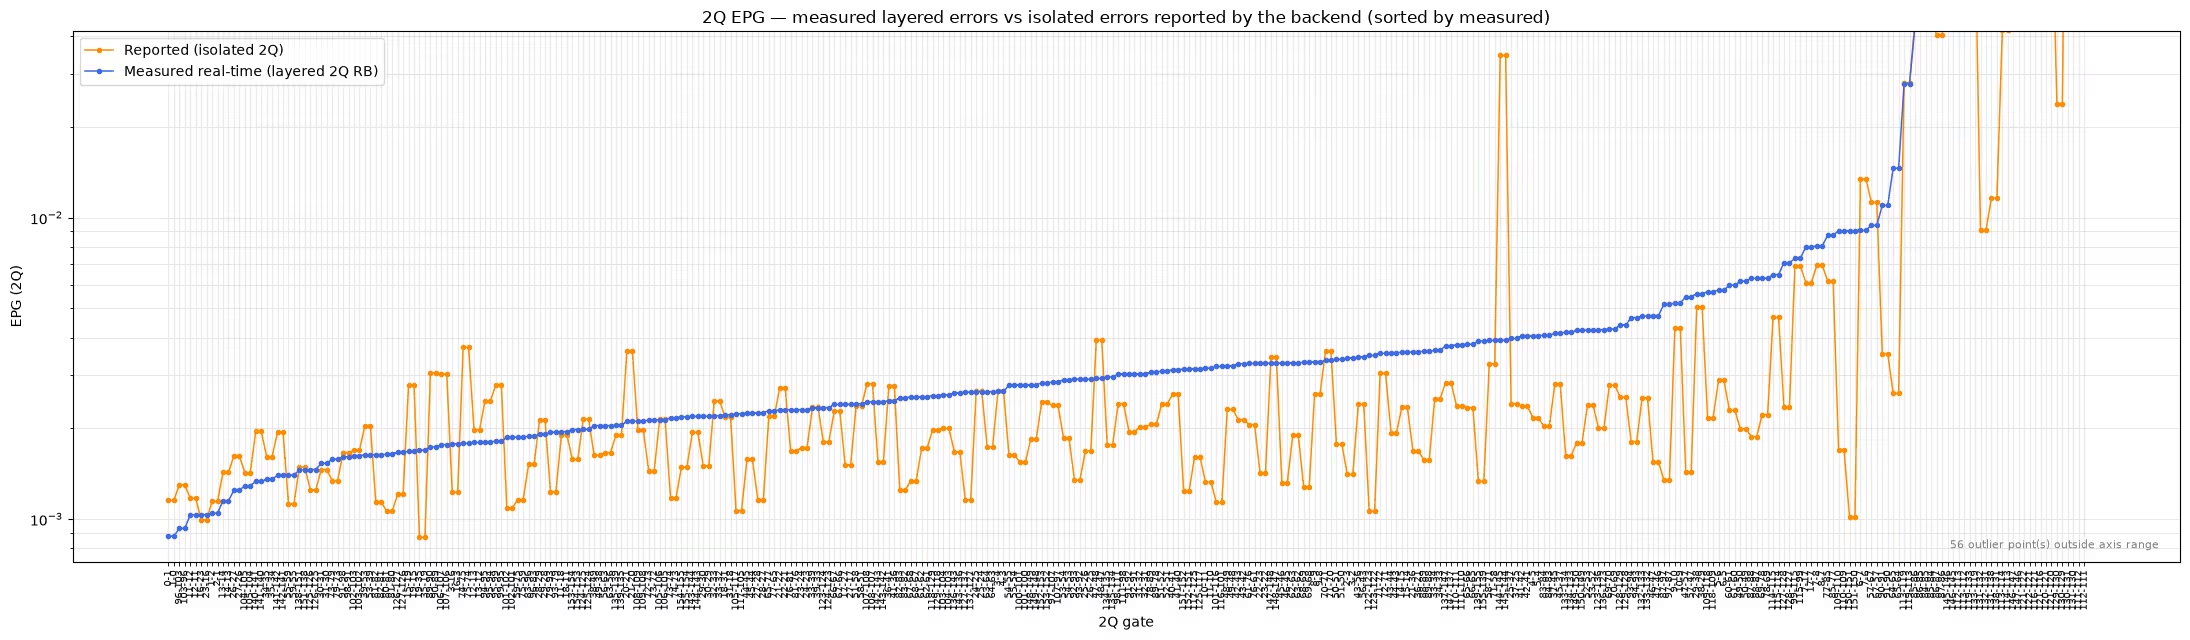
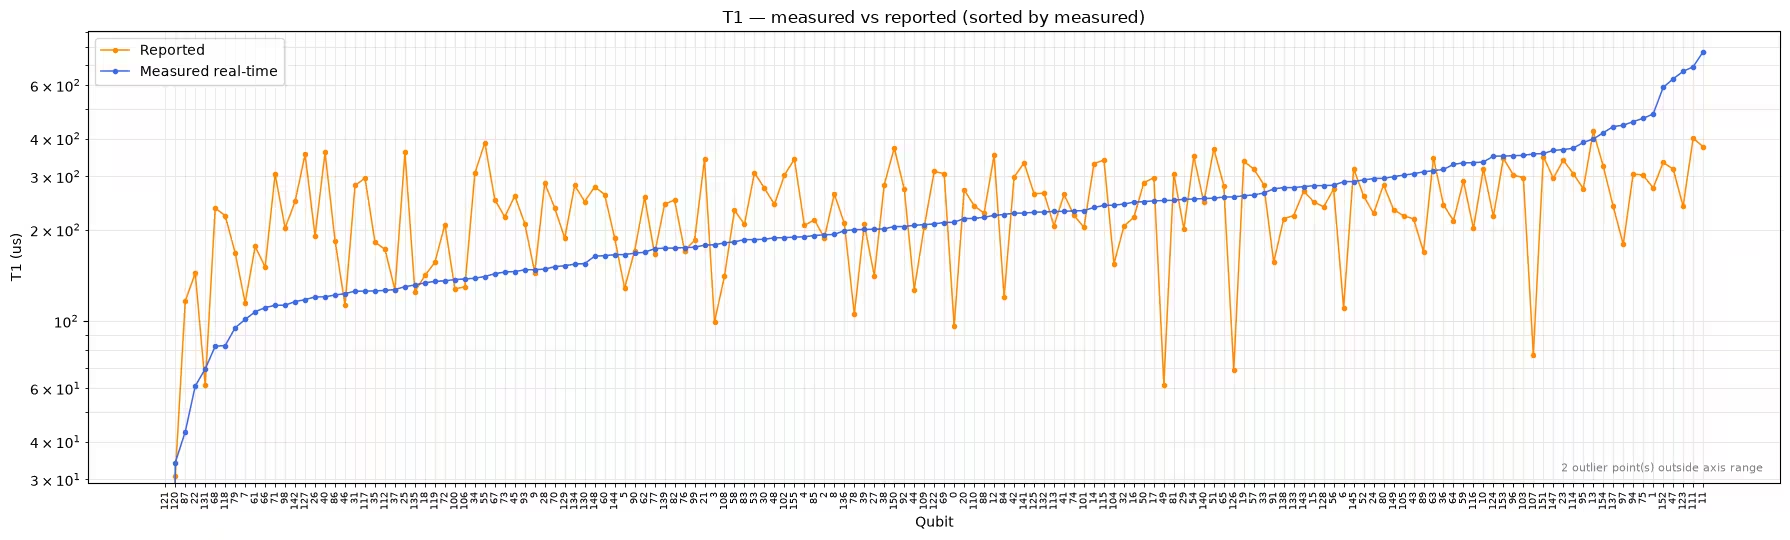
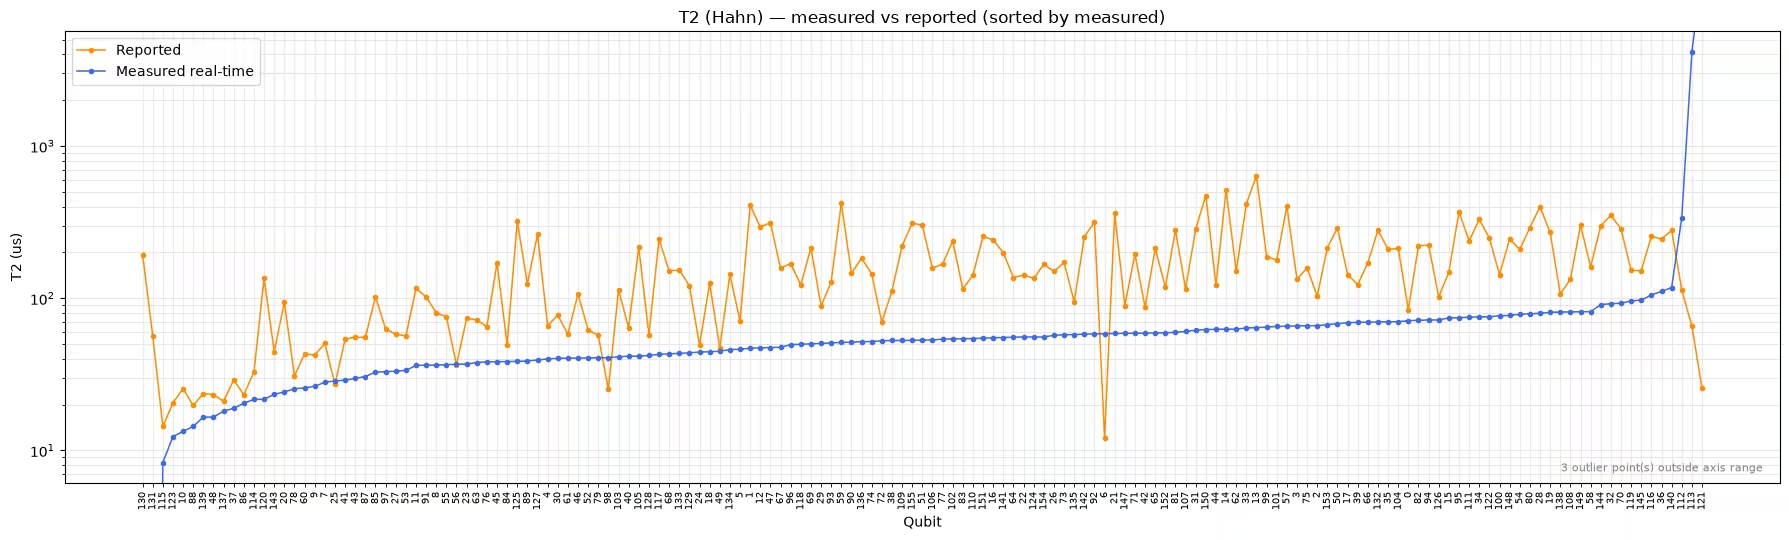
Finalmente, grafica las propiedades medidas en tiempo real frente a los valores que reporta el backend. En cada panel los qubits (o pares de qubits) están ordenados por el valor medido, por lo que la curva medida es suave por construcción y la dispersión de los valores reportados alrededor de ella muestra dónde discrepan ambos. Se muestra un solo gráfico para el RB de un qubit porque el mismo error medido por compuerta se asigna tanto a la compuerta x como a la sx. Los límites de los ejes se eligen a partir del grueso de los datos para que unos pocos valores atípicos extremos no compriman los gráficos; cualquier punto fuera del rango se cuenta en una anotación en el gráfico (o pasa ylim para anular los límites).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
Estos gráficos requieren una lectura cuidadosa, porque no toda brecha entre las dos curvas significa que el dispositivo haya derivado:
-
Errores de lectura y de un qubit: Los valores medidos siguen a los reportados para la mayoría de los qubits, mientras que el valor reportado de un puñado de qubits está muy alejado de la curva medida. Esas discrepancias localizadas son la deriva que este flujo de trabajo está diseñado para detectar.
-
: Los dos conjuntos de datos se dispersan uno alrededor del otro sin un desplazamiento sistemático, lo cual es consistente con que fluctúa naturalmente con el tiempo.
-
Errores de dos qubits: Los valores medidos se sitúan sistemáticamente por encima de los reportados. Esto es esperado porque los valores reportados se miden en compuertas aisladas, mientras que el experimento de fidelidad de capa ejecuta muchas compuertas simultáneamente y por lo tanto incluye crosstalk. Los números en capas son más relevantes para circuitos profundos, pero no son directamente comparables con los datos de calibración reportados.
-
: Los valores medidos se sitúan considerablemente por debajo de los reportados para la mayoría de los qubits. Nuevamente, la metodología juega un papel importante, como se examina en la siguiente sección.
Inspeccionar los resultados de experimentos individuales
También puedes inspeccionar los resultados en bruto de los experimentos de caracterización individuales a través de la propiedad experiment_data, que devuelve los objetos ExperimentData subyacentes de Qiskit Experiments. Por ejemplo, lo siguiente muestra la curva de decaimiento de medida de un solo qubit, lo cual es útil para verificar la calidad de un ajuste antes de confiar en el número que produjo.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Medir T2 con un tren de desacoplamiento dinámico
Por defecto el experimento de aplica un solo eco de Hahn y mide todos los qubits en paralelo, lo que, como mostró el gráfico de comparación anterior, puede producir valores de notablemente más bajos de lo que reporta el backend. Una hipótesis es el número de ecos: los valores reportados pueden estar calibrados con desacoplamiento dinámico, que suprime el ruido de baja frecuencia. Para probar esto, ejecuta una caracterización de solo con t2_num_echoes establecido en un valor mayor, lo cual aplica un tren de pulsos de eco estilo CPMG. Los retrasos representan el tiempo total de evolución libre en ambos casos, por lo que los valores de ajustados son directamente comparables con los resultados de eco único.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
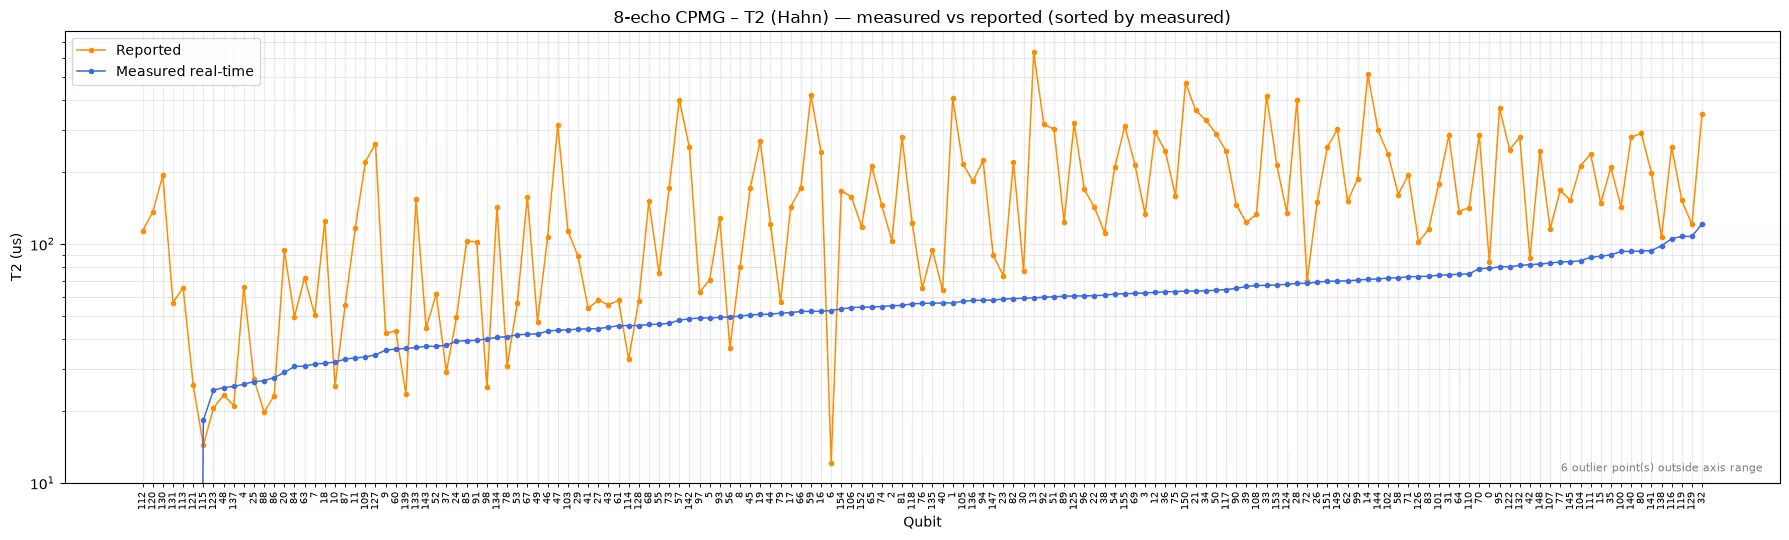
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
En esta ejecución los ecos adicionales apenas cambiaron el resultado: la mediana con 8 ecos (56 µs) está cerca de la de eco único (53 µs), y ambas permanecen muy por debajo de la mediana reportada (142 µs). El número de ecos por sí solo no explica esta brecha; hay otras diferencias metodológicas involucradas, como detalles del procedimiento de calibración, medir todos los qubits en paralelo en lugar de aislados, y demás.
La lección práctica es tratar las comparaciones de (y el error de dos qubits en capas) entre metodologías con cuidado. Los valores actualizados son una instantánea autoconsistente tomada bajo condiciones cercanas a una carga de trabajo real, lo que los hace adecuados para comparar qubits entre sí o rastrear un dispositivo a lo largo del tiempo. Sin embargo, una brecha respecto a los datos de calibración reportados no es automáticamente evidencia de deriva.
Pasos 1-4 comprimidos en una sola llamada
Para el uso diario, rara vez necesitas los resultados intermedios. El método run_and_update encadena todo lo que hiciste anteriormente (construir, enviar, ajustar y actualizar) en una sola llamada que devuelve el backend actualizado. Acepta la misma lista experiments (y reenvía opciones como t2_num_echoes), y de igual manera se puede envolver en un contexto Batch o Session.
La siguiente celda no devuelve el control hasta que todos los trabajos y el posprocesamiento hayan terminado.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
El objeto backend_updated actualizado ya está listo para usarse en cualquier lugar donde las propiedades del backend alimenten tu flujo de trabajo. Prueba este proceso junto con el tutorial Real-time benchmarking for qubit selection para elegir los qubits con mejor rendimiento al transpilar un circuito. Debido a que el dispositivo sigue derivando, actualiza las propiedades cerca del momento en que realmente ejecutas tu carga de trabajo.
Próximos pasos
Si este trabajo te pareció interesante, podrían interesarte los siguientes materiales:
- Usa las propiedades actualizadas para elegir mejores qubits en el tutorial Real-time benchmarking for qubit selection
- Aprende cómo se exponen los datos de calibración reportados en la guía QPU information
- Explora los experimentos de caracterización individuales en la documentación de Qiskit Experiments
- Explora más benchmarks a nivel de dispositivo en el repositorio de Qiskit Device Benchmarking