Mejora los valores esperados con la absorción de ruido propagado (PNA)
Estimación de uso: 10 minutos en un procesador Heron (NOTA: Esto es solo una estimación. Tu tiempo de ejecución puede variar.)
Resultados de aprendizaje
-
Qué es la absorción de ruido propagado (PNA), y cómo mitiga el ruido de puertas de dos qubits absorbiendo canales de ruido inverso aprendidos en el observable medido
-
Cómo usar
samplomaticpara encajar y anotar capas de circuito para twirling, cambios de base e inyección de ruido -
Cómo aprender el ruido de capa con
[NoiseLearnerV3](/guides/directed-execution-model#noiselearnerv3) y propagarlo a un observable que mitiga el ruido conqiskit-addon-pna -
Cómo muestrear circuitos aleatorizados con las clases
QuantumProgramyExecutorenqiskit-ibm-runtime, y combinar PNA con TREX y postselección
Requisitos previos
-
El flujo de trabajo de patrones de Qiskit
-
El uso de la primitiva Estimator para calcular valores esperados de un observable
-
Técnicas de mitigación de errores como el Pauli twirling y TREX, cubiertas en Combinar opciones de mitigación de errores con la primitiva Estimator
Contexto
En este tutorial, demostramos cómo aprovechar herramientas avanzadas de mitigación de errores en Qiskit para mejorar la estimación de valores esperados en experimentos cuánticos ruidosos.
¿Qué es la absorción de ruido propagado (PNA)?
La absorción de ruido propagado es una técnica para mitigar errores de puertas propagando el observable a través del canal de ruido inverso que afecta a las puertas de dos qubits, dando como resultado un observable que mitiga el ruido.
Podemos usar la mitigación de errores cuánticos para extraer valores esperados útiles de hardware cuántico ruidoso sin requerir tolerancia a fallos completa. PNA se enfoca específicamente en absorber los efectos del ruido en el propio observable en lugar de modificar las operaciones del circuito.
Cada puerta ruidosa en un circuito cuántico se puede modelar como una puerta ideal seguida de un canal de ruido. PNA aprende o caracteriza estos canales de ruido y define sus inversos. En lugar de insertar las operaciones inversas en la ejecución del hardware (lo cual normalmente es inviable), PNA propaga los canales de ruido inverso hacia adelante a través del circuito y los aplica al observable. Este proceso transforma el observable en un nuevo operador , de tal manera que medir en el circuito ruidoso produce el mismo valor esperado que medir en un circuito ideal sin ruido.
Esto se puede resumir así:
- Modela cada puerta ruidosa como una operación ideal seguida de un canal de ruido .
- Aprende o estima cada usando herramientas de caracterización de ruido.
- Define y propaga los mapas de ruido inverso hacia adelante a través del circuito usando técnicas de transferencia de Pauli.
- Absorbe estos inversos en el observable, dando como resultado un operador mitigado de ruido .
Cuando el ruido se describe como un canal de Pauli (o, más generalmente, como un canal de Pauli-Lindblad disperso), esta propagación se puede realizar de manera eficiente utilizando propagación de Pauli. La propagación de Pauli proporciona un marco para aproximar cómo se transforman los canales de ruido inverso a medida que pasan a través de capas de operaciones de Clifford y no Clifford, controlando al mismo tiempo la complejidad computacional.
Al trasladar la mitigación al observable, PNA evita la gran sobrecarga de muestreo que de otro modo provendría de insertar operaciones de corrección físicas en el circuito. En cambio, se ejecuta el circuito ruidoso original, mientras que el observable se transforma en un nuevo operador cuyo valor esperado cancela los efectos del ruido.
El flujo de trabajo de PNA
El proceso se puede entender a través de las siguientes etapas conceptuales. El primer esquema ilustra un experimento ruidoso estándar.

Si aprendemos el modelo de ruido, podemos aplicar su inverso y cancelar el ruido.

En lugar de implementar el canal de ruido inverso muestreándolo en el QPU como en la cancelación probabilística de errores (PEC), lo aplicamos de forma clásica al observable medido usando propagación de Pauli. El observable resultante mitiga eficazmente el ruido de puertas aprendido cuando se mide.
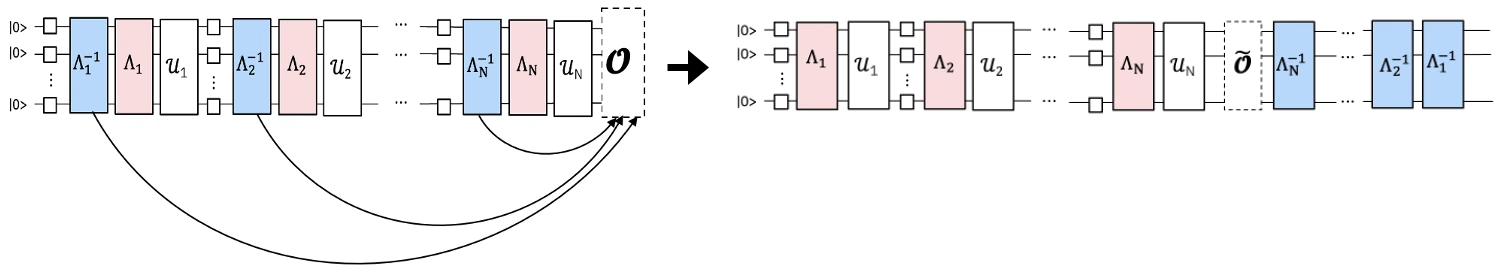
Mitigación modular de errores con Samplomatic y Executor
El enfoque PNA se basa en una arquitectura modular de mitigación de errores en Qiskit. Esta arquitectura usa la librería samplomatic junto con las clases QuantumProgram y Executor (añadidas a Qiskit Runtime en qiskit-ibm-runtime v0.47.0) para hacer que técnicas como la absorción de ruido propagado y el Pauli twirling sean componibles y reutilizables en diferentes experimentos.
En lugar de incrustar la lógica de mitigación dentro de la propia definición del circuito, la mitigación se expresa de forma declarativa mediante anotaciones de samplomatic y se gestiona de forma programática a través de Executor, que controla cómo se generan, ejecutan y post-procesan los circuitos aleatorizados.
En este tutorial implementamos un patrón de Qiskit para demostrar cómo PNA puede propagar canales de ruido de Pauli inversos y modificar el observable en consecuencia, para mejorar la estimación de valores esperados en QPUs ruidosos.
Descripción general del flujo de trabajo
-
Paso 1: Mapear al problema cuántico
- Construir un modelo de Ising pateado (kicked-Ising) trotterizado en espejo y un observable objetivo.
-
Paso 2: Caracterizar y propagar el ruido
-
Usar
samplomaticpara identificar y anotar capas de dos qubits únicas y mediciones en el circuito. -
Aprender el ruido que afecta a cada capa única usando
NoiseLearnerV3. -
Mapear cada anotación
InjectNoisea su modelo de ruido aprendido correspondiente. -
Usar
qiskit-addon-pnapara propagar los canales de ruido inverso hacia adelante a través del circuito y absorberlos en el observable objetivo.
-
-
Paso 3: Ejecutar experimentos cuánticos
- Definir un
QuantumProgrampara especificar el muestreo aleatorizado mediantesamplexy ejecutar los experimentos en el backend usando elExecutor.
- Definir un
-
Paso 4: Reconstruir y analizar resultados
- Comparar estrategias de mitigación (PNA, PNA+TREX, PNA+PS, PNA+PS+TREX) y visualizar la mejora respecto a los resultados sin mitigar.
Requisitos
Antes de comenzar este tutorial, asegúrate de tener instalado lo siguiente:
-
Qiskit SDK v2.2 o posterior, con soporte de visualización
-
Qiskit Runtime v0.47 o posterior (
pip install qiskit-ibm-runtime) -
Samplomatic v0.13 o posterior (
pip install samplomatic) -
Addon PNA de Qiskit (
pip install qiskit-addon-pna) -
Utilidades de addon de Qiskit (
pip install qiskit-addon-utils)
Configuración
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_pna": "qiskit-addon-pna", "qiskit_addon_utils": "qiskit-addon-utils", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager, PassManager
from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    QuantumProgram,
    Executor,
    NoiseLearnerV3,
)
from qiskit_addon_utils.exp_vals.measurement_bases import (
    get_measurement_bases,
)
from qiskit_addon_utils.exp_vals.expectation_values import (
    executor_expectation_values,
)
from qiskit_addon_utils.noise_management import trex_factors
from qiskit_addon_utils.noise_management.post_selection import PostSelector
from qiskit_addon_utils.noise_management.post_selection.transpiler.passes import (
    AddPostSelectionMeasures,
    AddSpectatorMeasures,
)
from qiskit_addon_pna import generate_noise_mitigating_observable
import samplomatic
from samplomatic.transpiler import generate_boxing_pass_manager
from samplomatic.annotations import InjectNoise
from samplomatic.utils import get_annotation, find_unique_box_instructions
import numpy as np
import matplotlib.pyplot as plt

# Selects a connected chain of low-error qubits on the target backend.
# The mirrored kicked-Ising circuit is a 1D chain, so we only need a line
# of connected physical qubits; the helper walks the backend's coupling map
# and grows a chain along the lowest-error two-qubit edges, so it works for
# any backend rather than relying on a hardcoded layout.
def find_qubit_chain(backend, length):
    """Find a connected chain of ``length`` physical qubits on ``backend``.

    The chain is grown greedily along the lowest-error two-qubit edges, so it
    favors better-performing qubits. Because the mirrored kicked-Ising circuit
    is a 1D chain, a connected line is all we need.
    """
    target = backend.target

    # Identify the native two-qubit gate and build a per-edge error lookup.
    two_qubit_gate = next(
        name
        for name in target.operation_names
        if target[name]
        and all(q is not None and len(q) == 2 for q in target[name])
    )
    edge_error = {
        frozenset(qargs): (
            1.0 if props is None or props.error is None else props.error
        )
        for qargs, props in target[two_qubit_gate].items()
    }

    graph = backend.coupling_map.graph.to_undirected(multigraph=False)
    neighbors = {n: list(graph.neighbors(n)) for n in graph.node_indices()}

    def first_chain_from(start):
        path, visited = [start], {start}

        def grow():
            if len(path) == length:
                return True
            node = path[-1]
            order = sorted(
                neighbors[node],
                key=lambda m: edge_error.get(frozenset((node, m)), 1.0),
            )
            for nxt in order:
                if nxt not in visited:
                    visited.add(nxt)
                    path.append(nxt)
                    if grow():
                        return True
                    path.pop()
                    visited.remove(nxt)
            return False

        return path if grow() else None

    def chain_cost(path):
        return sum(
            edge_error.get(frozenset((path[i], path[i + 1])), 1.0)
            for i in range(len(path) - 1)
        )

    # Try low-degree qubits first (the natural ends of long chains) and keep
    # the lowest-error chain found.
    best_path, best_cost = None, float("inf")
    for start in sorted(neighbors, key=lambda n: len(neighbors[n])):
        chain = first_chain_from(start)
        if chain is not None and (cost := chain_cost(chain)) < best_cost:
            best_path, best_cost = chain, cost

    if best_path is None:
        raise ValueError(
            f"Could not find a connected chain of {length} qubits "
            f"on '{backend.name}'."
        )
    return best_path
Ejemplo de simulador a pequeña escala
PNA mitiga el ruido físico de las puertas de dos qubits de un procesador cuántico específico. El flujo de trabajo depende de dos servicios de hardware que no tienen un equivalente significativo en un simulador ideal:
-
NoiseLearnerV3caracteriza experimentalmente el canal de ruido de Pauli-Lindblad disperso asociado a cada capa única de dos qubits del circuito transpilado. En un simulador sin ruido no hay ruido que aprender, y el canal inverso propagado sería la identidad. -
La primitiva
Executormuestrea los circuitos aleatorizados y con twirling generados porsamplomaticen un backend.
En principio, podrías sustituir un modelo de ruido sintético. Por ejemplo, podrías adjuntar instrucciones PauliLindbladError con Qiskit Aer y pasar el circuito ruidoso resultante directamente a generate_noise_mitigating_observable. Sin embargo, esto solo valida la contabilidad clásica frente al ruido que tú mismo has inyectado, y oculta el propósito de la técnica. Por esa razón, omitimos el ejemplo del simulador y demostramos el flujo de trabajo completo de PNA directamente en hardware, con cada paso del patrón de Qiskit desglosado a continuación.
Ejemplo de hardware a gran escala
Ahora ejecutamos el flujo de trabajo completo de PNA en un modelo de Ising pateado de 30 sitios ejecutado en hardware de IBM Quantum®, siguiendo los cuatro pasos de un patrón de Qiskit.
Paso 1: Mapear a un problema cuántico
Generar el circuito de Trotter en espejo y el observable
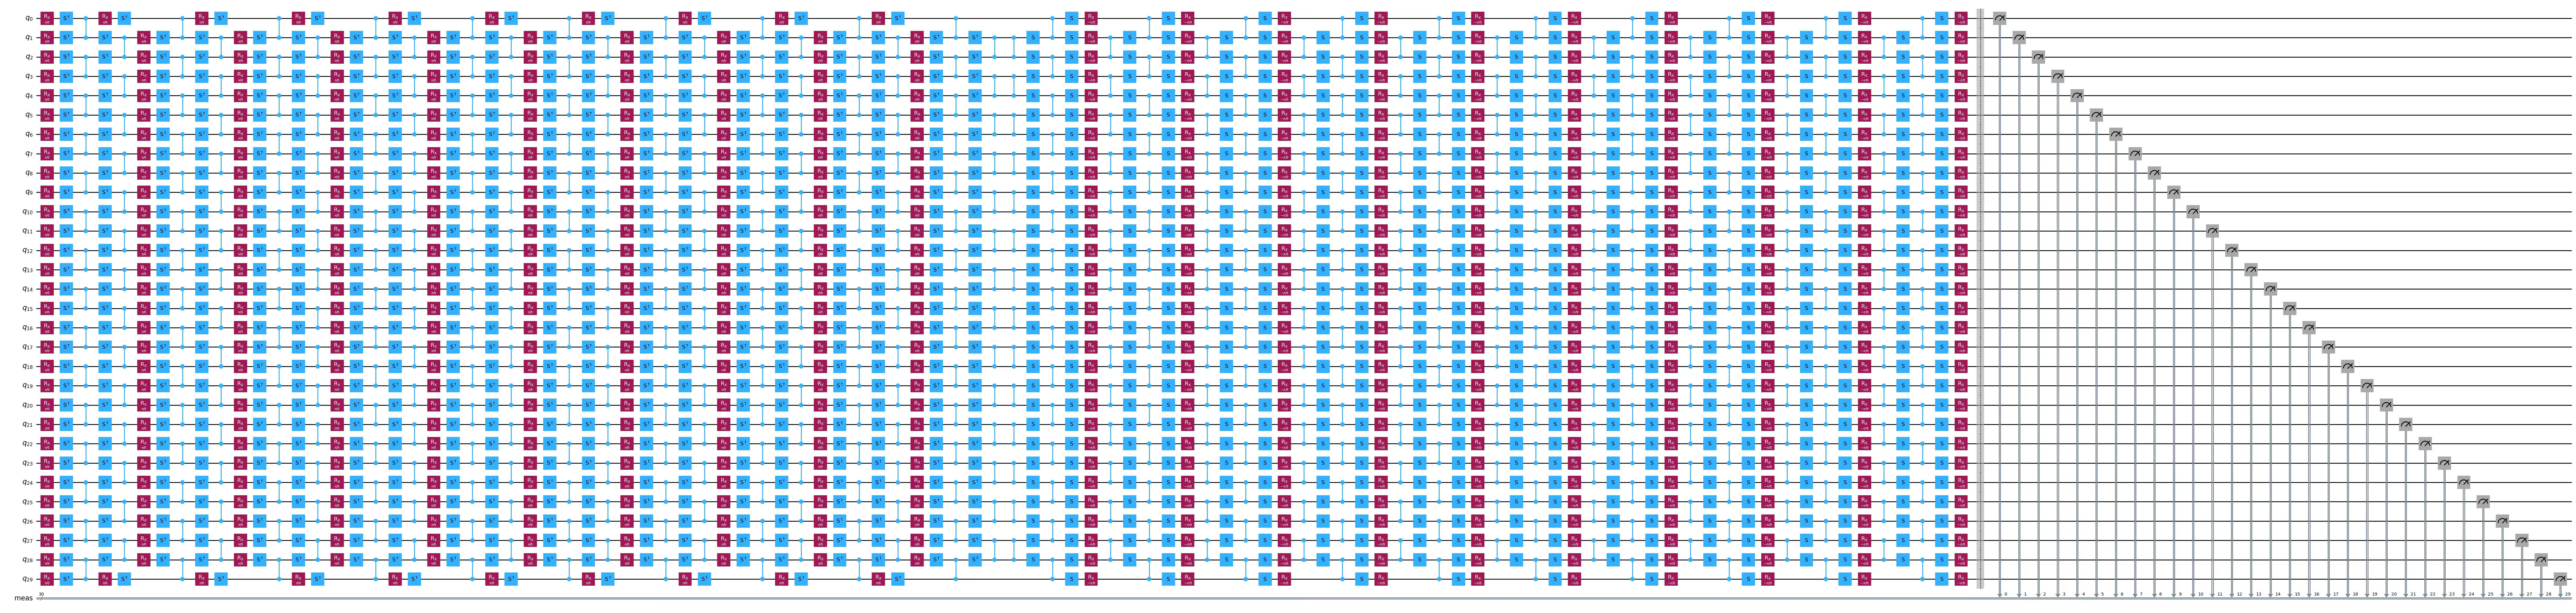
Para este experimento, estudiaremos la dinámica temporal de un modelo de Ising pateado de 30 sitios en una cadena de espines 1D. El Hamiltoniano considerado es:
,
donde describe el acoplamiento de espines vecinos más cercanos, , y el campo transversal global, , se establece en . Cuanto más se aleja de un ángulo de Clifford (es decir, ), más difícil resulta propagar los generadores de anti-ruido a través del circuito.
Para la elección del observable, consideraremos la magnetización promedio de un solo sitio, , donde es el número de sitios.
num_qubits = 30
num_trotter_steps = 10
rx_angle = np.pi / 8

# Avg single-site magnetization
id_pauli = Pauli("I" * num_qubits)
observable = (
    SparsePauliOp([id_pauli.dot(Pauli("Z"), [i]) for i in range(num_qubits)])
    / num_qubits
)

# Implement Trotterized kicked-Ising model
circuit = QuantumCircuit(num_qubits)
for _step in range(num_trotter_steps):
    circuit.rx(rx_angle, range(num_qubits))
    for first_qubit in (1, 2):
        for idx in range(first_qubit, num_qubits, 2):
            # equivalent to Rzz(-pi/2):
            circuit.sdg([idx - 1, idx])
            circuit.cz(idx - 1, idx)
# Append the inverse circuit to complete the mirroring
circuit.compose(circuit.inverse(), inplace=True)
circuit.measure_active()
circuit.draw("mpl", fold=-1)
Paso 2: Optimizar el problema para la ejecución en hardware
El siguiente paso es preparar nuestro circuito de Trotter en espejo para su ejecución en hardware real de IBM Quantum. Ejecutar en un QPU requiere más que simplemente construir el circuito abstracto, ya que necesitamos optimizarlo para que:
-
Respete el conjunto de puertas nativo y la conectividad del backend. La transpilación mapea el circuito lógico a un circuito ISA compatible con el backend objetivo. Esto asegura que cada puerta e interacción de qubits sea físicamente realizable.
-
Podamos caracterizar el ruido a nivel de las capas del circuito. PNA depende de aprender y propagar canales de ruido inverso. Para hacerlo de manera eficiente, dividimos el circuito transpilado en capas únicas de dos qubits "encajonadas" (boxed). Estas cajas nos permiten asociar cada capa del circuito con su propio modelo de ruido aprendido.
-
Podamos alimentar a PNA con modelos de ruido realistas. Una vez que el circuito ha sido encajonado, usamos el servicio
NoiseLearnerV3para aprender experimentalmente los canales de ruido de Pauli que afectan a cada capa única de dos qubits. Estos modelos aprendidos luego se vinculan de nuevo al circuito a través de las anotaciones de Samplomatic.
En conjunto, este paso cierra la brecha entre un circuito en espejo idealizado y un circuito listo para hardware con modelos de ruido aprendidos. Con esta configuración, PNA puede propagar canales de ruido inverso a través del circuito y ajustar el observable en consecuencia.
Conectar al backend y transpilar a un circuito ISA
Primero inicializamos el IBM Quantum Compute Service y seleccionamos un backend. Autentícate con tu propia cuenta siguiendo las instrucciones para guardar tus credenciales, después de lo cual QiskitRuntimeService() las recogerá automáticamente.
# Initialize IBM Quantum Compute Service using your saved credentials
service = QiskitRuntimeService()

backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=num_qubits
)
# Re-fetch with fractional gates enabled (least_busy does not forward this)
# Fractional gates are enabled so the non-Clifford Rx rotations are supported natively.
backend = service.backend(backend.name, use_fractional_gates=True)
print(f"Selected backend: {backend.name}")
Selected backend: ibm_fez
A continuación, elegimos una cadena conectada de qubits en el backend y transpilamos el circuito en ella.
Usando el ayudante find_qubit_chain definido en la sección de Configuración, seleccionamos una línea de num_qubits qubits físicos conectados. Luego transpilamos con optimization_level=0 y fijamos esta cadena como el initial_layout, lo que preserva exactamente la estructura de capas de puertas de dos qubits del circuito en espejo. Esa estructura es en la que se basan los pasos de encajonado y aprendizaje de ruido, por lo que se debe evitar aquí un nivel de optimización más alto (que cancelaría las puertas en espejo).
# Find a connected, low-error chain of qubits on the chosen backend
layout = find_qubit_chain(backend, num_qubits)

# Transpile the circuit for the target backend, pinning the chain as the layout.
# optimization_level=0 preserves the mirrored two-qubit-gate layers that the
# boxing and noise-learning steps rely on.
pm = generate_preset_pass_manager(
    backend=backend, optimization_level=0, initial_layout=layout
)
isa_circuit = pm.run(circuit)
isa_observable = observable.apply_layout(isa_circuit.layout)
isa_circuit.draw("mpl", fold=-1)
Aplicar twirling a las capas de puertas de dos qubits y a las mediciones, y encontrar capas únicas
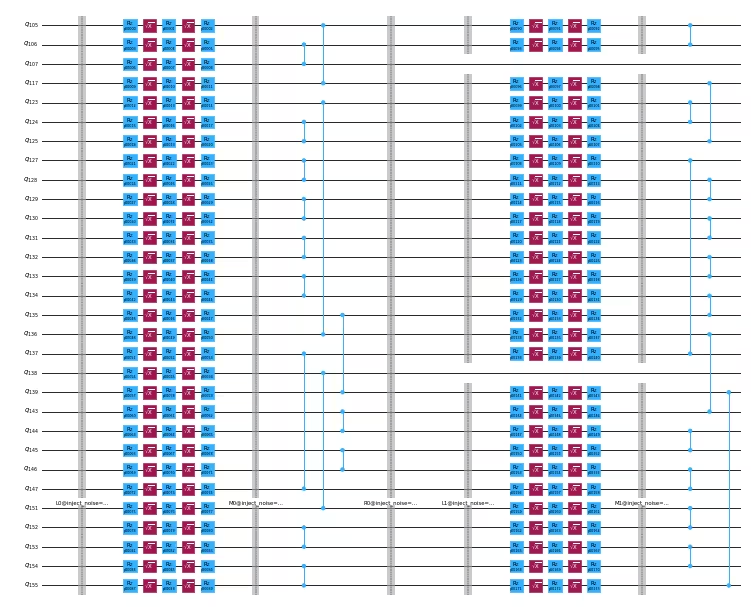
Usamos samplomatic para encajonar el circuito e identificar capas únicas de dos qubits. Una caja es una construcción que agrupa instrucciones para que intenciones o anotaciones específicas puedan aplicarse posteriormente de manera uniforme a todas las puertas dentro de la misma caja.
Aquí, llamamos al método generate_boxing_pass_manager, que va más allá de simplemente identificar capas de dos qubits. Realiza varias tareas clave:
-
Agrupa todas las capas de dos qubits en el circuito,
-
Aplica las anotaciones
TwirlyChangeBasisa esas capas, -
Agrupa las operaciones de medición en sus propias secciones encajonadas, y
-
Aplica la anotación
InjectNoisea cada capa de dos qubits.
Estas anotaciones definen cómo se manejan el ruido, los cambios de base y el twirling a lo largo del circuito. También establecen la estructura utilizada más adelante para aprender y mitigar el ruido.
Las opciones de configuración clave son:
-
enable_gates/enable_measures: True: Encajona todas las capas de puertas de dos qubits y las mediciones terminales. Las puertas de un solo qubit se incorporan como "dressing" por la izquierda (left-dressed) dentro de las cajas. -
measure_annotations: all: Incluye las anotacionesTwirlyChangeBasisen la caja de medición. -
twirling_strategy: active: Aplica twirling a todos los qubits activos en cada caja que contiene puertas de entrelazamiento. -
inject_noise_targets: gates: Añade anotacionesInjectNoisea todas las cajas anotadas conTwirlque contienen puertas de entrelazamiento. -
inject_noise_strategy: uniform_modification: Escala todas las capas de ruido de manera equivalente en todo el circuito.
# Box up circuit with Twirl and InjectNoise annotations
pm = generate_boxing_pass_manager(
    enable_gates=True,
    enable_measures=True,
    measure_annotations="all",
    twirling_strategy="active",
    inject_noise_targets="gates",
    inject_noise_strategy="uniform_modification",
)
boxed_circuit = pm.run(isa_circuit)
draw_circ = QuantumCircuit(boxed_circuit.num_qubits)
draw_circ.append(boxed_circuit.data[0], qargs=boxed_circuit.data[0].qubits)
draw_circ.append(boxed_circuit.data[1], qargs=boxed_circuit.data[1].qubits)
draw_circ.draw("mpl", fold=-1, scale=0.3, idle_wires=False)

Genera el circuito plantilla y el samplex, que definen cómo se muestreará el circuito.
Aquí también añadimos mediciones espectadoras y de postselección, que son necesarias para realizar la postselección en las muestras obtenidas del Executor.
# Build template circuit and samplex for later use with the "Executor"
template_circuit, samplex = samplomatic.build(boxed_circuit)

# Add post-selection instructions to the template circuit
post_selection_pm = PassManager(
    [
        AddSpectatorMeasures(backend.coupling_map),
        AddPostSelectionMeasures(x_pulse_type="rx"),
    ]
)
template_circuit = post_selection_pm.run(template_circuit)
draw_circ = template_circuit.copy_empty_like()
draw_circ.data = template_circuit.data[:324]
draw_circ.draw("mpl", fold=-1, scale=0.3, idle_wires=False)
Aprender el ruido usando NoiseLearnerV3
Antes de poder aplicar PNA para la mitigación de errores, primero necesitamos caracterizar el ruido que actúa en cada capa única de dos qubits y en la capa de medición de nuestro circuito. Para ello, usamos el programa NoiseLearnerV3 para aprender experimentalmente modelos de ruido para cada capa identificada anteriormente. El learner realiza experimentos de estilo benchmarking que estiman el canal de ruido que afecta a cada capa y devuelve un objeto de resultado que contiene el modelo aprendido.
Comenzamos identificando las capas únicas de nuestro circuito usando find_unique_box_instructions de samplomatic. Esto asegura que solo aprendamos el ruido una vez por cada tipo de capa distinto, minimizando el número de experimentos y el costo total de disparos (shots). La lista resultante de capas se pasa al learner de ruido.
Hay algunos parámetros clave que controlan cómo se aprende el ruido:
-
num_randomizations: Número de circuitos aleatorios usados por configuración de aprendizaje. -
shots_per_randomization: Número de disparos (shots) tomados por cada circuito de aprendizaje aleatorio. -
layer_pair_depths: Las profundidades del circuito (medidas en número de pares) que se usarán en los experimentos de aprendizaje. -
post_selection: Habilita la postselección basada en aristas usando puertasrxpara aplicar pulsos posteriores a la medición.
# Noise learning parameters
num_randomizations_nl = 64
shots_per_randomization_nl = 128

# Match the deepest noise-learning depth to the depth of the circuit being
# mitigated. ``layer_pair_depths`` are measured in layer pairs (a layer + its
# inverse), so the deepest value is half the circuits's two-qubit-layer depth.
# Learning to this depth improves the quality of the mitigation.

depth_2q = isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)
max_layer_pair_depth = depth_2q // 2

# Use a fixed schedule of learning depths, but drop any that exceed the circuit's
# depth and always cap the deepest value at ``max_layer_pair_depth`` so we never
# learn deeper than the circuit being mitigated
candidate_depths = [1, 2, 4, 8, 12, 16, 24, 32, 40, 48]
layer_pair_depths = sorted(
    {d for d in candidate_depths if d < max_layer_pair_depth}
    | {max_layer_pair_depth}
)

# Find the unique instructions (layers) from the boxed-up circuit
unique_2q_layers_and_meas = find_unique_box_instructions(
    boxed_circuit, normalize_annotations=None, undress_boxes=True
)

# Configure and run the noise learner on the unique layers.
# Options can be passed directly as a dictionary.
noise_learner_options = {
    "num_randomizations": num_randomizations_nl,
    "shots_per_randomization": shots_per_randomization_nl,
    "layer_pair_depths": layer_pair_depths,
    "post_selection": {
        "enable": True,
        "strategy": "edge",
        "x_pulse_type": "rx",
    },
    "environment": {"job_tags": ["TUT_PNA"]},
}

noise_learner = NoiseLearnerV3(backend, noise_learner_options)
noise_learner_job = noise_learner.run(unique_2q_layers_and_meas)
noise_learner_result = noise_learner_job.result()
Visualizar las tasas de ruido aprendidas
Después de aprender los modelos de ruido, podemos inspeccionar la distribución de las tasas de error inferidas tanto para operaciones de un qubit como de dos qubits. El código a continuación extrae las representaciones de Pauli-Lindblad de los resultados de ruido aprendidos y recopila las tasas de ruido correspondientes.
Para cada capa aprendida:
- Convertimos el modelo de ruido en una lista dispersa de tuplas
(pstr, qubits, rate), dondepstres la cadena de Pauli que actúa sobre los qubits dados yratees la tasa de error asociada. - Separamos las tasas en términos de un qubit (
len(pstr) == 1) y de dos qubits (len(pstr) == 2). - Las listas de tasas se ordenan y se calculan sus valores medianos.
Graficamos las distribuciones de tasas de ruido de un qubit (rojo) y de dos qubits (azul) en escala logarítmica, con sus valores medianos marcados con líneas verticales, para poder comparar las magnitudes relativas de los generadores de Pauli-Lindblad aprendidos. El orden de las tasas de uno y dos qubits depende del dispositivo y de las capas específicas que se estén caracterizando; en esta ejecución, los generadores de un solo qubit (peso 1) tienen la tasa mediana más alta.
hw_rates_1q = []
hw_rates_2q = []
for nlr in noise_learner_result[:2]:
    plm_list = nlr.to_pauli_lindblad_map().to_sparse_list()
    hw_rates_1q += [
        rate for (pstr, qubits, rate) in plm_list if len(pstr) == 1
    ]
    hw_rates_2q += [
        rate for (pstr, qubits, rate) in plm_list if len(pstr) == 2
    ]
hw_rates_1q = sorted(hw_rates_1q)
hw_rates_2q = sorted(hw_rates_2q)
median_1q = hw_rates_1q[len(hw_rates_1q) // 2]
median_2q = hw_rates_2q[len(hw_rates_2q) // 2]
fig, ax = plt.subplots(1, 1, figsize=(14, 5))
ax.scatter(
    (hw_rates_1q),
    [(i) / (len(hw_rates_1q) - 1) for i in range(len(hw_rates_1q))],
    color="red",
    label="1q rates",
)
ax.set_xscale("log")
ax.set_ylim(0, 1.1)
ax.vlines(median_1q, 0, 1, color="red")
ax.text(median_1q * 1.1, 0.1, f"{median_1q:.2e}")
ax.scatter(
    (hw_rates_2q),
    [(i) / (len(hw_rates_2q) - 1) for i in range(len(hw_rates_2q))],
    color="blue",
    label="2q rates",
)
ax.set_xscale("log")
ax.set_ylim(0, 1.1)
ax.vlines(median_2q, 0, 1, color="blue")
ax.text(median_2q * 1.1, 0.2, f"{median_2q:.2e}")
ax.set_title("Learned noise rates")
ax.set_xlabel("Noise rate")
ax.set_yticks([])
plt.legend()
<matplotlib.legend.Legend at 0x125336120>

Asociar las cajas del circuito con el ruido aprendido
Una vez que hemos obtenido modelos de ruido para cada capa única de dos qubits, necesitamos vincularlos a las anotaciones InjectNoise correspondientes dentro del circuito encajonado.
La directiva InjectNoise es una anotación de samplomatic que usa los dressers de un solo qubit para inyectar ruido en el circuito de manera controlada y configurable. Permite el modelado de ruido modular en diferentes capas.
Cada anotación InjectNoise incluye:
InjectNoise.ref- un identificador único para la anotación. El objetosamplexlo usa para asignar correctamente el modelo de ruido correspondiente.InjectNoise.modifier_ref(opcional) - una referencia secundaria que permite escalar el modelo de ruido asignado mediante un factor multiplicativo.
En este paso, construimos un mapeo de cada InjectNoise.ref a su modelo de ruido aprendido correspondiente (PauliLindbladMap). Este mapeo asegura que cada capa de puertas de entrelazamiento en el circuito se empareje con el modelo de ruido apropiado, de modo que los efectos del ruido se apliquen con precisión durante el muestreo y los pasos posteriores de mitigación de ruido.
# map inject noise refs to pauli lindblad maps
refs_to_noise_models = {}
for instruction, result in zip(
    unique_2q_layers_and_meas, noise_learner_result, strict=False
):
    if inject_noise_annot := get_annotation(
        instruction.operation, InjectNoise
    ):
        refs_to_noise_models[inject_noise_annot.ref] = (
            result.to_pauli_lindblad_map()
        )
Propagar el observable a través del anti-ruido aprendido
Como se discutió anteriormente, esto se realiza en dos pasos. Primero, propagamos un generador de anti-ruido hasta el final del circuito. Después de eso, propagamos el observable a través de ese generador evolucionado. Este proceso se repite para cada generador de anti-ruido en el circuito. En esta implementación, cada generador en una capa dada se propaga hasta el final del circuito en paralelo. Además, se usa multiprocesamiento de Python para realizar tanto la propagación hacia adelante del anti-ruido como la retropropagación del observable en paralelo. Esto evita una acumulación de generadores evolucionados en la memoria y también maximiza los recursos de cómputo.
Al ejecutar PNA, siempre necesitas proporcionar un circuito ruidoso y un observable. Si tu circuito ruidoso es un circuito encajonado con anotaciones InjectNoise, necesitas proporcionar el mapeo que creamos en el paso anterior. También se puede pasar un circuito no encajonado que contenga instrucciones PauliLindbladError de qiskit-aer. En ese caso, no es necesario proporcionar refs_to_noise_models. Además de las entradas principales, también considera lo siguiente:
-
max_err_terms: El número de términos que se mantienen en cada generador de anti-ruido a medida que se propaga hacia adelante. Permitir que este valor sea mayor generalmente aumenta la precisión, pero no se garantiza que este comportamiento sea monótono. -
max_obs_terms: El número de términos que se mantienen en el observable que mitiga el ruido, , a medida que se retropropaga a través del anti-ruido evolucionado. Valores más grandes generalmente aumentan la precisión, pero no se garantiza que lo hagan de manera monótona. -
num_processes: El número de núcleos que se dedican al proceso. Recuerda, los generadores se propagan hacia adelante y se aplican al observable en paralelo. -
search_step: El paso de retropropagación usa un método voraz (greedy) para conjugar aproximadamente dos operadores en la base de Pauli. Este método se puede acelerar aumentandosearch_step. Consulta la documentación depauli-proppara más información. -
num_to_measure: Aunque esta variable no es una entrada degenerate_noise_mitigating_observable, la usamos para controlar cuántos términos de queremos medir realmente. Aquí solo medimos los 30 términos principales, que son los términos originales de nuestro observable. Los términos ahora se han reescalado de tal manera que medirlos tiene el efecto de mitigar el ruido de puertas aprendido. Aunque solo medimos 30 términos de , a menudo sigue siendo útil permitir que crezca mucho, ya que eso aumenta la precisión de los factores de escala de los términos principales.
# PNA parameters
num_processes = 8
max_err_terms = 10_000
max_obs_terms = 10_000
num_to_measure = num_qubits

obs_tilde_isa = generate_noise_mitigating_observable(
    boxed_circuit,
    isa_observable,
    refs_to_noise_models,
    max_err_terms=max_err_terms,
    max_obs_terms=max_obs_terms,
    num_processes=num_processes,
    print_progress=True,
    search_step=8,
)
p_2_v = {p: v for v, p in enumerate(layout)}
obs_tilde_virtual = SparsePauliOp.from_sparse_list(
    [
        (pstr, [p_2_v[p] for p in p_qubits], coeff)
        for (pstr, p_qubits, coeff) in obs_tilde_isa.to_sparse_list()
    ],
    num_qubits=num_qubits,
)
obs_tilde_virtual = obs_tilde_virtual[
    np.argsort(np.abs(obs_tilde_virtual.coeffs))[::-1]
][:num_to_measure]
Finished! 13740 / 13740 generators propagated.
obs_tilde_isa = obs_tilde_isa[np.argsort(np.abs(obs_tilde_isa.coeffs))][::-1]
plt.xscale("log")
plt.yscale("log")
plt.title(r"$\tilde{O}$ coeff magnitudes")
plt.ylabel("Magnitude")
plt.xlabel("Pauli term index")
plt.plot(np.abs(obs_tilde_isa.coeffs), ".")
[<matplotlib.lines.Line2D at 0x124b0a120>]

Transformar las bases de medición a forma canónica
A continuación, encontramos un conjunto mínimo de bases a medir de manera que podamos cubrir completamente cada término de Pauli en el observable medido (se pueden medir muchos observables simultáneamente si conmutan qubit a qubit). Dado que solo estamos midiendo los términos de nuestro observable original, que es la suma de todos los Paulis Z individuales, se necesita una sola base: la base todo-Z.
Además de encontrar un conjunto de bases de medición de Pauli, necesitamos mapear estos términos de Pauli a la forma canónica esperada por el Executor. Para más información sobre el ordenamiento canónico de qubits, visita la documentación de Samplomatic.
meas_box = boxed_circuit.data[-1]
canonical_qubits = [
    idx
    for idx, qubit in enumerate(boxed_circuit.qubits)
    if qubit in meas_box.qubits
]
c_2_p = {
    c: p for c, p in enumerate(canonical_qubits)
}  # canonical -> physical
p_2_v = {p: v for v, p in enumerate(layout)}  # physical -> virtual
c_2_v = {c: p_2_v[p] for c, p in c_2_p.items()}  # canonical -> virtual
meas_bases, bases_reverser = get_measurement_bases(obs_tilde_virtual)
meas_bases_canonical = [
    np.array([base[c_2_v[c]] for c in range(num_qubits)], dtype=np.uint8)
    for base in meas_bases
]
Paso 3: Ejecutar experimentos cuánticos
Especifica cómo muestrear en el QuantumProgram
Ahora configuramos el QuantumProgram, que sirve como el contenedor central para todos los circuitos y configuraciones de muestreo que serán ejecutados por el Executor. Este objeto define cómo se generan, agrupan y ejecutan las instancias de circuitos aleatorizados para producir los resultados de medición utilizados en PNA.
Un QuantumProgram puede contener múltiples elementos, cada uno consistiendo en un circuito plantilla y un objeto samplex correspondiente que define cómo se aplican las aleatorizaciones. Esta abstracción permite que el Executor maneje todo el flujo de trabajo como un único programa modular — desde la generación de circuitos aleatorizados hasta la recolección y agregación de shots.
En este paso, creamos un QuantumProgram que ejecuta nuestro experimento PNA usando el circuito plantilla y el samplex que construimos anteriormente. La configuración incluye los siguientes elementos:
-
template_circuit: El circuito que contiene todas las puertas necesarias para implementar todas las aleatorizaciones deseadas (a partir de aleatorizaciones de twirling, parámetros, etc.). -
samplex: Un objeto que define una distribución de probabilidad sobre todas las posibles aleatorizaciones de circuitos de las cuales muestrear. -
samplex_arguments: Vinculaciones necesarias para definir completamente elsamplex-
basis_changes: Aquí es donde especificamos un conjunto de bases a medir que cubrirá todos los términos de Pauli en el observable medido. -
noise_scales.ref: Establecemos la escala de cada capa de ruido en0.0para evitar que se inyecte ruido adicional en nuestras muestras. -
pauli_lindblad_maps: Requerido si se pasannoise_scales. Esto simplemente mapea las capas de ruido al modelo de ruido asociado.
-
-
shape: Una tupla de forma para extender la forma implícita definida porsamplex_arguments. Los ejes no triviales introducidos por esta extensión enumeran las aleatorizaciones.
# Control the # of shots during execution
shots_per_randomization_exec = 64
num_randomizations_exec = 6144

# Zero out the noise to prevent noise from being injected during execution.
# We only added InjectNoise annotations so PNA could associate the noise
# to layers in the circuit
samplex_inputs = {f"noise_scales.{ref}": 0.0 for ref in refs_to_noise_models}
samplex_inputs |= {"pauli_lindblad_maps": refs_to_noise_models}

# Specify the bases to measure. The samplex exposes one basis-change input per
# ChangeBasis-annotated box; here a single all-Z basis covers every term. We
# look up the basis-change interface name rather than hardcoding an index, since
# the name depends on the circuit's box structure.
bases_broadcastable = np.expand_dims(np.array(meas_bases_canonical), axis=1)
samplex_inputs |= {
    spec.name: bases_broadcastable
    for spec in samplex.inputs().get_specs(r"^basis_changes\.")
}

# Convert samplex_inputs into a dict to pass to QuantumProgram
samplex_arguments = (
    samplex.inputs().make_broadcastable().bind(**samplex_inputs)
)

# Instantiate the QuantumProgram with the specified parameters
program = QuantumProgram(shots=shots_per_randomization_exec)
program.append_samplex_item(
    circuit=template_circuit,
    samplex=samplex,
    samplex_arguments=samplex_arguments,
    shape=(num_randomizations_exec,),
)
Muestrea el circuito usando el Executor
Ahora que hemos definido nuestro QuantumProgram, ejecutar el experimento es sencillo. Simplemente instanciamos el objeto Executor, le proporcionamos el backend y ejecutamos el programa.
# Execute (sample) the circuit
executor = Executor(backend)
job_exec = executor.run(program)
exec_results = job_exec.result()
Paso 4: Reconstruir y analizar resultados
Para calcular un valor esperado con mitigación de errores, hacemos lo siguiente:
-
Calcular los factores de escala TREX basados en el ruido aprendido que afecta a las mediciones,
-
Generar una máscara para conservar solo las muestras postseleccionadas, y
-
Usar la función
executor_expectation_valuesdeqiskit-addon-utilspara combinar todos los datos en un valor esperado con mitigación de errores.
# Computing the TREX factors
measurement_noise_map = noise_learner_result[2].to_pauli_lindblad_map()
trex_rescale_factors = trex_factors(measurement_noise_map, bases_reverser)

# Post-select the results
post_selector = PostSelector.from_circuit(
    circuit=template_circuit, coupling_map=backend.coupling_map
)

# Compute the ps mask for filtering results
mask = post_selector.compute_mask(exec_results[0], strategy="edge")

# Compute expvals using post selected results
results = executor_expectation_values(
    exec_results[0]["meas"],
    bases_reverser,
    meas_basis_axis=0,
    avg_axis=1,
    measurement_flips=exec_results[0]["measurement_flips.meas"],
    pauli_signs=exec_results[0].get("pauli_signs", None),
    postselect_mask=mask,
    rescale_factors=trex_rescale_factors,
)
Comparar estrategias de mitigación: PNA, PNA+TREX, PNA+PS, PNA+PS+TREX
Calculamos y visualizamos valores esperados para varias variantes de mitigación usando los resultados del Executor.
bases_reverser_unmit = {Pauli("Z" * num_qubits): [observable]}
args = [
    (bases_reverser_unmit, None, None),
    (bases_reverser, None, None),
    (bases_reverser, None, trex_rescale_factors),
    (bases_reverser, mask, None),
    (bases_reverser, mask, trex_rescale_factors),
]

evs = []
for reverser, postsel_mask, factors in args:
    # Compute expvals using post selected results
    res_ps = executor_expectation_values(
        exec_results[0]["meas"],
        reverser,
        meas_basis_axis=0,
        avg_axis=1,
        measurement_flips=exec_results[0]["measurement_flips.meas"],
        pauli_signs=exec_results[0].get("pauli_signs", None),
        postselect_mask=postsel_mask,
        rescale_factors=factors,
    )
    res_ps = np.array(res_ps)
    evs.append(res_ps[:, 0][0])

experiments = ["PNA", "PNA+TREX", "PNA+PS", "PNA+PS+TREX"]
colors = ["#d9d9d9", "#b0b0b0", "#7f7f7f", "#4c4c4c"]
plt.bar(experiments, evs[1:], color=colors)
plt.axhline(y=1, color="green", linestyle="--", linewidth=2, label="Ideal")
plt.axhline(
    y=evs[0], color="red", linestyle="--", linewidth=2, label="Unmitigated"
)
plt.ylabel("Expectation value", fontsize=14)

plt.title(
    r"30q Mirrored Ising, 10 Trotter steps, $\theta_{rx}=\frac{\pi}{8}$",
    fontsize=14,
)
plt.legend(loc="upper left", bbox_to_anchor=(1.05, 1), borderaxespad=0.0)
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()

Los resultados demuestran los beneficios acumulativos de combinar diferentes técnicas de mitigación de errores. El enfoque PNA simple ya restaura el valor esperado cerca del valor de referencia ideal, indicando que propagar canales de ruido inverso hacia el observable compensa eficazmente los errores de puertas de dos qubits.
-
Añadir la reponderación TREX (PNA+TREX) mejora ligeramente la estimación al corregir el desequilibrio de muestreo en los circuitos aleatorizados.
-
La postselección (PNA+PS) proporciona una mejora más notable al filtrar resultados de medición inconsistentes que probablemente resultan de errores residuales.
-
Finalmente, combinar ambos (PNA+PS+TREX) produce el resultado más preciso, casi igualando el valor ideal, mostrando cómo estas estrategias de mitigación se refuerzan mutuamente.
En general, la comparación destaca que PNA sirve como una base robusta para la estimación de valores esperados consciente del ruido, mientras que TREX y la postselección ofrecen refinamientos complementarios para lograr mayores ganancias de precisión.
Próximos pasos
Si este trabajo te resultó interesante, podrían interesarte los siguientes materiales: