Aprende estados cuánticos ruidosos con sombras clásicas
Estimación de uso: 34 minutos en un procesador Heron r2 (NOTA: Esto es solo una estimación. Tu tiempo de ejecución puede variar.)
Resultados de aprendizaje
-
Recopilar mediciones aleatorizadas en un procesador cuántico de IBM® desde Julia y guardarlas para su análisis posterior
-
Comprobar en los datos de medición si hay qubits y puertas defectuosos antes de aprender
-
Ajustar un modelo de operador de producto de matrices (MPO) de un estado ruidoso a partir de sombras clásicas
-
Validar el modelo con mediciones reservadas y compararlo con el circuito ideal
Requisitos previos
-
Sombras clásicas, tal como se presentan en el tutorial Tomografía de sombras del estado de Greenberger-Horne-Zeilinger (GHZ)
-
Matrices de densidad y estados mixtos, tratados en Fundamentos de la información cuántica
-
Ejecución de circuitos desde Julia con
Qiskit.jlyQiskitIBMRuntime.jl, presentada en el tutorial Simular la evolución temporal del modelo de Ising de campo transversal
Contexto
En un procesador cuántico real, el ruido convierte el estado puro que un circuito está diseñado para preparar en un estado mixto . La tomografía completa del estado cuántico puede reconstruir , pero el número de mediciones que necesita crece exponencialmente con el número de qubits. En cambio, Votto et al. [1] aprendieron un modelo compacto de para hasta 96 qubits a partir de mediciones aleatorizadas. Este tutorial sigue su flujo de trabajo.
En una medición aleatorizada [2], cada qubit se rota con un unitario aleatorio independiente y luego se mide en la base computacional. Una realización de las rotaciones se denomina configuración de medición, y cada configuración se repite durante shots. Un shot con bits de resultado da la sombra clásica [3]
cuyo promedio sobre configuraciones y shots es . El tutorial de requisitos previos toma cada de las tres bases de Pauli; este tutorial, como el artículo, los toma uniformemente de todos los unitarios de un solo qubit (aleatorios según Haar), y se aplica la misma fórmula.
Las sombras estiman propiedades de unos pocos qubits a la vez. El artículo las combina en un operador de producto de matrices (MPO), que escribe la matriz de densidad como una cadena de tensores pequeños, uno por qubit; los estados ruidosos con correlaciones de corto alcance solo necesitan enlaces pequeños entre tensores vecinos. Al igual que el algoritmo del grupo de renormalización de la matriz de densidad (DMRG), el aprendiz recorre la cadena y actualiza un tensor cada vez, de modo que el modelo coincida con las sombras en la ventana de qubits centrada en ese tensor (ecuación 4 del artículo). La dimensión del enlace permanece fija durante estas actualizaciones, por lo que el aprendiz nunca trunca el modelo. Como los datos entran solo a través de estas ventanas, el número de configuraciones necesarias no crece con la longitud de la cadena.
Las configuraciones se dividen en un conjunto de entrenamiento y un conjunto de prueba. En el conjunto de prueba, el artículo estima la fidelidad máxima entre y el modelo ,
Medir directamente requeriría un número exponencial de mediciones. En su lugar, el artículo supone la condición de factorización aproximada (AFC): las correlaciones en decaen dentro de unos pocos qubits, de modo que los solapamientos y purezas globales se factorizan en términos sobre bloques de qubits vecinos. La pureza también da la entropía de Rényi-2 , que mide cuán mixto es el estado.
El artículo prepara el estado de Ising pateado de profundidad
en 96 qubits de ibm_brisbane, un procesador Eagle, con 2048 configuraciones de 1024 shots para . La figura 1(c,d) del artículo presenta dos resultados para :
-
El modelo aprendido alcanza con el estado experimental en , muy por encima del solapamiento del estado ideal con el experimento.
-
La entropía crece linealmente, , y la entropía del modelo concuerda con una estimación independiente a partir del conjunto de prueba.
Este tutorial comprueba ambos resultados, primero en una simulación de ocho qubits donde se conocen las respuestas exactas, y luego en una nueva ejecución de 96 qubits en ibm_fez, un procesador Heron r2. El aprendiz es una implementación independiente en Julia de las ecuaciones del artículo y de su suplemento.
Requisitos
Este tutorial requiere macOS o Linux, porque Qiskit.jl todavía no es compatible con Windows (incidencia #15 de Qiskit.jl). También necesitas lo siguiente:
-
Julia 1.11, desde la página de descarga de Julia o con
juliaup add 1.11, y el paqueteIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Para el ejemplo con hardware, una cuenta de IBM Quantum® Platform con acceso a una QPU que tenga al menos 96 qubits, y credenciales guardadas. Sin una cuenta, puedes ejecutar el ejemplo con hardware a partir de las mediciones guardadas de la ejecución en
ibm_fezque produjo los resultados de este tutorial. Las demás secciones se ejecutan sin una cuenta.
El notebook usa Qiskit.jl y QiskitIBMRuntime.jl para construir y ejecutar circuitos, RandomMeas.jl [4] para las mediciones aleatorizadas (que también proporciona ITensors.jl y ITensorMPS.jl), y NPZ.jl, JSON.jl y Plots.jl. Este tutorial se ha probado con Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 y RandomMeas.jl 0.3.1.
Hay dos formas de configurar el entorno:
-
Opción 1: instala las últimas versiones compatibles de los paquetes en un entorno temporal. Ejecuta la siguiente celda sin cambios.
-
Opción 2: reproduce exactamente el entorno probado. Establece
download_toml_files = trueen la siguiente celda. La celda descargaProject.tomlyManifest.tomldel repositorio de documentación en una carpetaenv_tutorial/classical-shadows/junto a este notebook, y luego instala la versión exacta de cada paquete que registra el manifiesto, incluidas las dependencias indirectas. Para más detalles, consulta la documentación de Julia sobre estos archivos.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Configuración
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
El módulo auxiliar mpo_learning.jl, que descarga la celda de configuración, implementa el aprendiz. El tutorial llama a las siguientes funciones de él:
| Función | Propósito |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO exacto del estado de Ising pateado ideal, o del estado tras ruido despolarizante local |
split_settings(group; seed, train_fraction) | Asigna aleatoriamente las configuraciones de medición a los conjuntos de entrenamiento y de prueba (la mitad cada uno por defecto) |
training_marginals(train; ell, prior) | Estimaciones por sombras de cada ventana de aprendizaje, solo a partir de las configuraciones de entrenamiento |
fitted_prior(ideal, train) | Prior para las mediciones aleatorizadas comunes (CRM), ajustado a la pureza medida de cada ventana, como en el artículo |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Recorre la actualización de un solo sitio del artículo a lo largo de la cadena, partiendo del estado máximamente mixto |
max_fidelity(a, b), mpo_overlap(a, b) | exacta y entre dos MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Estimaciones AFC de y a partir de las configuraciones de prueba, con barras de error jackknife |
El aprendiz almacena el MPO en la base de Pauli. Esto mantiene el modelo hermítico y con traza unitaria, pero no obliga a que sea semidefinido positivo, por lo que el notebook informa de cuán negativos se vuelven sus autovalores.
Ejemplo a pequeña escala con simulador
Empieza con un sistema lo bastante pequeño como para calcular todo de forma exacta: el estado de Ising pateado de profundidad uno en ocho qubits, con un 12 % de ruido despolarizante local para modelar el hardware. Como se conoce el estado ruidoso, puedes comparar directamente el modelo aprendido con él.
Paso 1: Convertir las entradas clásicas en un problema cuántico
La función kicked_ising_reference devuelve el estado exacto como un MPO. Con depolarization=0.12, el vector de Bloch de cada qubit se reduce un 12 % tras el circuito.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Paso 2: Optimizar el problema para la ejecución en hardware cuántico
Este ejemplo muestrea los resultados de medición de forma clásica, así que no hay ningún circuito que transpilar. El ejemplo con hardware cubre este paso.
Paso 3: Ejecutar con las primitivas de Qiskit
Usa RandomMeas.jl para generar 2048 configuraciones de medición aleatorias según Haar y muestrear 256 shots de cada una, y luego divide las configuraciones a partes iguales en conjuntos de entrenamiento y de prueba. Divide por configuración y no por shot: los shots de una misma configuración comparten sus rotaciones, por lo que no son independientes.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Paso 4: Posprocesar y devolver el resultado en el formato clásico deseado
Aprende el modelo con los parámetros de profundidad uno del artículo: ventanas que se extienden qubits a cada lado del tensor actualizado, una dimensión de enlace de 4 y 20 barridos partiendo del estado máximamente mixto. El primer barrido actualiza pares de tensores vecinos, lo que permite que la dimensión del enlace crezca de 1 a 4; cada barrido posterior actualiza un tensor cada vez con esa dimensión de enlace fija.
Para reducir el ruido estadístico de las sombras, el artículo usa mediciones aleatorizadas comunes (CRM) [5]. Para cada configuración, resta la sombra promedio que produciría una suposición previa del estado en la misma configuración, y luego suma de nuevo el valor exacto del prior. La corrección tiene promedio cero, por lo que el prior cambia el tamaño del error estadístico pero no lo que se estima. Aquí el prior es el estado ideal con un 10 % de despolarización local, cercano al 12 % real. En hardware el nivel de ruido es desconocido, así que el ejemplo con hardware ajusta el prior a purezas medidas, como hace el artículo.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
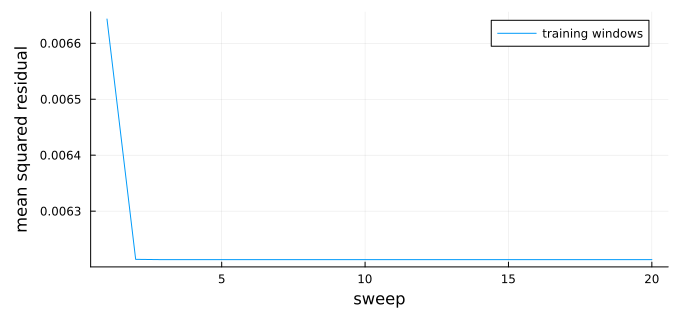
El residuo mide cuánto se alejan las ventanas del modelo de las sombras de entrenamiento. Baja cuando comienzan las actualizaciones de un solo sitio, en el segundo barrido, y luego permanece aproximadamente constante en lugar de llegar a cero, porque las sombras contienen ruido estadístico que un modelo con una dimensión de enlace pequeña no puede reproducir.
Como este estado es conocido, puedes comparar exactamente el modelo aprendido con él, y también comparar con él las dos suposiciones más simples: el prior CRM y el estado ideal.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
El modelo aprendido está más cerca del estado ruidoso que el prior o el estado ideal, así que ha aprendido el ruido a partir de los datos. Sus pequeños autovalores negativos provienen del número finito de mediciones.
En hardware el estado es desconocido, así que en su lugar estimas a partir de las configuraciones de prueba. AFC divide la cadena en bloques de qubits y aproxima la pureza mediante
y por la misma razón de solapamientos locales. Con , los dos bloques cubren los ocho qubits y la fórmula es exacta; con , se basa en el supuesto de factorización. Las barras de error jackknife, que dejan fuera un ajuste de prueba cada vez, cubren únicamente el error estadístico de los datos de prueba, no la aleatoriedad del entrenamiento ni la aproximación AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Ambas estimaciones reservadas concuerdan con el valor exacto dentro de sus barras de error.
Ejemplo de hardware a gran escala
Ahora ejecuta el experimento en una cadena de 96 qubits de ibm_fez, un procesador Heron r2. Al igual que ibm_brisbane, tiene un mapa de acoplamiento heavy-hex y un nivel de ruido similar.
Recopilar los datos requiere 1,024 trabajos de Sampler y unos 34 minutos de tiempo de QPU. Si no tienes acceso a una QPU con al menos 96 qubits, o la cola es larga, ejecuta el ejemplo de hardware a partir de las mediciones registradas en ibm_fez el 27 de septiembre de 2026, que produjeron los resultados mostrados en este tutorial. Con use_saved_data = true, el notebook descarga estas mediciones (15 MB) desde Zenodo [6] en el Paso 1 y omite el envío de trabajos en el Paso 3. Para recopilar tus propios datos, establécelo en false.
use_saved_data = true; # set to false to collect new measurements on hardware
Paso 1: Asignar entradas clásicas a un problema cuántico
Cada ajuste necesita un circuito: el circuito kicked-Ising, una puerta en cada qubit para y una medición de cada qubit. Muestrear , con , y uniformes en , hace que sea aleatoria de Haar. La función u3_matrix devuelve la matriz de , que el Paso 4 utiliza.
El presupuesto es de 1,024 ajustes de 1,024 shots, la mitad del número de ajustes del artículo, repartidos a partes iguales entre entrenamiento y prueba. Con datos guardados, la celda carga los ángulos registrados. En caso contrario, genera ángulos nuevos y los guarda antes de que envíes nada, porque no puedes analizar los resultados sin ellos. Si el archivo ya existe, la celda lo carga, de modo que los ángulos sigan coincidiendo con los resultados guardados después de reiniciar la sesión.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Paso 2: Optimizar el problema para su ejecución en hardware cuántico
Una cadena es tan buena como su peor qubit, así que elige tú mismo los 96 qubits físicos. La función transpile de Qiskit.jl todavía no puede aceptar un layout inicial fijo, y en una prueba en ibm_phoenix, el layout que eligió incluía un qubit con un 51% de error de lectura. La siguiente cadena es el camino de 96 qubits en el mapa de acoplamiento de ibm_fez que el layout con detección de errores de la función transpile de Qiskit para Python (con optimization_level=3) seleccionó a partir de los datos de calibración del 27 de septiembre de 2026. Su error de lectura medio es del 1.6%, pero una red heavy-hex tiene pocos caminos de 96 qubits, y este incluye el qubit 35, que tiene un 15% de error de lectura. Las calibraciones cambian, así que elige una cadena nueva a partir de los datos de calibración actuales antes de ejecutar otro día o en otra QPU.
Para conservar esta cadena, escribe los circuitos directamente en puertas nativas en lugar de transpilarlos. Una puerta es igual a salvo por una fase global. Esta descomposición cubre tanto las rotaciones aleatorias como el kick . La puerta es igual a una puerta CZ seguida de en ambos qubits, salvo por una fase global. Como estas puertas son diagonales, conmutan con las puertas CZ, de modo que cada qubit acumula un por enlace antes de su rotación de medición.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Paso 3: Ejecutar usando primitivas de Qiskit
QiskitIBMRuntime.jl ejecuta un circuito por trabajo de Sampler, por lo que recopilar los datos requiere 1,024 trabajos. La siguiente celda mantiene hasta 32 trabajos en la cola y guarda los resultados de cada ajuste en cuanto termina su trabajo. Cada shot se devuelve como un vector de bits, en el que el elemento es el resultado del qubit de la cadena.
Debes recuperar los resultados en la misma sesión que envió los trabajos, porque QiskitIBMRuntime.jl todavía no puede buscar un trabajo por su ID (qiskit-ibm-runtime-c issue #28). Si un trabajo falla, la celda emite una advertencia y continúa. Si la sesión se detiene, ejecuta de nuevo los Pasos 1 a 3. Al volver a ejecutar la celda, solo se envían los ajustes cuyos resultados faltan. Con use_saved_data = true, la celda no envía nada.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Paso 4: Posprocesar y devolver el resultado en el formato clásico deseado
Este paso lee únicamente datos guardados: la ejecución descargada de ibm_fez si use_saved_data es true, o, en caso contrario, los archivos que escribió el Paso 3. Por lo tanto, puedes ejecutarlo en una sesión nueva sin enviar trabajos (ejecuta primero la celda de Setup, la celda use_saved_data y el Paso 1). El archivo descargado almacena los 96 resultados de cada shot empaquetados en 12 bytes, con el bit más significativo primero, por lo que el cargador los desempaqueta. RandomMeas.jl etiqueta los resultados como 1 y 2, así que el cargador también suma 1 a cada bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Antes de aprender, comprueba los datos. Un qubit defectuoso o una puerta mal calibrada hacen que el estado medido esté mucho más mezclado a su alrededor, y pueden hacer que el aprendiz diverja. La pureza de unos pocos qubits vecinos es una referencia, independiente de modelos, de este ruido: la función get_purity de RandomMeas.jl estima para un subsistema comparando pares de shots del mismo ajuste. Calcula la entropía de Rényi-2 de cada ventana de seis qubits vecinos y compárala con la misma ventana del estado ideal. El valor ideal no es cero, porque cada ventana está entrelazada con el resto de la cadena; el ruido lo aumenta, y un qubit defectuoso empuja hacia el máximo de seis a cada ventana que lo contiene.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
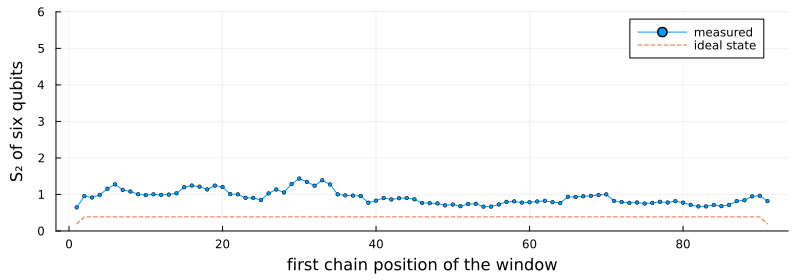
Todas las ventanas están más mezcladas que el estado ideal, en aproximadamente medio bit a un bit, y el tramo más ruidoso está alrededor de las posiciones 30 a 35 de la cadena. Ninguna ventana se acerca al máximo de seis, así que ningún qubit está defectuoso, y el análisis usa toda la cadena de 96 qubits. Si algunas ventanas tuvieran una entropía cercana a seis, eliminarías el qubit que esas ventanas comparten y aprenderías la parte más larga de la cadena sin él.
Las mismas purezas determinan el prior CRM. Para cada ventana, fitted_prior toma el estado ideal y ajusta una intensidad de despolarización local de modo que su pureza coincida con la pureza medida en los ajustes de entrenamiento, como en el artículo.
La función learn_and_validate de la siguiente celda realiza el resto del análisis. Aprende el modelo a partir de los ajustes de entrenamiento y luego estima y en los ajustes de prueba para los primeros qubits de la cadena, en pasos de 12. Estas son las cantidades de la Figura 1(c,d) del artículo. El estado ideal se evalúa sobre los mismos datos de prueba como referencia.
La celda ejecuta la función con y luego la repite con y para ver cuánto importa el tamaño de las ventanas de aprendizaje. La dimensión de enlace puede ser como máximo , por lo que aprende un estado producto: cada qubit por separado, sin correlaciones entre qubits.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
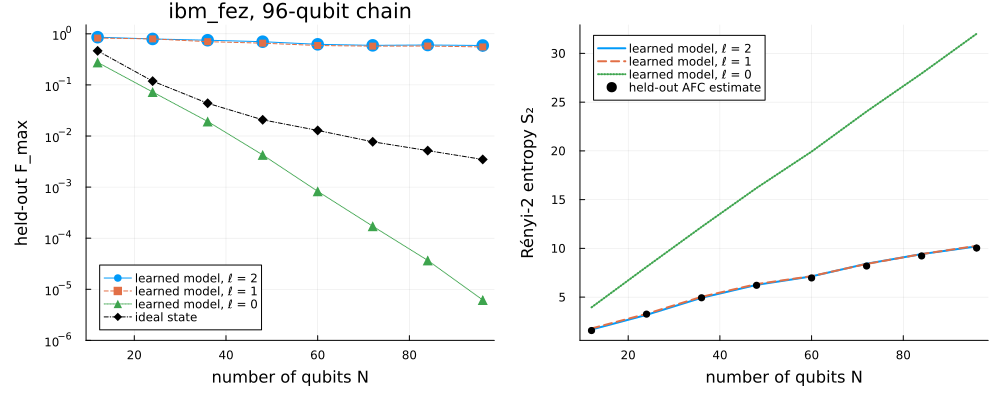
Los resultados reproducen las dos afirmaciones del artículo en un procesador diferente:
-
El modelo describe los datos mucho mejor que el estado ideal. Con , el reservado del modelo con es 0.59 ± 0.10, frente a 0.0035 del estado ideal. El artículo informa de aproximadamente 0.75 en
ibm_brisbane. -
La entropía del modelo concuerda con los datos de prueba para cada . Con , es 10.2 según el modelo y 10.0 ± 0.3 según los datos de prueba, es decir, , frente a 0.14 a 0.15 en el más antiguo
ibm_brisbane.
La comparación de tamaños de ventana muestra dónde está la información. Con , el modelo es casi igual de bueno (), así que para estos datos, las correlaciones más allá de unos pocos qubits aportan poco. Con , el estado producto no capta el entrelazamiento entre qubits vecinos: su entropía crece hasta 32 en lugar de 10, y su cae incluso más rápido que el del estado ideal, hasta con .
Ten en cuenta las siguientes limitaciones al leer estos números:
-
División de entrenamiento. Las barras de error cubren únicamente el error estadístico de los datos de prueba. Otras divisiones aleatorias de los mismos ajustes dan un entre 0.49 y 0.59 con para .
-
Barrido final. El aprendiz siempre devuelve el modelo del barrido final, de modo que los datos de prueba nunca influyen en el modelo.
-
Positividad. El modelo no está restringido a ser semidefinido positivo; su autovalor más negativo en una ventana de aprendizaje es de aproximadamente . Por lo tanto, su y su describen un operador, no propiedades certificadas de un estado físico.
-
Factorización. Cada estimación reservada se basa en el supuesto AFC, que las propias mediciones no pueden certificar.
Próximos pasos
-
Repite el experimento con profundidad dos usando los parámetros del artículo para esa profundidad ( y una dimensión de enlace máxima de 8), y determina cuántos ajustes de medición necesita el aprendiz.
-
Aprende con la actualización de dos sitios en su lugar (
update=:two_siteentraining_marginalsylearn_mpo), que trunca la dimensión de enlace después de cada paso, y observa cómo se comporta con menos ajustes de entrenamiento. -
Aprende sin el prior CRM (
prior=nothing) y compara la fidelidad reservada. -
Aplica el mismo análisis a las mediciones de
ibm_brisbanepublicadas por los autores. -
Lee el suplemento del artículo para ver la derivación de la actualización y de los estimadores AFC.
-
Explora otros protocolos de medición aleatorizada en los ejemplos de
RandomMeas.jl.
Referencias
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174