Simular dispersión de neutrones con un flujo de trabajo Serverless de dinámica AQC + Trotter
Estimación de uso: 18 minutos en un procesador Heron r3 (NOTA: Esto es solo una estimación. Tu tiempo de ejecución puede variar.)
Resultados de aprendizaje
-
Cómo un espectro de dispersión inelástica de neutrones se mapea al factor de estructura dinámica de un imán cuántico 1D.
-
Cómo preparar el estado fundamental de KCuF (Heisenberg isotrópico) con el grupo de renormalización de matriz de densidad (DMRG) y la maximización de fidelidad de estado de producto de matrices (MPS).
-
Cómo ejecutar la evolución temporal de Trotter, la compresión de circuitos de compilación cuántica aproximada (AQC), y la ejecución mitigada como una sola llamada de función.
-
Cómo post-procesar la serie temporal por sitio en e identificar el continuo de dos espinones.
Prerrequisitos
-
Familiaridad con patrones de Qiskit,
SparsePauliOp, y evolución temporal de Trotter. -
Es útil, aunque no obligatorio, tener conocimientos básicos de métodos de redes tensoriales (DMRG y MPS), así como familiaridad con la biblioteca
qiskit-addon-aqc-tensorque la función usa para comprimir circuitos de Trotter.
Contexto
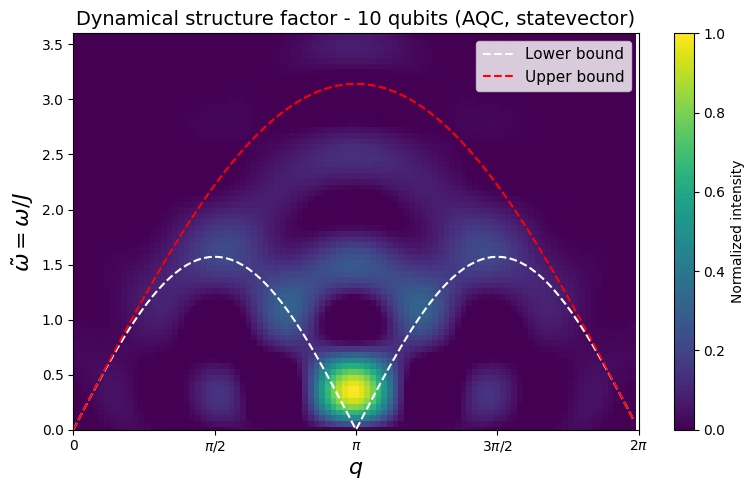
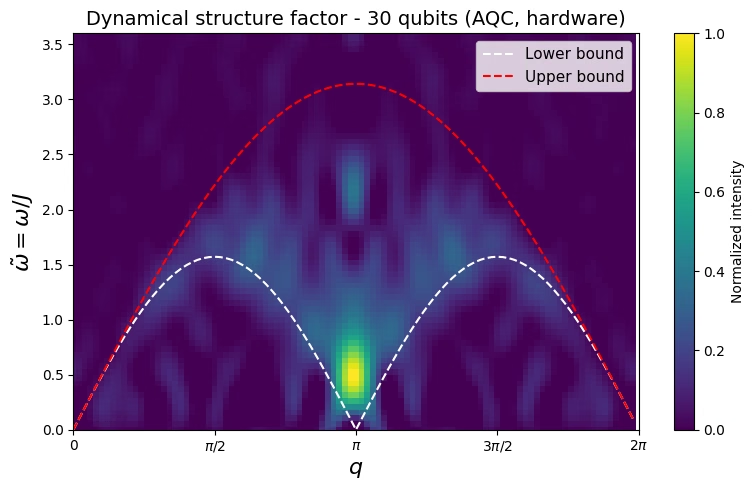
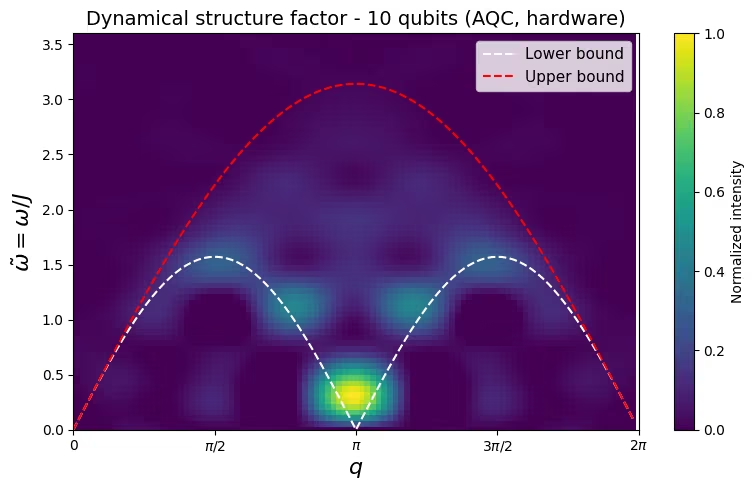
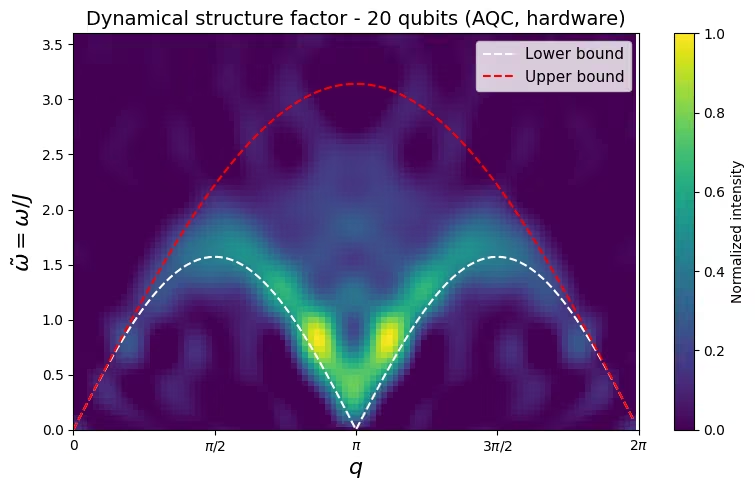
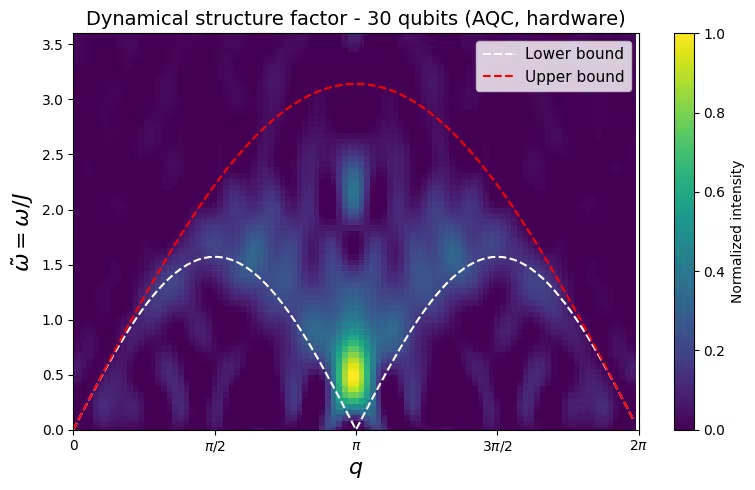
La dispersión inelástica de neutrones mide el factor de estructura dinámica , la transformada de Fourier espacio-temporal de la función de correlación espín-espín, por lo que reproducir a partir de un modelo de espín microscópico es una prueba directa y falsable de una simulación cuántica. Este tutorial estudia KCuF, una cadena de Heisenberg antiferromagnética de espín- cuyas excitaciones no son giros de espín únicos sino pares de espinones fraccionados: en lugar de una dispersión de magnón nítida, muestra un amplio continuo de dos espinones, acotado por debajo por y por arriba por . Esas son las curvas discontinuas en los gráficos que siguen. La física completa, y la comparación con los datos de neutrones medidos, se cubren en el tutorial original y en Lee et al., arXiv:2603.15608.
El flujo de trabajo cuántico refleja el experimento de dispersión:
-
Prepara el estado fundamental de la cadena .
-
Golpéalo con una perturbación local en el sitio central, una rotación de , imitando la transferencia de momento y energía del neutrón.
-
Evoluciona temporalmente bajo el Hamiltoniano de Heisenberg, , con una fórmula de producto de Trotter.
-
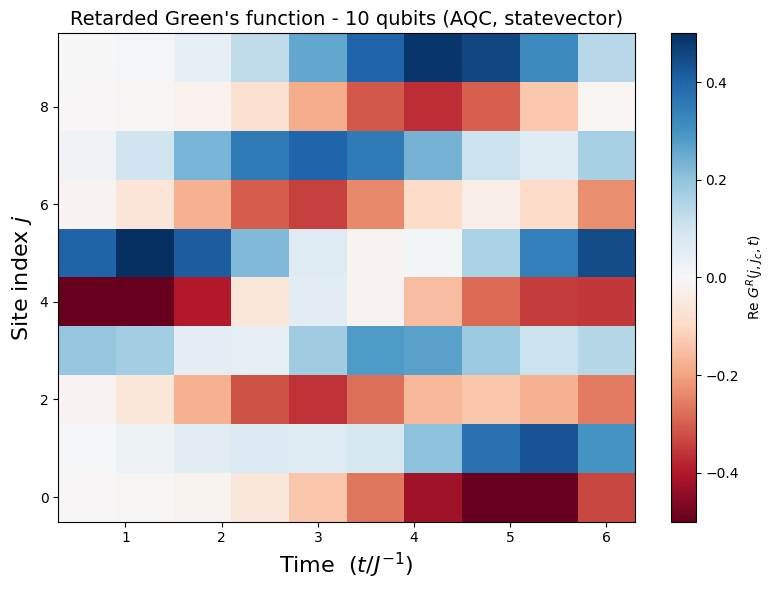
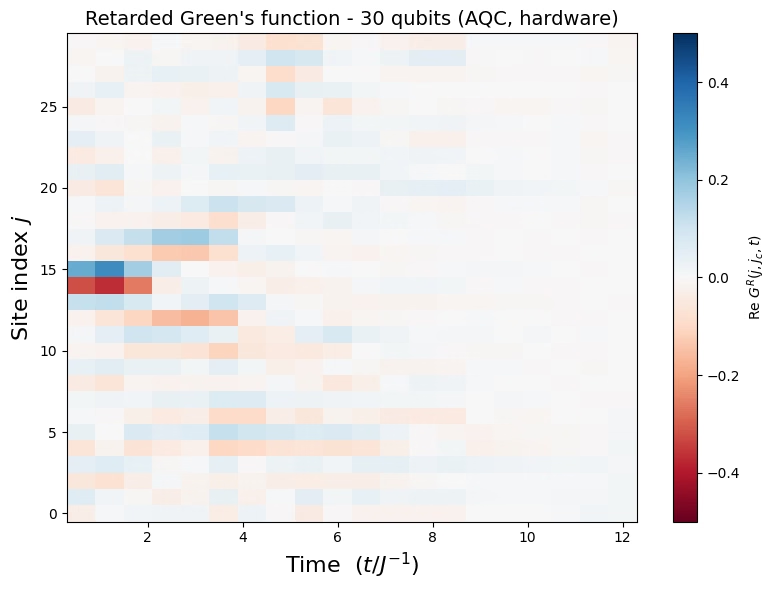
Mide la magnetización por sitio . Como función del sitio y el tiempo , esto es exactamente la función de Green retardada , por lo que no se necesita conversión antes de la transformada de Fourier en el paso 5.
-
Transforma mediante Fourier en .
Pueden surgir problemas en el paso 3, cuando los circuitos exactos de Trotter para evoluciones largas se vuelven demasiado profundos para el hardware. AQC con redes tensoriales aborda esto comprimiendo un bloque de pasos de Trotter en un ansatz parametrizado fijo y poco profundo cuya fidelidad de estado con la evolución exacta se maximiza clásicamente con un simulador MPS (arXiv:2301.08609). La Plantilla de dinámica AQC empaqueta todo este núcleo cuántico (síntesis de Trotter, compresión AQC, y ejecución mitigada) detrás de una sola llamada:
| PRE (este notebook) | FUNCIÓN (aqc-dynamics-function) | POST (este notebook) |
|---|---|---|
| Estado fundamental a partir de DMRG más maximización de fidelidad MPS, con el impulso de neutrón incorporado en el mismo circuito | Síntesis de Trotter → compresión AQC → ejecución en statevector, fake, o runtime, devolviendo por sitio | , el factor de estructura dinámica |
El trabajo específico del experimento se queda aquí en el notebook: la preparación del estado fundamental (PRE) y el posprocesamiento de (POST). Los dos pasos con más carga cuántica, la compresión y la ejecución, se ejecutan dentro de la función.
Este tutorial es complementario a Simular la dispersión de neutrones en materiales cuánticos con circuitos cuánticos, que construye el mismo experimento en línea: el mismo modelo KCuF, la preparación del estado fundamental, la patada de neutrón y el posprocesamiento, con la síntesis de Trotter, la compresión AQC y la ejecución mitigada escritas paso a paso. Lee ese tutorial para aprender cómo funciona la compresión AQC. Lee este para ejecutar el mismo experimento a través de una plantilla de función desplegada: el núcleo cuántico se convierte en una única llamada a función, y la compresión AQC de varias horas se ejecuta dentro del worker de Serverless en lugar de en tu máquina, de modo que no necesitas un sistema HPC ni un kernel abierto mientras se ejecuta. La misma llamada también impulsa otros experimentos de dinámica 1D.
Requisitos
Antes de empezar este tutorial, asegúrate de tener lo siguiente:
-
La función desplegada en tu cuenta de Qiskit Serverless. Ejecuta primero la plantilla de función complementaria: Desplegar y ejecutar la plantilla de función de dinámica AQC + Trotter. Esa guía explica cómo obtener los archivos fuente y subir la función a tu cuenta. Este tutorial solo llama a la función desplegada.
-
Credenciales de IBM Quantum® guardadas para
QiskitServerless(consulta la plantilla de función). Ambos ejemplos de este tutorial llaman a la función desplegada, así que ambos las necesitan. -
Qiskit SDK v2.0 o posterior (
pip install qiskit). -
El cliente de Qiskit IBM Catalog (
pip install qiskit-ibm-catalog). -
NumPy, SciPy y Matplotlib (
pip install numpy scipy matplotlib). Se necesita SciPy 1.14 o posterior para el optimizador COBYQA utilizado en la preparación del estado fundamental. -
El stack de red tensorial AQC, porque la preparación del estado fundamental en el Paso 1 se ejecuta localmente en este notebook:
pip install 'qiskit-addon-aqc-tensor[quimb-jax]==0.3.1'.
La primera llamada a una función recién desplegada espera mientras el worker de Serverless instala sus dependencias, así que espera latencia adicional en esa ejecución.
Configuración
Importa las bibliotecas y define los ayudantes específicos del experimento que se usarán más adelante: build_gs_ansatz (el ansatz variacional hamiltoniano, o HVA, para la preparación del estado fundamental), prepare_ground_state (DMRG más maximización de la fidelidad MPS) y get_spectrum, plot_green y plot_spectrum (el posprocesamiento de ). Estos se adaptan del tutorial original de dispersión de neutrones.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-addon-aqc-tensor qiskit-ibm-catalog quimb scipy
from functools import partial

import matplotlib.pyplot as plt
import numpy as np
import scipy.optimize

import quimb.tensor as qtn
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_addon_aqc_tensor.simulation import tensornetwork_from_circuit
from qiskit_addon_aqc_tensor.simulation.quimb import QuimbSimulator
from qiskit_ibm_catalog import QiskitServerless
#  Dynamical structure factor via discrete Fourier transform

def get_spectrum(n, Gjjc, dt, time_steps, q_steps, w_steps):
    """Compute the dynamical structure factor from the retarded Green's function.

    Uses the center-site approximation and a discrete Fourier transform.
    """
    green = Gjjc / 4  # sigma -> S=1/2
    omega_max = np.pi / dt
    qpoints = np.arange(0, 2 * np.pi, 2 * np.pi / q_steps)
    omegas = np.arange(0, omega_max, omega_max / w_steps)
    green_map = np.zeros((omegas.shape[0], qpoints.shape[0]))
    center = n // 2 - 1
    for iw, w in enumerate(omegas):
        exponent = np.exp(1j * w * dt * np.arange(1, time_steps + 1))
        S_w = np.dot(green.T, exponent) * dt
        for iq, q in enumerate(qpoints):
            q_matrix = np.exp(-1j * q * np.arange(-center, center + 2, 1))
            green_map[iw, iq] = np.imag(np.dot(S_w, q_matrix))
    return green_map

#  Plotting helpers

def plot_spectrum(
    dsf,
    dt,
    q_steps,
    w_steps,
    lower_bound=False,
    upper_bound=False,
    title=None,
):
    """Heat-map of the dynamical structure factor."""
    omega_max = np.pi / dt
    qpoints = np.arange(0, 2 * np.pi, 2 * np.pi / q_steps)
    omegas = np.arange(0, omega_max, omega_max / w_steps)
    x, y = np.meshgrid(qpoints, omegas)
    fig, ax = plt.subplots(figsize=(8, 5))
    c = ax.pcolormesh(x, y, dsf / np.max(dsf), cmap="viridis", shading="auto")
    fig.colorbar(c, ax=ax, label="Normalized intensity")
    if lower_bound:
        ax.plot(
            qpoints,
            np.pi * np.abs(np.sin(qpoints)) / 2,
            "--",
            color="white",
            lw=1.5,
            label="Lower bound",
        )
    if upper_bound:
        ax.plot(
            qpoints,
            np.pi * np.abs(np.sin(qpoints / 2)),
            "--",
            color="red",
            lw=1.5,
            label="Upper bound",
        )
    ax.set_ylim(0, 3.6)
    ax.set_xlim(0, 2 * np.pi - 2 * np.pi / q_steps)
    ax.set_xlabel(r"$q$", fontsize=16)
    ax.set_ylabel(r"$\tilde{\omega} = \omega / J$", fontsize=16)
    ax.set_xticks([0, np.pi / 2, np.pi, 3 * np.pi / 2, 2 * np.pi])
    ax.set_xticklabels(["0", r"$\pi/2$", r"$\pi$", r"$3\pi/2$", r"$2\pi$"])
    if lower_bound or upper_bound:
        ax.legend(loc="upper right", fontsize=11)
    if title:
        ax.set_title(title, fontsize=14)
    plt.tight_layout()
    plt.show()

def plot_green(n, Gjjc, time_steps, dt, title=None):
    """Heat-map of the retarded Green's function in real space and time."""
    fig, ax = plt.subplots(figsize=(8, 6))
    t_axis = np.arange(1, time_steps + 1) * dt
    site_axis = np.arange(n)
    x, y = np.meshgrid(t_axis, site_axis)
    c = ax.pcolormesh(
        x,
        y,
        np.real(Gjjc).T,
        cmap="RdBu",
        vmax=0.5,
        vmin=-0.5,
        shading="auto",
    )
    fig.colorbar(c, ax=ax, label=r"Re $G^R(j, j_c, t)$")
    ax.set_xlabel(r"Time  ($t / J^{-1}$)", fontsize=16)
    ax.set_ylabel("Site index $j$", fontsize=16)
    if title:
        ax.set_title(title, fontsize=14)
    plt.tight_layout()
    plt.show()

#  Variational ground-state ansatz (HVA)

def _apply_xxz_pair_gate(qc, q0, q1, theta):
    """Apply the parameterized XXZ-type two-qubit gate used in the HVA."""
    qc.cx(q0, q1)
    qc.rz(theta, q1)
    qc.h(q0)
    qc.rz(theta + np.pi / 2, q0)
    qc.cx(q0, q1)
    qc.rz(-theta, q1)
    qc.h(q1)
    qc.cx(q1, q0)
    qc.rz(np.pi / 2, q1)
    qc.rz(-np.pi / 2, q0)
    qc.h(q1)
    qc.h(q0)

def build_gs_ansatz(n, params, layers):
    """Build the Hamiltonian variational ansatz (HVA) circuit for
    ground-state preparation of the 1D Heisenberg model.

    Starts from a product of singlet pairs and applies alternating
    odd/even layers of parameterized XXZ gates. For layer r,
    params[2 * r] is the odd-layer (inter-pair) angle and
    params[2 * r + 1] is the even-layer (intra-pair) angle.
    """
    qc = QuantumCircuit(n)
    # Initial singlet product state
    for i in range(n // 2):
        qc.x(2 * i)
        qc.x(2 * i + 1)
        qc.h(2 * i + 1)
        qc.cx(2 * i + 1, 2 * i)
    # Variational layers
    for r in range(layers):
        for i in range(1, (n + 1) // 2):  # odd layer
            _apply_xxz_pair_gate(qc, 2 * i - 1, 2 * i, params[2 * r])
        for i in range(n // 2):  # even layer
            _apply_xxz_pair_gate(qc, 2 * i, 2 * i + 1, params[2 * r + 1])
    return qc

def prepare_ground_state(n, gs_layers=5, max_bond=128, cutoff=1e-8):
    """Prepare the KCuF3 (isotropic Heisenberg) ground state as a QuantumCircuit.

    Runs DMRG (quimb MPO + DMRG2) to get the chain's ground state, then optimizes
    the HVA angles to maximize the MPS overlap |<psi_ansatz|psi_DMRG>|^2. No exact
    diagonalization, so it scales to larger n.
    """
    J = Jz = 1.0
    builder = qtn.SpinHam1D(S=1 / 2)
    builder += J * 0.5, "+", "-"
    builder += J * 0.5, "-", "+"
    builder += Jz, "Z", "Z"
    H_mpo = builder.build_mpo(L=n)
    dmrg = qtn.DMRG2(H_mpo)
    dmrg.solve(tol=1e-8, verbosity=0)

    gs_sim = QuimbSimulator(
        quimb_circuit_factory=partial(
            qtn.CircuitMPS, gate_opts=dict(cutoff=cutoff, max_bond=max_bond)
        ),
        autodiff_backend="jax",
    )

    def gs_infidelity(params):
        psi = tensornetwork_from_circuit(
            build_gs_ansatz(n, params, gs_layers), gs_sim
        ).psi
        return 1 - abs(psi.H @ dmrg.state) ** 2

    # Seed and optimizer match the original tutorial. Each layer starts at
    # [0, pi/2]: an odd-layer angle of 0 makes the inter-pair gate the identity,
    # and an even-layer angle of pi/2 makes the intra-pair gate a SWAP (since
    # 0.5 * (XX + YY + ZZ) = SWAP - I/2). That puts the seed at the singlet-pair
    # product limit, which is already a decent approximation to the Heisenberg
    # ground state, so the optimizer only has to refine it. The small jitter
    # (fixed RNG seed, so runs are reproducible) breaks the exact symmetry
    # between layers; COBYQA then runs for up to 100 iterations.
    rng = np.random.default_rng(12345)
    x0 = np.tile([0.0, np.pi / 2], gs_layers) + rng.normal(
        scale=0.1, size=2 * gs_layers
    )
    result_gs = scipy.optimize.minimize(
        gs_infidelity, x0, method="COBYQA", options={"maxiter": 100}
    )
    print(f"DMRG ground-state energy: {dmrg.energy:.6f}")
    print(f"GS fidelity: {1 - result_gs.fun:.4f}")
    return build_gs_ansatz(n, result_gs.x, gs_layers)

print("Setup complete - helpers defined.")
Setup complete - helpers defined.
Cargar la plantilla de función
Conéctate a Qiskit Serverless y carga la aqc-dynamics-function desplegada. Ambos ejemplos de este tutorial llaman al mismo identificador fn, así que la función se carga una sola vez, aquí.
# Credentials are read from the account saved once via QiskitServerless.save_account(...)
serverless = QiskitServerless()
fn = serverless.load("aqc-dynamics-function")
Ejemplo de simulador a pequeña escala
Primero ejecutamos el flujo de trabajo completo en una cadena pequeña de 10 sitios usando el backend exacto statevector. Esto valida el pipeline PRE → FUNCTION → POST antes de gastar tiempo de QPU.
Paso 1: Mapear entradas clásicas a un problema cuántico
Construye el hamiltoniano KCuF como un SparsePauliOp (Heisenberg isotrópico: con acoplamiento en cada enlace de vecinos más cercanos; las cadenas son operadores de Pauli, así que da el acoplamiento de espín ). Prepara el estado fundamental con DMRG más maximización de la fidelidad MPS, y luego incorpora la patada de neutrón: una rotación de en el sitio central. El circuito preparado es lo que entregamos a la función como initial_state. Dejamos observables en su valor predeterminado ( por sitio), que es exactamente la lectura que necesita el flujo de trabajo de neutrones.
n = 10
dt = 0.6  # physical time per Trotter step (also the omega-axis unit in POST)
time_steps = 10
center = n // 2 - 1

# MPS-simulator settings, shared by the ground-state prep here and the AQC
# compression inside the function (matches the original tutorial).
mps_max_bond = 32
mps_cutoff = 1e-8

# 1D isotropic Heisenberg (KCuF3) Hamiltonian on n qubits
H = SparsePauliOp.from_sparse_list(
    [(p, [i, i + 1], 0.25) for i in range(n - 1) for p in ("XX", "YY", "ZZ")],
    num_qubits=n,
)

# Ground state (DMRG + fidelity max) + neutron kick baked into the same circuit
gs_circuit = prepare_ground_state(
    n, gs_layers=3, max_bond=mps_max_bond, cutoff=mps_cutoff
)
gs_circuit.rz(
    np.pi / 2, center
)  # exp(-i (pi/2)/2 Z_center): the neutron perturbation
print(
    f"Prepared {n}-qubit ground state with the neutron kick at site {center}."
)
DMRG ground-state energy: -4.258035
GS fidelity: 0.9841
Prepared 10-qubit ground state with the neutron kick at site 4.
Pasos 2 y 3: Comprimir y ejecutar con la plantilla de función
En un flujo de trabajo escrito a mano, estas son dos etapas separadas: optimizar los circuitos para el hardware (Paso 2) y ejecutarlos (Paso 3). La plantilla de función combina ambas en una sola llamada. Realiza la síntesis de Trotter, la compresión AQC y la transpilación de hardware, y luego ejecuta los circuitos (aquí en el simulador exacto, más adelante con mitigación de errores integrada en hardware). Los dos parámetros de ajuste son aqc_segments (el plan de compresión) y aqc_options (los ajustes de MPS y del optimizador). Cada segmento {"n_steps": k, "ansatz_steps": m} comprime k pasos de Trotter consecutivos en un ansatz construido a partir de un objetivo de Trotter de m pasos, y cualquier paso más allá de sum(n_steps) se ejecuta como Trotter simple. Los pasos tempranos, de baja entrelazamiento, se comprimen bien en un ansatz superficial (ansatz_steps=1), así que aquí comprimimos los primeros tres pasos en un ansatz de una sola capa y los siguientes dos en un ansatz más profundo de dos capas; los cinco pasos restantes de los 10 pasos de Trotter se ejecutan como Trotter simple. Para aqc_options reproducimos el tutorial original: dimensión de enlace MPS max_bond=32, cutoff=1e-8, y un optimizador L-BFGS-B limitado a 100 iteraciones.
Llama a la función cargada en Configuración. backend="statevector" ejecuta la ruta de referencia exacta: sin tiempo de QPU, con los circuitos ejecutándose en un simulador exacto de vector de estado dentro del worker de serverless (aún se necesita una cuenta de Qiskit Serverless guardada para llamarla). initial_state lleva el estado fundamental preparado (incluida la patada); se omite observables, así que la función mide el predeterminado por sitio.
job = fn.run(
    t_steps=time_steps,
    aqc_segments=[
        {
            "n_steps": 3,
            "ansatz_steps": 1,
        },  # early steps -> shallow 1-layer ansatz
        {
            "n_steps": 2,
            "ansatz_steps": 2,
        },  # later steps -> deeper 2-layer ansatz
    ],
    aqc_options={
        "max_bond": mps_max_bond,  # MPS bond dimension for AQC compression
        "cutoff": mps_cutoff,
        "optimizer_settings": {
            "method": "L-BFGS-B",
            "jac": True,
            "options": {"maxiter": 100},
        },
    },
    dt=dt,
    hamiltonian=H,
    initial_state=gs_circuit,  # prepared ground state including the neutron kick
    # observables omitted -> default per-site Z (the neutron sigma_z readout)
    backend="statevector",
)
print(job.status()) # rerun this cell until status says DONE
DONE
# The per-site <sigma_z>(t) the function returns is the retarded Green's function
# G(j, j_c, t). The workflow samples t = 1..time_steps, so drop the t = 0 row (the
# prepared+kicked state before any evolution) before post-processing.
result = job.result()
print(
    "AQC fidelities:",
    {k: round(v, 4) for k, v in result["metadata"]["aqc_fidelities"].items()},
)

ev = np.array(result["expectation_values"])
Gjjc = ev[1:]  # shape (time_steps, n)
print("Green's function shape:", Gjjc.shape)
AQC fidelities: {'1': 1.0, '2': 0.9999, '3': 0.9992, '4': 0.9998, '5': 0.9995}
Green's function shape: (10, 10)
Paso 4: Posprocesar y devolver el resultado en el formato clásico deseado
Transforma mediante Fourier la función de Green en , simetriza en espejo y recorta los valores negativos: el posprocesamiento estándar de neutrones. El espejado es exacto porque para este modelo, y los valores negativos que sobreviven son artefactos de transformar mediante Fourier una serie temporal finita y muestreada de forma discreta, así que se recortan a cero. En esta ejecución exacta a pequeña escala, el continuo de dos espinones solo se resuelve de forma aproximada, pero la maquinaria es idéntica a la ejecución en hardware que sigue.
q_res, w_res = 100, 100
spectrum = get_spectrum(n, Gjjc, dt, time_steps, q_res, w_res)
spectrum = -(spectrum + spectrum[:, ::-1]) / 2  # mirror symmetry
spectrum = np.clip(spectrum, a_min=0, a_max=None)  # clip negatives

plot_green(
    n,
    Gjjc,
    time_steps,
    dt,
    title=f"Retarded Green's function - {n} qubits (AQC, statevector)",
)
plot_spectrum(
    spectrum,
    dt,
    q_res,
    w_res,
    lower_bound=True,
    upper_bound=True,
    title=f"Dynamical structure factor - {n} qubits (AQC, statevector)",
)
Ejemplo de hardware a gran escala
El mismo flujo de trabajo escala sin cambiar nada del código científico: una cadena de 30 sitios, el doble de profundidad de Trotter (20 pasos), un plan de compresión que varía la profundidad del ansatz (un ansatz más profundo para los pasos posteriores, más entrelazados) y la ejecución en un procesador de IBM Quantum con la mitigación de errores integrada de la función (desacoplamiento dinámico, twirling de Pauli y extinción de errores de lectura mediante twirling (TREX)). Recorremos los mismos cuatro pasos que en el ejemplo del simulador, reutilizando el identificador fn de Configuración.
| Escala pequeña | Escala grande | |
|---|---|---|
| Qubits | 10 | 30 |
| Pasos de Trotter | 10 | 20 |
| Pasos comprimidos con AQC (1 capa + 2 capas) | 3 + 2 = 5 | 6 + 4 = 10 |
| Capas del ansatz del estado fundamental | 3 | 5 |
| Dimensión de enlace máxima de MPS | 32 | 128 |
| Backend | statevector | QPU con DD, twirling de Pauli y TREX |
Paso 1: Mapear entradas clásicas a un problema cuántico
Construye el mismo SparsePauliOp de Heisenberg KCuF y prepara el estado fundamental, ahora con un ansatz más profundo gs_layers=5 para la cadena más larga, y luego incorpora la patada de neutrón de en el sitio central. Esto es idéntico al mapeo a pequeña escala, pero con .
Espera una fidelidad del estado fundamental menor que en la ejecución de 10 sitios: alrededor de 0.82 aquí frente a 0.98 para la cadena más pequeña, porque cinco capas de HVA no pueden capturar por completo un estado fundamental de 30 sitios. Eso es lo esperado y no un fallo, y el tutorial original acepta aproximadamente 0.65 en 50 sitios por el mismo motivo. Aumentar gs_layers o el límite de iteraciones de COBYQA lo mejora, a costa de un mayor coste clásico.
n = 30
dt = 0.6
time_steps = 20
center = n // 2 - 1

# Same MPS settings as the original large-scale run: a larger bond for the
# longer, more-entangled chain (shared by GS prep and AQC compression).
mps_max_bond = 128
mps_cutoff = 1e-8

# Same KCuF3 Hamiltonian and ground-state prep, on a larger chain
H = SparsePauliOp.from_sparse_list(
    [(p, [i, i + 1], 0.25) for i in range(n - 1) for p in ("XX", "YY", "ZZ")],
    num_qubits=n,
)
gs_circuit = prepare_ground_state(
    n, gs_layers=5, max_bond=mps_max_bond, cutoff=mps_cutoff
)
gs_circuit.rz(np.pi / 2, center)  # neutron kick at the center site
print(
    f"Prepared {n}-qubit ground state with the neutron kick at site {center}."
)
DMRG ground-state energy: -13.111355
GS fidelity: 0.8201
Prepared 30-qubit ground state with the neutron kick at site 14.
Pasos 2 y 3: Comprimir y ejecutar con la plantilla de función
La misma llamada única que en el ejemplo del simulador, ahora con backend_name apuntando a un procesador de IBM Quantum, de modo que la función transpila y ejecuta allí. El plan de compresión varía la profundidad del ansatz: los primeros seis pasos de Trotter (baja entrelazamiento) se comprimen en un ansatz superficial de una sola capa, los siguientes cuatro en un ansatz más profundo de dos capas, y los 10 pasos restantes de los 20 se ejecutan como Trotter simple. aqc_options eleva la dimensión de enlace de MPS a max_bond=128 para la cadena más larga y más entrelazada (coincidiendo con el original), manteniendo el mismo optimizador L-BFGS-B limitado a 100 iteraciones. estimator_options activa la mitigación de errores integrada: desacoplamiento dinámico (XY4), twirling de compuertas y mitigación de medición TREX. Los valores predeterminados de la función ya coinciden con el tutorial original para todos estos excepto el presupuesto de aprendizaje de TREX (measure_noise_learning). El bloque completo se sigue escribiendo porque un estimator_options suministrado por el llamador reemplaza por completo los valores predeterminados de la función en lugar de combinarse con ellos, así que omitir una clave revertiría al valor predeterminado de IBM Quantum Compute en lugar del de la función.
# Steps 2 + 3: the function compresses (varied ansatz) and executes on hardware.
job = fn.run(
    t_steps=time_steps,
    aqc_segments=[
        {
            "n_steps": 6,
            "ansatz_steps": 1,
        },  # early steps -> shallow 1-layer ansatz
        {
            "n_steps": 4,
            "ansatz_steps": 2,
        },  # later steps -> deeper 2-layer ansatz
    ],
    aqc_options={
        "max_bond": mps_max_bond,  # 128 for the longer chain
        "cutoff": mps_cutoff,
        "optimizer_settings": {
            "method": "L-BFGS-B",
            "jac": True,
            "options": {"maxiter": 100},
        },
    },
    dt=dt,
    hamiltonian=H,
    initial_state=gs_circuit,
    backend_name="ibm_pittsburgh",
    # Mitigation settings from the original tutorial. Only the two
    # measure_noise_learning values differ from the function's defaults; the rest
    # restates them, because a caller-supplied estimator_options dict replaces the
    # function's defaults wholesale rather than merging into them.
    estimator_options={
        "environment": {"job_tags": ["TUT-SNS"]},
        "dynamical_decoupling": {"enable": True, "sequence_type": "XY4"},
        "twirling": {
            "enable_gates": True,
            "num_randomizations": 1000,
            "shots_per_randomization": 128,
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 100,
            },
        },
    },
)
print("job ID (save this to reconnect later):", job.job_id)
job ID (save this to reconnect later): 43ed8d07-6d7d-4f33-b70a-7f31b765b310
La ejecución a gran escala no es rápida, y la mayor parte del tiempo es clásico en lugar de en la QPU. La compresión AQC se ejecuta dentro de la función antes de que nada llegue a la QPU: con 30 sitios y max_bond=128, eso tardó cerca de cuatro horas en nuestra ejecución, frente a los aproximadamente 18 minutos de tiempo de QPU citados en la Estimación de uso al principio de este tutorial. La espera en cola se suma a ambos. No necesitas mantener abierto este notebook ni el kernel mientras se ejecuta.
Copia el ID del trabajo que imprime la celda anterior y guárdalo. Las siguientes tres celdas te permiten retomar la ejecución más tarde:
-
Reconectar, solo necesario en una nueva sesión de kernel: vuelve a ejecutar las celdas de Configuración para recrear
serverless, y luego reconstruye el identificadorjoba partir del ID que guardaste. Omite esta celda si sigues en la sesión donde enviaste el trabajo, porque el identificador ya está activo. -
Comprobar el estado: vuelve a ejecutar hasta que informe
DONE. -
Obtener el resultado: ejecuta solo una vez que el estado sea
DONE.
La siguiente celda de reconexión contiene un marcador de posición. Reemplázalo con tu propio job_id:
# Reconnect to a previously submitted job by its ID. Only needed in a NEW kernel
# session; if you are still in the session where you submitted, the `job` handle
# from the preceding cell is already live, so skip this cell. Replace the ID that follows with your own.
job = serverless.get_job_by_id("<your job ID>")
# Check where the job is. Re-run this until it reports DONE before fetching the
# result in the following cell: QUEUED -> INITIALIZING -> RUNNING: OPTIMIZING_FOR_HARDWARE ->
# RUNNING: WAITING_FOR_QPU -> RUNNING: EXECUTING_QPU -> RUNNING: POST_PROCESSING
# -> DONE.
print(job.status())
DONE
# Run this only once the preceding status cell reports DONE. result() blocks until
# the job finishes, so calling it earlier just waits (possibly for hours).
result = job.result()
print(
    "AQC fidelities:",
    {k: round(v, 4) for k, v in result["metadata"]["aqc_fidelities"].items()},
)

ev = np.array(result["expectation_values"])
Gjjc = ev[1:]  # drop the t = 0 row -> shape (time_steps, n)
AQC fidelities: {'1': 1.0, '2': 0.9994, '3': 0.9944, '4': 0.9853, '5': 0.9747, '6': 0.959, '7': 0.9495, '8': 0.9542, '9': 0.9533, '10': 0.9451}
Paso 4: Posprocesar y devolver el resultado en el formato clásico deseado
Posprocesamiento idéntico a la ejecución del simulador: transforma mediante Fourier la función de Green en , simetriza en espejo y recorta los valores negativos. Con la cadena y evolución más largas, el continuo de dos espinones se resuelve mucho mejor. Debería llenar la banda entre los límites discontinuos, más brillante cerca de .
n = result["metadata"]["n"]
q_res, w_res = 100, 100
spectrum = get_spectrum(n, Gjjc, dt, time_steps, q_res, w_res)
spectrum = -(spectrum + spectrum[:, ::-1]) / 2  # mirror symmetry
spectrum = np.clip(spectrum, a_min=0, a_max=None)  # clip negatives

plot_green(
    n,
    Gjjc,
    time_steps,
    dt,
    title=f"Retarded Green's function - {n} qubits (AQC, hardware)",
)
plot_spectrum(
    spectrum,
    dt,
    q_res,
    w_res,
    lower_bound=True,
    upper_bound=True,
    title=f"Dynamical structure factor - {n} qubits (AQC, hardware)",
)
Apéndice
El ejemplo de hardware anterior ejecuta una única longitud de cadena. Los tres espectros que siguen provienen de ejecuciones de hardware anteriores de este mismo flujo de trabajo en ibm_pittsburgh con 10, 20 y 30 sitios, con todas las demás entradas fijas: 20 pasos de Trotter con dt = 0.6, el plan de compresión de seis pasos comprimidos con AQC de una capa más cuatro de dos capas, y max_bond = 128. Estos son resultados registrados, no salida de las celdas anteriores.
Se usan los mismos ajustes en los tres tamaños, así que los espectros son directamente comparables. Ajustarlos por longitud de cadena, con más capas del ansatz del estado fundamental o un max_bond mayor, por ejemplo, puede dar mejores resultados que los mostrados aquí.
Próximos pasos
-
Adapta este flujo de trabajo a tu propio sistema: la función acepta cualquier
SparsePauliOp1D de vecinos más cercanos, así que un hamiltoniano de cadena, estado inicial u observables diferentes ejecutan el mismo pipeline PRE → FUNCTION → POST. Consulta el contrato completo de entrada/salida en AQC Dynamics Template en GitHub. -
Lee el artículo del que proviene este benchmark: Lee et al., Benchmarking quantum simulation with neutron-scattering experiments (arXiv:2603.15608).
-
Compara con el tutorial original "Simular la dispersión de neutrones", el flujo de trabajo en línea que este porta a una plantilla de función desplegada.
-
Profundiza en las técnicas de mitigación y supresión de errores aplicadas en la ejecución de hardware: desacoplamiento dinámico, twirling de Pauli y TREX.