Gestión del rendimiento: una función de Qiskit de Q-CTRL Fire Opal
Consulta la referencia de la API
Qiskit Functions son una funcionalidad experimental disponible únicamente para los usuarios de los planes IBM Quantum® Premium, Flex y On-Prem (a través de la API de IBM Quantum Platform). Se encuentran en estado de versión preliminar y están sujetas a cambios.
Package versions
El código de esta página se desarrolló utilizando los siguientes requisitos. Te recomendamos usar estas versiones o más recientes.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Descripción general
Fire Opal Performance Management hace que sea sencillo para cualquier persona obtener resultados significativos de las computadoras cuánticas a escala sin necesidad de ser experto en hardware cuántico. Al ejecutar circuitos con Fire Opal Performance Management, se aplican automáticamente técnicas de supresión de errores basadas en inteligencia artificial, lo que permite escalar problemas más grandes con más puertas y qubits. Este enfoque reduce la cantidad de shots necesarios para obtener la respuesta correcta, sin sobrecarga adicional, lo que resulta en un ahorro significativo tanto en tiempo de cómputo como en costos.
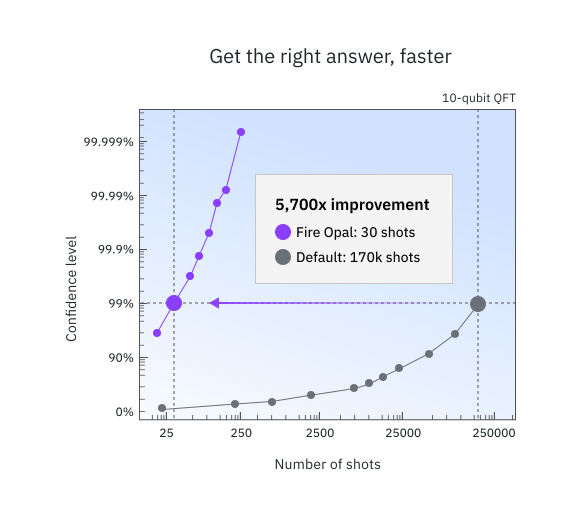
Performance Management suprime los errores y aumenta la probabilidad de obtener la respuesta correcta en hardware con ruido. En otras palabras, aumenta la relación señal-ruido. La siguiente imagen muestra cómo la mayor precisión habilitada por Performance Management puede reducir la necesidad de shots adicionales en el caso de un algoritmo de Transformada de Fourier Cuántica de 10 qubits. Con solo 30 shots, Q-CTRL alcanza el umbral de confianza del 99 %, mientras que el método predeterminado (QiskitRuntime Sampler, optimization_level=3 y resilience_level=1, ibm_sherbrooke) requiere 170 000 shots. Al obtener la respuesta correcta más rápido, ahorras un tiempo de cómputo significativo.
La función Performance Management se puede usar con cualquier algoritmo, y puedes utilizarla fácilmente en lugar de las primitivas estándar de IBM Quantum. Internamente, múltiples técnicas de supresión de errores trabajan juntas para evitar que los errores ocurran en tiempo de ejecución. Todos los métodos del pipeline de Fire Opal están preconfigurados y son agnósticos al algoritmo, lo que significa que siempre obtienes el mejor rendimiento desde el primer momento.
Para obtener acceso a Performance Management, contacta a Q-CTRL.
Descripción
Fire Opal Performance Management ofrece dos opciones de ejecución similares a las primitivas de IBM Quantum, por lo que puedes intercambiarlas fácilmente con el Sampler y el Estimator de Q-CTRL. El flujo de trabajo general para usar la función Performance Management es:
- Define tu circuito (y operadores en el caso del Estimator).
- Ejecuta el circuito.
- Recupera los resultados.
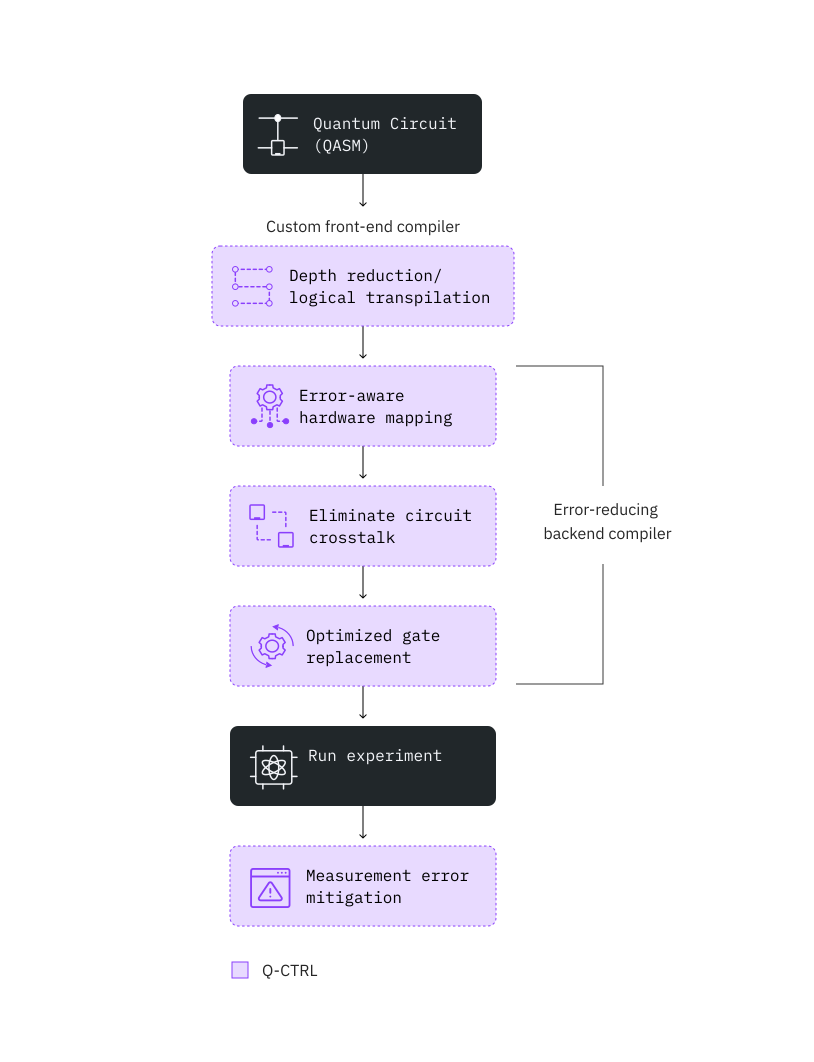
Para reducir el ruido del hardware, Fire Opal emplea una serie de técnicas de supresión de errores basadas en inteligencia artificial que se muestran en la siguiente imagen. Con Fire Opal, todo el pipeline está completamente automatizado sin necesidad de ninguna configuración.
El pipeline de Fire Opal elimina la necesidad de sobrecargas adicionales, como un mayor tiempo de ejecución cuántica o qubits físicos adicionales. Cabe señalar que el tiempo de procesamiento clásico sigue siendo un factor (consulta la sección de Benchmarks para obtener estimaciones, donde "Tiempo total" refleja el procesamiento tanto clásico como cuántico). A diferencia de la mitigación de errores, que requiere sobrecarga en forma de muestreo, la supresión de errores de Fire Opal funciona tanto a nivel de puertas como de pulsos para abordar diversas fuentes de ruido y prevenir la probabilidad de que ocurra un error. Al prevenir los errores, se elimina la necesidad de un posprocesamiento costoso.
La siguiente imagen muestra los métodos de supresión de errores automatizados por Fire Opal Performance Management.
La función ofrece dos primitivas, Sampler y Estimator, y las entradas y salidas de ambas extienden la especificación implementada para las primitivas V2 de IBM Quantum.
Benchmarks
Los resultados de benchmarking algorítmico publicados demuestran una mejora significativa del rendimiento en diversos algoritmos, incluidos Bernstein-Vazirani, la transformada de Fourier cuántica, la búsqueda de Grover, el algoritmo de optimización aproximada cuántica y el estimador variacional de valores propios cuánticos. El resto de esta sección ofrece más detalles sobre los tipos de algoritmos que puedes ejecutar, así como el rendimiento y los tiempos de ejecución esperados.
Los siguientes estudios independientes demuestran cómo el Performance Management de Q-CTRL permite la investigación algorítmica a escala sin precedentes:
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis - aprendizaje de kernels cuánticos de hasta 50 qubits
- Tensor-based quantum phase difference estimation for large-scale demonstration - estimación de fase cuántica de hasta 33 qubits
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits - carga de datos cuánticos de hasta 21 qubits
La siguiente tabla ofrece una guía aproximada sobre la precisión y los tiempos de ejecución de benchmarks previos realizados en ibm_fez. El rendimiento en otros dispositivos puede variar. El tiempo de uso se basa en un supuesto de 10 000 shots por circuito. El "Número de qubits" indicado no es un límite estricto, sino que representa umbrales aproximados donde puedes esperar una precisión de solución extremadamente consistente. Se han resuelto con éxito problemas de mayor tamaño, y se recomienda probar más allá de estos límites.
| Ejemplo | Número de qubits | Precisión | Medida de precisión | Tiempo total (s) | Uso de runtime (s) | Primitiva (Modo) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100% | Tasa de éxito (porcentaje de ejecuciones donde la respuesta correcta es la cadena de bits con mayor conteo) | 10 | 8 | Sampler |
| Transformada de Fourier Cuántica | 30Q | 100% | Tasa de éxito (porcentaje de ejecuciones donde la respuesta correcta es la cadena de bits con mayor conteo) | 10 | 8 | Sampler |
| Estimación de Fase Cuántica | 30Q | 99.9998% | Precisión del ángulo encontrado: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| Simulación cuántica: modelo de Ising (15 pasos) | 20Q | 99.775% | (definido a continuación) | 60 (por paso) | 15 (por paso) | Estimator |
| Simulación cuántica 2: dinámica molecular (20 puntos temporales) | 34Q | 96.78% | (definido a continuación) | 10 (por punto temporal) | 6 (por punto temporal) | Estimator |
Definiendo la precisión de la medición de un valor esperado, la métrica se define de la siguiente manera:
donde = valor esperado ideal, = valor esperado medido, = valor máximo ideal, y = valor mínimo ideal. es simplemente el promedio del valor de a través de múltiples mediciones.
Esta métrica se utiliza porque es invariante a desplazamientos globales y escalados en el rango de valores alcanzables. En otras palabras, independientemente de si desplazas el rango de posibles valores esperados hacia arriba o hacia abajo, o aumentas la dispersión, el valor de debe permanecer consistente.
Primeros pasos
Fire Opal Performance Management utiliza Qiskit v2.0.0, que es la versión recomendada. Las versiones compatibles son Qiskit >=v2.0.0.
Autentícate usando tu clave API de IBM Quantum Platform y selecciona la función de Qiskit de la siguiente manera. (Este fragmento asume que ya has guardado tu cuenta en tu entorno local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
Si quieres usar un backend que esta función no admite actualmente, contacta a Q-CTRL para agregar compatibilidad.
Primitiva Estimator
Ejemplo de Estimator
Usa la primitiva Estimator de Fire Opal Performance Management para determinar el valor esperado de un par circuito-observable.
Además de los paquetes qiskit-ibm-catalog y qiskit, también usarás el paquete numpy para ejecutar este ejemplo. Puedes instalar este paquete descomentando la siguiente celda si estás ejecutando este ejemplo en un notebook con el kernel de IPython.
# %pip install numpy
1. Crear el circuito
Como ejemplo, genera un operador hermitiano aleatorio y un observable para introducir en la función Performance Management.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. Ejecutar el circuito
Ejecuta el circuito y, de manera opcional, define el backend y el número de shots.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Puedes usar las conocidas APIs de Qiskit Serverless para comprobar el estado de tu carga de trabajo de la función de Qiskit:
qctrl_estimator_job.status()
'QUEUED'
3. Recuperar el resultado
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
Los resultados tienen el mismo formato que un resultado de Estimator:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Primitiva Sampler
Ejemplo de Sampler
Usa la primitiva Sampler de Fire Opal Performance Management para ejecutar un circuito de Bernstein–Vazirani. Este algoritmo, utilizado para encontrar una cadena oculta a partir de las salidas de una función de caja negra, es un algoritmo de benchmarking común porque tiene una única respuesta correcta. 1. Crear el circuito
Define la respuesta correcta al algoritmo, la cadena de bits oculta, y el circuito de Bernstein–Vazirani. Puedes ajustar el ancho del circuito simplemente cambiando circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Ejecutar el circuito
Ejecuta el circuito y, de manera opcional, define el backend y el número de shots.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Comprueba el estado de tu carga de trabajo de la función de Qiskit o recupera los resultados de la siguiente manera:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Recuperar el resultado
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. Graficar las principales cadenas de bits
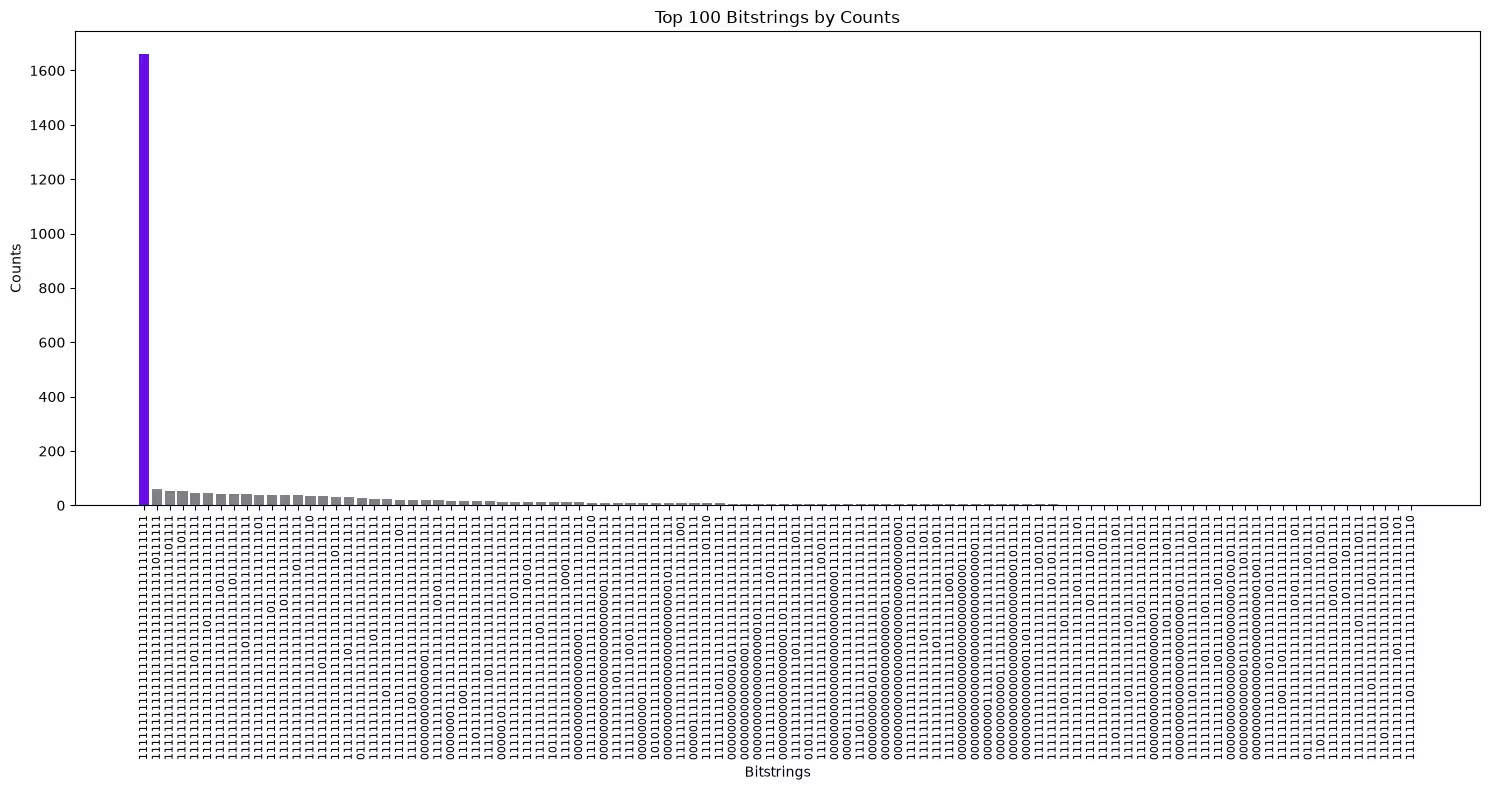
Grafica la cadena de bits con el mayor número de conteos para ver si la cadena de bits oculta fue la moda.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
La cadena de bits oculta aparece destacada en morado y debería ser la cadena de bits con el mayor número de conteos.
plot_top_bitstrings(counts, hidden_bitstring)
Registro de cambios
-
2026-02-20: Aviso de obsolescencia: el campo de metadatos
provider_job_idsquedará obsoleto en 30 días en la versión 0.13.0. Los usuarios pueden acceder al ID de trabajo a través del métodojob_id()del servicio de runtime. -
2026-02-11: Ahora tenemos soporte para
ibm_miamiy se agregaron metadatos de ejecución alPubResult.
Obtener soporte
Para cualquier pregunta o problema, contacta a Q-CTRL.
Próximos pasos
-
Solicita acceso a Q-CTRL Performance Management.
-
Visita la referencia de la API para esta función de Qiskit.
-
Prueba el tutorial Modelo de Ising de campo transversal con Performance Management de Q-CTRL.
-
Prueba el tutorial Estimación de Fase Cuántica con Qiskit Functions de Q-CTRL
-
Consulta el caso de estudio de Mitsubishi Chemical Corp.
-
Consulta el caso de estudio del banco no divulgado.
-
Consulta el caso de estudio de BlueQubit.