QESEM: Una Qiskit Function de Qedma
Consulta la referencia de la API
Versiones de los paquetes
El código de esta página se desarrolló usando los siguientes requisitos. Recomendamos usar estas versiones o más recientes.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
Las Qiskit Functions son una funcionalidad experimental disponible únicamente para usuarios de los planes IBM Quantum® Premium, Flex y On-Prem (a través de la API de IBM Quantum Platform). Se encuentran en estado de versión preliminar y están sujetas a cambios.
Descripción general
Si bien las unidades de procesamiento cuántico han mejorado enormemente en los últimos años, los errores debidos al ruido y las imperfecciones del hardware existente siguen siendo un desafío central para los desarrolladores de algoritmos cuánticos. A medida que el campo se acerca a computaciones cuánticas a escala utilitaria que no pueden verificarse de forma clásica, las soluciones para cancelar el ruido con precisión garantizada adquieren cada vez más importancia. Para superar este desafío, Qedma ha desarrollado Quantum Error Mitigation (QESEM), integrado de forma transparente en IBM Quantum Platform como una Qiskit Function.
Con QESEM, los usuarios pueden ejecutar sus circuitos cuánticos en QPUs ruidosas para obtener resultados altamente precisos y libres de errores con sobrecargas de tiempo de QPU muy eficientes, cercanas a los límites fundamentales. Para lograrlo, QESEM aprovecha un conjunto de métodos propietarios desarrollados por Qedma para la caracterización y reducción de errores. Las técnicas de reducción de errores incluyen optimización de puertas, transpilación consciente del ruido, supresión de errores (ES) y mitigación de errores insesgada (EM). Con esta combinación de métodos basados en caracterización, los usuarios pueden obtener resultados confiables y libres de errores para circuitos cuánticos genéricos de gran volumen, desbloqueando aplicaciones que de otro modo no podrían realizarse.
Para una descripción completa de los componentes subyacentes, así como una demostración a escala utilitaria, consulta el artículo Reliable high-accuracy error mitigation for utility-scale quantum circuits.
Descripción
Puedes usar la función QESEM de Qedma para estimar y ejecutar fácilmente tus circuitos con supresión y mitigación de errores, logrando mayores volúmenes de circuito y mayor precisión. Para usar QESEM, debes proporcionar un circuito cuántico, un conjunto de observables a medir, una precisión estadística objetivo para cada observable y una QPU seleccionada. Antes de ejecutar el circuito con la precisión objetivo, puedes estimar el tiempo de QPU necesario basándote en un cálculo analítico que no requiere ejecución del circuito. Una vez que estés satisfecho con la estimación de tiempo de QPU, puedes ejecutar el circuito con QESEM.
Cuando ejecutas un circuito, QESEM ejecuta un protocolo de caracterización del dispositivo adaptado a tu circuito, produciendo un modelo de ruido confiable para los errores que ocurren en él. A partir de la caracterización, QESEM primero implementa transpilación consciente del ruido para mapear el circuito de entrada a un conjunto de qubits físicos y puertas, minimizando el ruido que afecta al observable objetivo. Esto incluye las puertas disponibles de forma nativa (CX/CZ en dispositivos IBM®), así como puertas adicionales optimizadas por QESEM, formando el conjunto de puertas extendido de QESEM. Luego, QESEM ejecuta un conjunto de circuitos ES y EM basados en caracterización en la QPU y recopila los resultados de sus mediciones. Estos se procesan clásicamente para proporcionar un valor esperado insesgado y una barra de error para cada observable, correspondiente a la precisión solicitada.
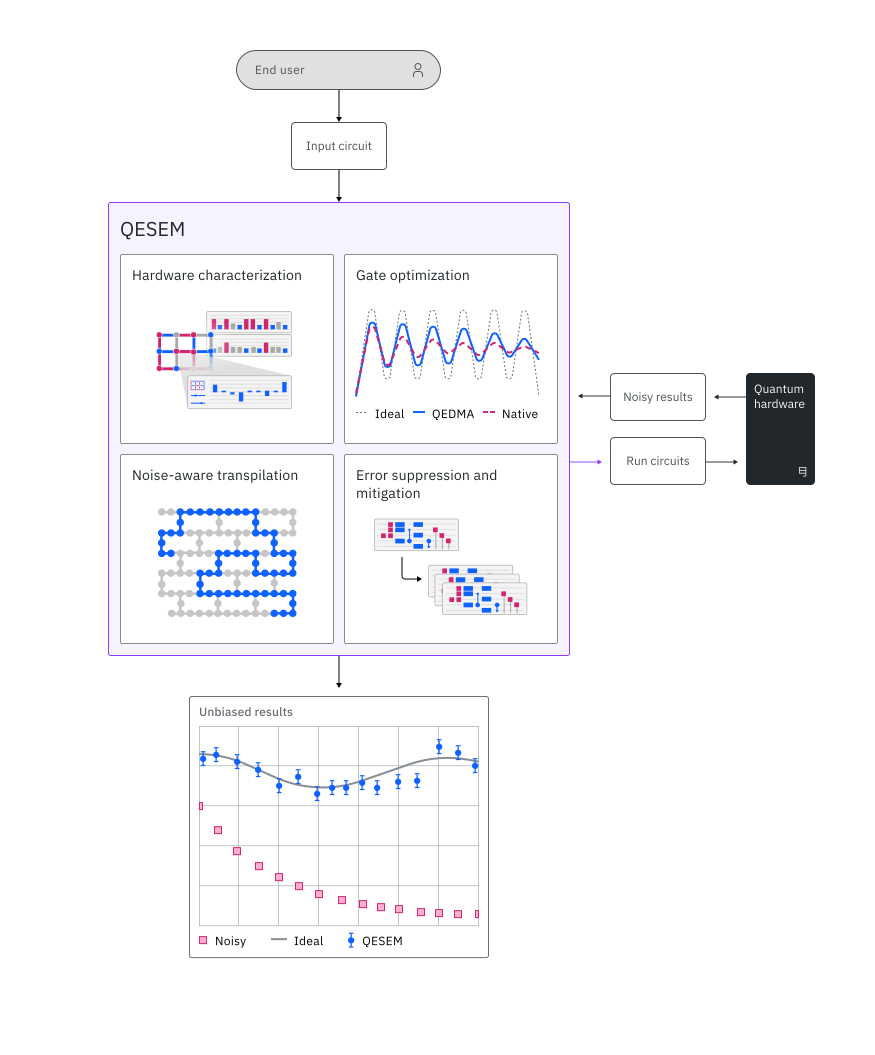 Se ha demostrado que QESEM proporciona resultados de alta precisión para una variedad de aplicaciones cuánticas y en los mayores volúmenes de circuito alcanzables hoy en día. QESEM ofrece las siguientes características para el usuario, demostradas en la sección de benchmarks a continuación:
- Precisión garantizada: QESEM genera estimaciones imparciales de los valores de expectación de los observables. Su método EM está equipado con garantías teóricas que, junto con la caracterización de vanguardia de Qedma, aseguran que la mitigación converge a la salida del circuito sin ruido hasta la precisión especificada por el usuario. A diferencia de muchos métodos EM heurísticos propensos a errores sistemáticos o sesgos, la precisión garantizada de QESEM es esencial para asegurar resultados confiables en circuitos cuánticos y observables genéricos.
- Escalabilidad a QPUs grandes: El tiempo de QPU de QESEM depende del volumen del circuito, pero en lo demás es independiente del número de qubits. Qedma ha demostrado QESEM en los dispositivos cuánticos más grandes disponibles hoy, incluidos los dispositivos IBM Quantum Eagle de 127 qubits y Heron de 133 qubits.
- Agnóstico a la aplicación: QESEM se ha demostrado en una variedad de aplicaciones, incluyendo simulación hamiltoniana, VQE, QAOA y estimación de amplitud. Los usuarios pueden ingresar cualquier circuito cuántico y observable a medir, y obtener resultados precisos y libres de errores. Las únicas limitaciones las dictan las especificaciones del hardware y el tiempo de QPU asignado, que determinan los volúmenes de circuito accesibles y las precisiones de salida. En contraste, muchas soluciones de reducción de errores son específicas de la aplicación o involucran heurísticas no controladas, lo que las hace inaplicables para circuitos y aplicaciones cuánticos genéricos.
- Conjunto de puertas extendido: QESEM soporta puertas de ángulo fraccionario y proporciona puertas de ángulo fraccionario optimizadas por Qedma en dispositivos IBM Quantum Heron y Eagle. Este conjunto de puertas extendido permite una compilación más eficiente y desbloquea volúmenes de circuito mayores por un factor de hasta 2 en comparación con la compilación predeterminada de CX/CZ.
- Observables multibase: QESEM soporta observables de entrada compuestos de muchas cadenas de Pauli no conmutantes, como Hamiltonianos genéricos. La elección de las bases de medición y la optimización de la asignación de recursos de QPU (shots y circuitos) se realiza automáticamente por QESEM para minimizar el tiempo de QPU requerido para la precisión solicitada. Esta optimización, que tiene en cuenta las fidelidades del hardware y las tasas de ejecución, te permite ejecutar circuitos más profundos y obtener mayor precisión.
Benchmarks
QESEM ha sido probado en una amplia variedad de casos de uso y aplicaciones. Los siguientes ejemplos pueden ayudarte a evaluar qué tipos de cargas de trabajo puedes ejecutar con QESEM.
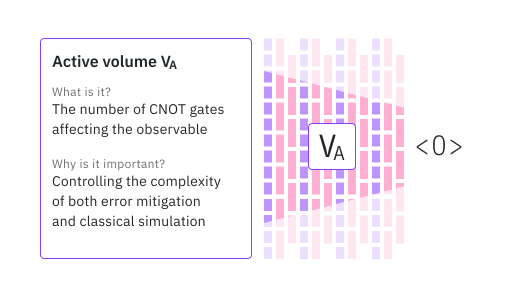
Una figura de mérito clave para cuantificar la dificultad tanto de la mitigación de errores como de la simulación clásica para un circuito y observable dado es el volumen activo: el número de puertas CNOT que afectan al observable en el circuito. El volumen activo depende de la profundidad y el ancho del circuito, del peso del observable y de la estructura del circuito, que determina el cono de luz del observable. Para más detalles, consulta la charla del IBM Quantum Summit 2024. QESEM proporciona un valor particularmente grande en el régimen de alto volumen, ofreciendo resultados confiables para circuitos y observables genéricos.
| Aplicación | Número de qubits | Dispositivo | Descripción del circuito | Precisión | Tiempo total | Uso de runtime |
|---|---|---|---|---|---|---|
| Circuito VQE | 8 | Eagle (r3) | 21 capas totales, 9 bases de medición, cadena 1D | 98% | 35 min | 14 min |
| Kicked Ising | 28 | Eagle (r3) | 3 capas únicas x 3 pasos, topología heavy-hex 2D | 97% | 22 min | 4 min |
| Kicked Ising | 28 | Eagle (r3) | 3 capas únicas x 8 pasos, topología heavy-hex 2D | 97% | 116 min | 23 min |
| Simulación hamiltoniana Trotterizada | 40 | Eagle (r3) | 2 capas únicas x 10 pasos de Trotter, cadena 1D | 97% | 3 horas | 25 min |
| Simulación hamiltoniana Trotterizada | 119 | Eagle (r3) | 3 capas únicas x 9 pasos de Trotter, topología heavy-hex 2D | 95% | 6,5 horas | 45 min |
| Kicked Ising | 136 | Heron (r2) | 3 capas únicas x 15 pasos, topología heavy-hex 2D | 99% | 52 min | 9 min |
La precisión se mide aquí en relación con el valor ideal del observable: , donde '' es la precisión absoluta de la mitigación (establecida por el usuario), y es el observable del circuito sin ruido. El «uso de runtime» mide el uso del benchmark en batch mode (suma sobre el uso de los trabajos individuales), mientras que el «tiempo total» mide el uso en session mode (tiempo de pared del experimento), que incluye tiempos adicionales de comunicación y procesamiento clásico. QESEM está disponible para ejecución en ambos modos, de modo que los usuarios puedan aprovechar al máximo sus recursos disponibles.
Los circuitos Kicked Ising de 28 qubits simulan el Cristal de Tiempo Discreto estudiado por Shinjo et al. (ver arXiv 2403.16718 y Q2B24 Tokyo) en tres bucles conectados de ibm_kawasaki. Los parámetros del circuito tomados aquí son , con un estado inicial ferromagnético . El observable medido es el valor absoluto de la magnetización . El experimento Kicked Ising a escala utilitaria se ejecutó en los 136 mejores qubits de ibm_fez; este benchmark particular se ejecutó al ángulo de Clifford , en el que el volumen activo crece lentamente con la profundidad del circuito, lo que, junto con las altas fidelidades del dispositivo, permite alta precisión en un tiempo de ejecución corto.
Los circuitos de simulación hamiltoniana Trotterizada corresponden a un modelo de Ising de campo transverso con ángulos fraccionarios: y respectivamente (ver Q2B24 Tokyo). El circuito a escala utilitaria se ejecutó en los 119 mejores qubits de ibm_brisbane, mientras que el experimento de 40 qubits se ejecutó en la mejor cadena disponible. La precisión se reporta para la magnetización; también se obtuvieron resultados de alta precisión para observables de mayor peso.
El circuito VQE fue desarrollado junto con investigadores del Center for Quantum Technology and Applications del Deutsches Elektronen-Synchrotron (DESY). El observable objetivo aquí fue un Hamiltoniano compuesto por un gran número de cadenas de Pauli no conmutantes, destacando el rendimiento optimizado de QESEM para observables multibases. La mitigación se aplicó a un ansatz optimizado clásicamente; aunque estos resultados aún no están publicados, se obtendrán resultados de la misma calidad para diferentes circuitos con propiedades estructurales similares.
Comenzar
Autentícate usando tu clave de API de IBM Quantum Platform, y selecciona la Qiskit Function QESEM de la siguiente manera. (Este fragmento asume que ya has guardado tu cuenta en tu entorno local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
Ejemplos
Ejemplo de job de estimación de tiempo
El job de estimación de tiempo es útil para estimar el tiempo de QPU requerido para un pub y backend_name dados. backend_name también puede establecerse en cualquier backend simulador; por ejemplo, fake_fez.
QESEM usa un método de mitigación de errores cuasi-probabilístico basado en caracterización. Este método tiene una sobrecarga de tiempo de QPU que escala aproximadamente como:
Donde es el volumen activo del circuito, es la precisión objetivo, y es la infidelidad de las puertas nativas.
Ten en cuenta que "estimate_time_only": "empirical" usa unos pocos minutos de tiempo de QPU para estimar el tiempo requerido para el job (si el backend es un dispositivo real; si es un simulador, entonces no se usa tiempo de QPU). Esto normalmente tarda alrededor de 5 minutos, pero no más de 10 minutos. Si la infidelidad cambia drásticamente entre el job de estimación de tiempo empírico y el job de mitigación, el tiempo de QPU también cambiará drásticamente.
Para comenzar, prueba este ejemplo básico de estimación del tiempo de QPU necesario para ejecutar QESEM con un pub dado:
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
El siguiente fragmento de código describe cómo recuperar diferentes métricas de ejecución del job de estimación de tiempo (cuando estimate_time_only está establecido):
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Cuando la estimación de tiempo empírica está habilitada, QESEM ejecuta una pequeña cantidad de circuitos para proporcionar una estimación de tiempo de QPU más precisa. Los resultados de mitigación de estos circuitos están disponibles en el campo empirical_estimation_mitigation_results del job.
Dado que estos resultados se derivan de una muestra limitada de circuitos, son significativamente menos precisos que los resultados finales obtenidos del job completo de mitigación QESEM. Sin embargo, cuando el circuito es pequeño o la precisión objetivo es baja, la mitigación realizada durante la estimación de tiempo empírica puede ser suficiente para alcanzar la precisión deseada, y el job completo de mitigación puede no ser necesario.
El campo empirical_estimation_mitigation_results es una lista de objetos PrimitiveResult por parámetro de entrada. Si el circuito no está parametrizado, la lista tendrá una longitud de 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
Ejemplo de job de mitigación QESEM
El siguiente ejemplo ejecuta un job de QESEM:
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
Para una descripción detallada de cada campo de entrada y opción, consulta la referencia de la API de QESEM. Puedes usar las APIs familiares de Qiskit Serverless para verificar el estado de tu carga de trabajo de Qiskit Function o recuperar los resultados:
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
El siguiente fragmento de código demuestra cómo recuperar los resultados de mitigación y las métricas de ejecución. Estos contienen datos esenciales que permiten una comprensión más profunda de cómo los diferentes parámetros impactan la ejecución de QESEM. También puede ser relevante al escribir un artículo basado en tu investigación.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
En metadata["results"], los resultados se agrupan primero por instancia de circuito y luego por observable.
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
Desglose de resultados principales:
mitigated: el valor esperado de QESEM completamente mitigado.unmitigated: el resultado bruto de ruido físico sin mitigación de errores.
Resultados de extrapolación heurística de QESEM
En una ejecución estándar de QESEM con un único float de precision, los resultados también incluyen puntos de escalado de ruido disponibles automáticamente que se usan para la heurística de QESEM. Estos puntos se calculan sin recursos adicionales de QPU.
La escala 1.0 representa el nivel de ruido del dispositivo físico con mitigación de lectura (REM), mientras que la escala 2.0 es el punto complementario amplificado en ruido, también con REM. Estos puntos se usan para producir el resultado qesem_heuristic.
-
qesem_heuristic: una estimación de estilo ZNE calculada a partir de los datos disponibles con escalado de ruido. Actualmente, esto usa extrapolación exponencial. -
noise_scaling.results_with_REM: valores esperados en diferentes escalas de ruido, todos con mitigación de lectura (REM).
Un detalle sutil pero importante es que el resultado de la escala 1.0 no es lo mismo que el resultado unmitigated. Ambos corresponden al nivel de ruido del dispositivo físico, pero el punto de escala 1.0 incluye mitigación de lectura, mientras que unmitigated no.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
Los siguientes ejemplos se centran en las entradas y los resultados específicos de cada función, por lo que no imprimen las métricas de ejecución completas cada vez. Los metadatos de nivel superior mostrados anteriormente, como total_qpu_time, gate_fidelities, total_shots, mitigation_shots, y resource_usage, también están disponibles para estos trabajos.
Algunas variables de los ejemplos anteriores, incluyendo el backend, los observables y los parámetros del circuito base, se reutilizan a continuación por concisión.
Todos los siguientes ejemplos también se pueden ejecutar con estimación de tiempo empírica. Para habilitarla, pasa "estimate_time_only": "empirical" en las opciones de la función.
Ejemplo de circuito parametrizado
Muchos algoritmos evalúan el mismo circuito en varios valores de parámetros. Enviar el circuito parametrizado como un solo job de QESEM permite que QESEM comparta la caracterización y la calibración entre las instancias del circuito, lo que puede reducir la sobrecarga de tiempo de QPU en comparación con ejecutar jobs separados.
Enviar un circuito parametrizado requiere usar el nivel de transpilación "minimal_with_layout_opt".
Los circuitos enviados en este nivel ya deben estar expresados usando las puertas base del backend, dependiendo del backend. En este nivel, QESEM mantiene la estructura enviada lo más cercana posible al circuito de entrada, respeta las barreras durante la layerification (agrupando operaciones en capas de puertas de dos qubits paralelas), y aún maneja automáticamente el mapeo de hardware a qubits de alta fidelidad y la conectividad del dispositivo.
En la práctica, esto significa que debes transpilar los circuitos a las puertas base del backend objetivo antes de enviarlos. A continuación se muestra un ejemplo simple de transpilación de puertas base.
QESEM actualmente admite solo un observable por conjunto de parámetros. Las dos filas de parámetros de abajo se combinan (zip) con los dos observables: la primera fila se mide con avg_magnetization, y la segunda fila se mide con other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
Ejemplo multi-pub
La ejecución multi-pub es útil cuando quieres ejecutar varios circuitos relacionados en un solo job de QESEM. Al igual que la ejecución parametrizada, esto puede reducir la sobrecarga porque QESEM puede compartir la caracterización y la calibración entre las instancias del circuito en lugar de repetirla en jobs separados.
Esto es especialmente útil para circuitos con una estructura de capas compartida, como las cargas de trabajo de tipo Trotter, donde diferentes circuitos reutilizan las mismas capas únicas. En ese caso, ejecutarlos juntos puede reducir el costo de caracterización en comparación con jobs de QESEM independientes.
Los jobs multi-pub requieren "transpilation_level": "minimal_with_layout_opt". Al igual que en el ejemplo parametrizado, los circuitos deben transpilarse a las puertas base del backend objetivo antes de enviarlos. QESEM luego maneja internamente la conectividad del dispositivo, el layout y el mapeo a qubits de alta fidelidad.
Cada PUB de abajo contiene un circuito y los mismos dos observables usados anteriormente en el notebook, por lo que el PrimitiveResult devuelto contiene un PubResult por circuito de entrada.
El ejemplo de abajo usa dos circuitos Trotter simples con el mismo patrón de capas: circ_a tiene una capa Trotter, y circ_b repite el mismo patrón de capas dos veces. Esto hace explícita la estructura compartida.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
Ejemplo de Ajuste de Error Cuasi-probabilístico (QET)
El Ajuste de Error Cuasi-probabilístico (QET) solicita valores esperados en factores de escalado de ruido seleccionados. Esto es útil para estudios personalizados de escalado de ruido y flujos de trabajo de Extrapolación a Ruido Cero. La escala 1.0 es el nivel de ruido físico, los valores entre 0.0 y 1.0 reducen parcialmente el ruido, y los valores por encima de 1.0 amplifican el ruido.
Para usar QET con la Qiskit Function, pasa un diccionario como precisión del PUB. El diccionario asigna cada escala de ruido solicitada a su precisión objetivo. Los resultados de factor de escala devueltos se almacenan en noise_scaling.results_with_REM e incluyen mitigación de lectura. Por lo tanto, el punto de escala 1.0 no es idéntico al valor no mitigado, porque 1.0 incluye mitigación de lectura mientras que unmitigated no.
Cuando se solicita una escala, QESEM también devuelve la escala complementaria alrededor de 1.0 sin uso adicional de QPU. Por ejemplo, solicitar 0.5 también puede devolver 1.5, y solicitar 1.3 también puede devolver 0.7. No se garantiza la precisión en la escala complementaria.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
Obtener mensajes de error
Si el estado de tu carga de trabajo es ERROR, usa job.result() para recuperar el mensaje de error de la siguiente manera:
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
Obtener soporte
¡El equipo de soporte de Qedma está aquí para ayudarte! Si encuentras algún problema o tienes preguntas sobre el uso de la Qiskit Function QESEM, no dudes en comunicarte con nosotros. Nuestro personal de soporte, competente y amable, está listo para asistirte con cualquier inquietud técnica o consulta que puedas tener.
Puedes enviarnos un correo electrónico a support@qedma.com para recibir asistencia. Por favor, incluye la mayor cantidad de detalles posible sobre el problema que estás experimentando para ayudarnos a proporcionar una respuesta rápida y precisa. También puedes contactar a tu representante POC dedicado de Qedma por correo electrónico o teléfono.
Para ayudarnos a asistirte de manera más eficiente, por favor proporciona la siguiente información cuando te comuniques con nosotros:
-
Una descripción detallada del problema
-
El ID del job
-
Cualquier mensaje o código de error relevante
Estamos comprometidos a brindarte soporte rápido y efectivo para garantizar que tengas la mejor experiencia posible con nuestra Qiskit Function.
¡Siempre buscamos mejorar nuestro producto y damos la bienvenida a tus sugerencias! Si tienes ideas sobre cómo podemos mejorar nuestros servicios o características que te gustaría ver, envíanos tus pensamientos a support@qedma.com.
Próximos pasos
-
Visita la referencia de API para esta Qiskit Function.
-
Prueba el tutorial Simulate 2D tilted-field Ising with the QESEM function.