Instancias y extensiones
En este capítulo se presentan varios algoritmos variacionales cuánticos, entre ellos:
A través de estos algoritmos aprenderás varias ideas de diseño que pueden incorporarse en algoritmos variacionales personalizados, como pesos, penalizaciones, sobremuestreo y submuestreo. Te animamos a experimentar con estos conceptos y a compartir tus hallazgos con la comunidad.
El marco de patrones de Qiskit aplica a todos estos algoritmos, pero solo señalaremos los pasos explícitamente en el primer ejemplo.
Eigensolver cuántico variacional (VQE)
VQE es uno de los algoritmos variacionales cuánticos más utilizados, y establece una plantilla sobre la que se construyen otros algoritmos.
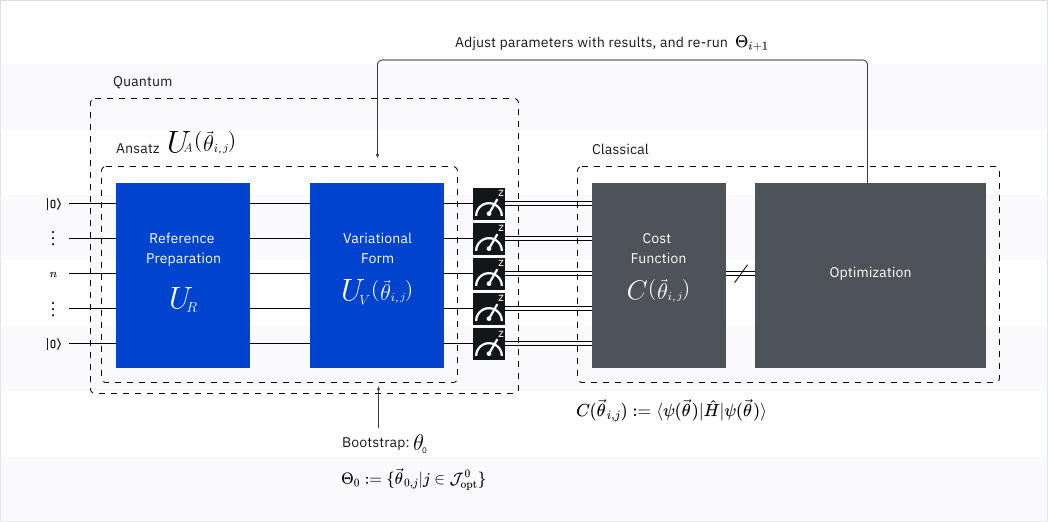
Paso 1: Mapear las entradas clásicas a un problema cuántico
Esquema teórico
El esquema de VQE es sencillo:
-
Preparar los operadores de referencia
- Partimos del estado y llegamos al estado de referencia
-
Aplicar la forma variacional para crear un ansatz
- Pasamos del estado a
-
Arranque en si tenemos un problema similar (normalmente obtenido mediante simulación clásica o muestreo)
- Cada optimizador se inicializará de forma diferente, generando un conjunto inicial de vectores de parámetros (por ejemplo, a partir de un punto inicial ).
-
Evaluar la función de coste para todos los estados preparados en un ordenador cuántico.
-
Usar un optimizador clásico para seleccionar el siguiente conjunto de parámetros .
-
Repetir el proceso hasta alcanzar la convergencia.
Este es un ciclo de optimización clásico sencillo en el que evaluamos la función de coste. Algunos optimizadores pueden requerir varias evaluaciones para calcular un gradiente, determinar la siguiente iteración o verificar la convergencia.
A continuación se muestra el ejemplo para el siguiente observable:
Implementación
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import TwoLocal
import numpy as np

theta_list = (2 * np.pi * np.random.rand(1, 8)).tolist()
observable = SparsePauliOp.from_list([("II", 2), ("XX", -2), ("YY", 3), ("ZZ", -3)])

reference_circuit = QuantumCircuit(2)
reference_circuit.x(0)

variational_form = TwoLocal(
    2,
    rotation_blocks=["rz", "ry"],
    entanglement_blocks="cx",
    entanglement="linear",
    reps=1,
)

ansatz = reference_circuit.compose(variational_form)

ansatz.decompose().draw("mpl")

def cost_func_vqe(parameters, ansatz, hamiltonian, estimator):
    """Return estimate of energy from estimator

    Parameters:
        params (ndarray): Array of ansatz parameters
        ansatz (QuantumCircuit): Parameterized ansatz circuit
        hamiltonian (SparsePauliOp): Operator representation of Hamiltonian
        estimator (Estimator): Estimator primitive instance

    Returns:
        float: Energy estimate
    """

    estimator_job = estimator.run([(ansatz, hamiltonian, [parameters])])
    estimator_result = estimator_job.result()[0]

    cost = estimator_result.data.evs[0]
    return cost
from qiskit.primitives import StatevectorEstimator

estimator = StatevectorEstimator()
Podemos usar esta función de coste para calcular los parámetros óptimos:
# SciPy minimizer routine
from scipy.optimize import minimize

x0 = np.ones(8)

result = minimize(
    cost_func_vqe, x0, args=(ansatz, observable, estimator), method="COBYLA"
)

result
message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -5.999999982445723
       x: [ 1.741e+00  9.606e-01  1.571e+00  2.115e-05  1.899e+00
            1.243e+00  6.063e-01  6.063e-01]
    nfev: 136
   maxcv: 0.0
Paso 2: Optimizar el problema para la ejecución cuántica
Seleccionaremos el backend menos ocupado e importaremos los componentes necesarios de qiskit_ibm_runtime.
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit_ibm_runtime import EstimatorV2 as Estimator
from qiskit_ibm_runtime import Session, EstimatorOptions
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)
print(backend)
<IBMBackend('ibm_brisbane')>
Transpilaremos el circuito usando el gestor de pasadas predefinido con nivel de optimización 3, y aplicaremos el diseño correspondiente al observable.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pm = generate_preset_pass_manager(backend=backend, optimization_level=3)
isa_ansatz = pm.run(ansatz)
isa_observable = observable.apply_layout(layout=isa_ansatz.layout)
Paso 3: Ejecutar usando primitivas de IBM Quantum
Ya estamos listos para ejecutar nuestro cálculo en hardware de IBM Quantum®. Dado que la minimización de la función de coste es muy iterativa, iniciaremos una sesión de Runtime. De este modo, solo tendremos que esperar en la cola una vez. Una vez que el trabajo comience a ejecutarse, cada iteración con actualizaciones de parámetros se ejecutará de inmediato.
x0 = np.ones(8)

estimator_options = EstimatorOptions(resilience_level=1, default_shots=10_000)

with Session(backend=backend) as session:
    estimator = Estimator(mode=session, options=estimator_options)

    result = minimize(
        cost_func_vqe,
        x0,
        args=(isa_ansatz, isa_observable, estimator),
        method="COBYLA",
        options={"maxiter": 200, "disp": True},
    )
session.close()
print(result)
Paso 4: Posprocesar y devolver el resultado en formato clásico
Podemos ver que la rutina de minimización terminó con éxito, lo que significa que se alcanzó la tolerancia predeterminada del optimizador clásico COBYLA. Si necesitamos un resultado más preciso, podemos especificar una tolerancia menor. Esto podría ser necesario, ya que el resultado se alejó varios puntos porcentuales del obtenido por el simulador anterior.
El valor de x obtenido es la mejor estimación actual de los parámetros que minimizan la función de coste. Si se itera para obtener mayor precisión, esos valores deben usarse en lugar del x0 inicial (un vector de unos).
Por último, cabe señalar que la función fue evaluada 96 veces durante el proceso de optimización. Este número puede diferir de la cantidad de pasos de optimización, ya que algunos optimizadores requieren múltiples evaluaciones de la función en un solo paso, como ocurre al estimar un gradiente.
VQE de búsqueda en subespacios (SSVQE)
SSVQE es una variante de VQE que permite obtener los primeros valores propios de un observable con valores propios , donde . Sin pérdida de generalidad, suponemos que . SSVQE introduce una nueva idea al añadir pesos para priorizar la optimización del término con mayor peso.
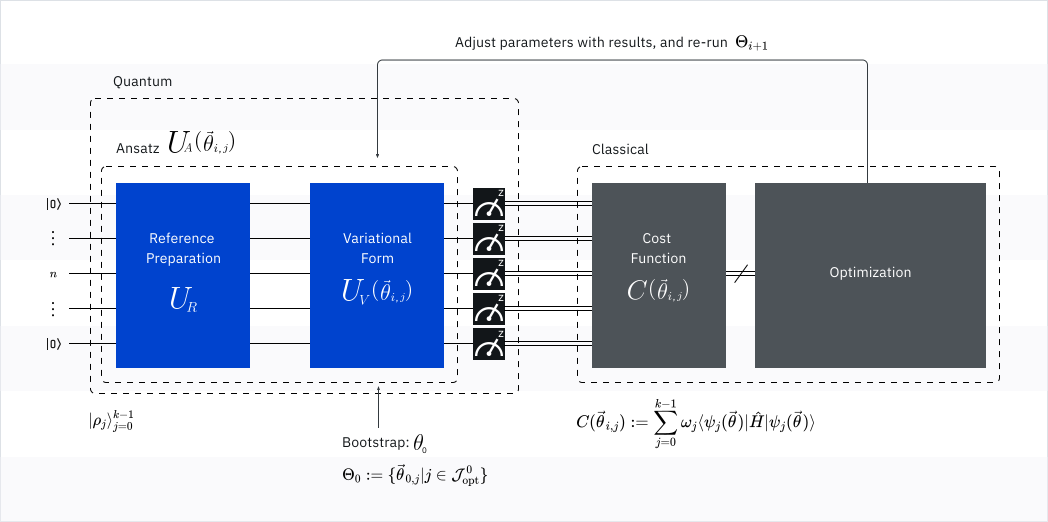
Para implementar este algoritmo, necesitamos estados de referencia mutuamente ortogonales , lo que significa que para . Estos estados pueden construirse usando operadores de Pauli. La función de coste de este algoritmo es:
donde es un número positivo arbitrario tal que si entonces , y es la forma variacional definida por el usuario.
El algoritmo SSVQE se basa en el hecho de que los estados propios correspondientes a distintos valores propios son mutuamente ortogonales. En particular, el producto interno de y puede expresarse como:
La primera igualdad es válida porque es un operador cuántico y, por tanto, unitario. La última igualdad se cumple por la ortogonalidad de los estados de referencia . El hecho de que la ortogonalidad se conserve a través de transformaciones unitarias está profundamente relacionado con el principio de conservación de la información, tal como se expresa en la ciencia de la información cuántica. Desde esta perspectiva, las transformaciones no unitarias representan procesos en los que se pierde o se inyecta información.
Los pesos ayudan a garantizar que todos los estados sean estados propios. Si los pesos son suficientemente distintos, el término con mayor peso (es decir, ) recibirá prioridad durante la optimización sobre los demás. Como resultado, el estado resultante se convertirá en el estado propio correspondiente a . Dado que son mutuamente ortogonales, los estados restantes serán ortogonales a este y, por tanto, estarán contenidos en el subespacio correspondiente a los valores propios .
Aplicando el mismo argumento al resto de los términos, la siguiente prioridad sería el término con peso , de modo que sería el estado propio correspondiente a , y los demás términos estarían contenidos en el espacio propio de .
Razonando inductivamente, deducimos que será un estado propio aproximado de para .
Esquema teórico
El algoritmo SSVQE puede resumirse de la siguiente manera:
-
Preparar varios estados de referencia aplicando un unitario U_R a estados distintos de la base computacional
- Este algoritmo requiere el uso de estados de referencia mutuamente ortogonales , de modo que para .
-
Aplicar la forma variacional a cada estado de referencia, obteniendo el siguiente ansatz .
-
Arranque en si se dispone de un problema similar (normalmente obtenido mediante simulación clásica o muestreo).
-
Evaluar la función de coste para todos los estados preparados en un ordenador cuántico.
-
Esto puede separarse en el cálculo del valor esperado de un observable y la multiplicación del resultado por .
-
A continuación, la función de coste devuelve la suma de todos los valores esperados ponderados.
-
-
Usar un optimizador clásico para determinar el siguiente conjunto de parámetros .
-
Repetir los pasos anteriores hasta alcanzar la convergencia.
Reconstruirás la función de coste de SSVQE en la evaluación, pero aquí tienes el siguiente fragmento para orientar tu solución:
import numpy as np

def cost_func_ssvqe(
    params, initialized_anastz_list, weights, ansatz, hamiltonian, estimator
):
    # """Return estimate of energy from estimator

    # Parameters:
    #     params (ndarray): Array of ansatz parameters
    #     initialized_anastz_list (list QuantumCircuit): Array of initialised ansatz with reference
    #     weights (list): List of weights
    #     ansatz (QuantumCircuit): Parameterized ansatz circuit
    #     hamiltonian (SparsePauliOp): Operator representation of Hamiltonian
    #     estimator (Estimator): Estimator primitive instance

    # Returns:
    #     float: Weighted energy estimate
    # """

    energies = []

    # Define SSVQE

    weighted_energy_sum = np.dot(energies, weights)
    return weighted_energy_sum
Deflación cuántica variacional (VQD)
VQD es un método iterativo que extiende VQE para obtener los primeros valores propios de un observable con valores propios , donde , en lugar de solo el primero. Para el resto de esta sección, asumiremos, sin pérdida de generalidad, que . VQD introduce la noción de un coste de penalización para guiar el proceso de optimización.
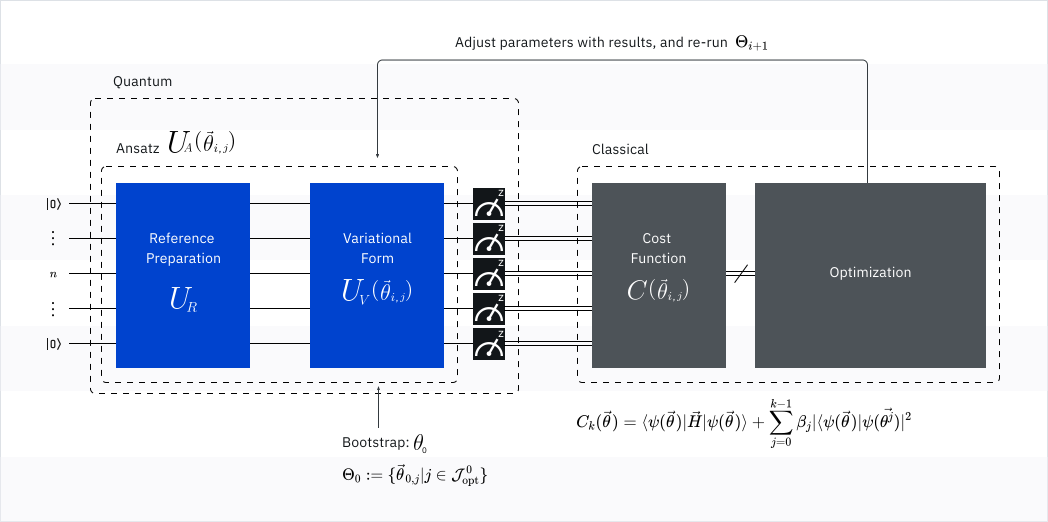 VQD introduce un término de penalización, denotado como , para equilibrar la contribución de cada término de solapamiento al coste. Este término de penalización sirve para sancionar el proceso de optimización si no se logra la ortogonalidad. Imponemos esta restricción porque los estados propios de un observable, o de un operador hermítico, correspondientes a distintos valores propios son siempre mutuamente ortogonales, o pueden hacerse así en el caso de degeneración o valores propios repetidos. Así, al imponer la ortogonalidad con el estado propio correspondiente a , estamos optimizando efectivamente sobre el subespacio que corresponde al resto de los valores propios . Aquí, es el valor propio más bajo de entre los restantes y, por tanto, la solución óptima del nuevo problema puede obtenerse usando el teorema variacional.
La idea general detrás de VQD es usar VQE de la forma habitual para obtener el valor propio más bajo junto con el estado propio (aproximado) correspondiente para algún vector de parámetros óptimo . Luego, para obtener el siguiente valor propio , en lugar de minimizar la función de coste , optimizamos:
El valor positivo debería ser idealmente mayor que .
Esto introduce una nueva función de coste que puede verse como un problema con restricciones, donde minimizamos sujeto a la restricción de que el estado debe ser ortogonal al previamente obtenido, con actuando como término de penalización si la restricción no se satisface.
Alternativamente, este nuevo problema puede interpretarse como ejecutar VQE sobre el observable:
Asumiendo que la solución al nuevo problema es , el valor esperado de (no de ) debería ser . Para obtener el tercer valor propio , la función de coste a optimizar es:
donde es una constante positiva suficientemente grande para imponer la ortogonalidad del estado solución tanto con como con . Esto penaliza los estados del espacio de búsqueda que no cumplen este requisito, restringiendo efectivamente dicho espacio. Así, la solución óptima del nuevo problema debería ser el estado propio correspondiente a .
Al igual que en el caso anterior, este nuevo problema también puede interpretarse como VQE con el observable:
Si la solución a este nuevo problema es , el valor esperado de (no de ) debería ser . De forma análoga, para obtener el -ésimo valor propio , minimizarías la función de coste:
Recuerda que definimos de forma que . Este problema es equivalente a minimizar pero con la restricción de que el estado debe ser ortogonal a , restringiendo así el espacio de búsqueda al subespacio correspondiente a los valores propios .
Este problema es equivalente a un VQE con el observable:
Como puedes ver en el proceso, para obtener el -ésimo valor propio necesitas los estados propios (aproximados) de los valores propios anteriores, por lo que tendrías que ejecutar VQE un total de veces. Por tanto, la función de coste de VQD es la siguiente:
Diseño teórico
El esquema de VQD puede resumirse así:
-
Preparar un operador de referencia
-
Aplicar la forma variacional al estado de referencia, creando los siguientes ansätze
-
Arrancar en si se dispone de un problema similar (típicamente hallado mediante simulación clásica o muestreo).
-
Evaluar la función de coste , que implica calcular estados excitados y un array de 's que define la penalización por solapamiento para cada término.
-
Calcular el valor esperado de un observable para cada
-
Calcular la penalización .
-
La función de coste debe devolver la suma de estos dos términos
-
-
Usar un optimizador clásico para elegir el siguiente conjunto de parámetros .
-
Repetir este proceso hasta alcanzar la convergencia.
Implementación
Para esta implementación, crearemos una función para una penalización por solapamiento. Esta penalización se usará en la función de coste en cada iteración. Este proceso se repetirá para cada estado excitado.
from qiskit.circuit.library import TwoLocal

ansatz = TwoLocal(2, rotation_blocks=["ry", "rz"], entanglement_blocks="cz", reps=1)

ansatz.decompose().draw("mpl")

Primero, definiremos una función que calcula la fidelidad del estado — un porcentaje de solapamiento entre dos estados que usaremos como penalización para VQD:
import numpy as np

def calculate_overlaps(ansatz, prev_circuits, parameters, sampler):
    def create_fidelity_circuit(circuit_1, circuit_2):
        """
        Constructs the list of fidelity circuits to be evaluated.
        These circuits represent the state overlap between pairs of input circuits,
        and their construction depends on the fidelity method implementations.
        """

        if len(circuit_1.clbits) > 0:
            circuit_1.remove_final_measurements()
        if len(circuit_2.clbits) > 0:
            circuit_2.remove_final_measurements()

        circuit = circuit_1.compose(circuit_2.inverse())
        circuit.measure_all()
        return circuit

    overlaps = []

    for prev_circuit in prev_circuits:
        fidelity_circuit = create_fidelity_circuit(ansatz, prev_circuit)
        sampler_job = sampler.run([(fidelity_circuit, parameters)])
        meas_data = sampler_job.result()[0].data.meas

        counts_0 = meas_data.get_int_counts().get(0, 0)
        shots = meas_data.num_shots
        overlap = counts_0 / shots
        overlaps.append(overlap)

    return np.array(overlaps)
Es el momento de escribir la función de coste de VQD. Como antes, cuando calculamos solo el estado fundamental, determinaremos el estado de menor energía usando la primitiva Estimator. Sin embargo, tal como se describió más arriba, ahora añadiremos un término de penalización para garantizar la ortogonalidad de los estados de mayor energía. Es decir, para cada nuevo estado excitado, se añade una penalización por cualquier solapamiento entre el estado variacional actual y los estados propios de menor energía ya encontrados.
def cost_func_vqd(
    parameters, ansatz, prev_states, step, betas, estimator, sampler, hamiltonian
):
    estimator_job = estimator.run([(ansatz, hamiltonian, [parameters])])

    total_cost = 0

    if step > 1:
        overlaps = calculate_overlaps(ansatz, prev_states, parameters, sampler)
        total_cost = np.sum(
            [np.real(betas[state] * overlap) for state, overlap in enumerate(overlaps)]
        )

    estimator_result = estimator_job.result()[0]

    value = estimator_result.data.evs[0] + total_cost

    return value
Nota especialmente que la función de coste anterior hace referencia a la función calculate_overlaps, que en realidad crea un nuevo circuito cuántico. Si queremos ejecutar esto en hardware real, ese nuevo circuito también debe ser transpilado, idealmente de forma óptima, para ejecutarse en el backend que seleccionemos. Observa que la transpilación no está incorporada en las funciones calculate_overlaps ni cost_func_vqd. Puedes intentar modificar el código tú mismo para añadir esta transpilación adicional (y condicional) — pero esto también se hará por ti en la siguiente lección.
En esta lección, ejecutaremos el algoritmo VQD usando el Statevector Sampler y el Statevector Estimator:
from qiskit.primitives import StatevectorEstimator as Estimator

sampler = Sampler()
estimator = Estimator()
Introduciremos un observable a estimar. En la siguiente lección le daremos un contexto físico, como el estado excitado de una molécula. Puede ser útil pensar en este observable como el hamiltoniano de un sistema que puede tener estados excitados, aunque este observable no se ha elegido para representar ninguna molécula o átomo en particular.
from qiskit.quantum_info import SparsePauliOp

observable = SparsePauliOp.from_list([("II", 2), ("XX", -2), ("YY", 3), ("ZZ", -3)])
Aquí definimos el número total de estados que deseamos calcular (estado fundamental y estados excitados, k), y las penalizaciones (betas) por solapamiento entre vectores de estado que deberían ser ortogonales. Las consecuencias de elegir betas demasiado altas o demasiado bajas se explorarán un poco en la siguiente lección. Por ahora, usaremos simplemente las que se proporcionan a continuación. Comenzaremos usando ceros como parámetros iniciales. En tus propios cálculos, quizás quieras usar parámetros iniciales más inteligentes basados en tu conocimiento del sistema o en cálculos anteriores.
k = 3
betas = [33, 33, 33]
x0 = np.zeros(8)
Ya podemos ejecutar el cálculo:
from scipy.optimize import minimize

prev_states = []
prev_opt_parameters = []
eigenvalues = []

for step in range(1, k + 1):
    if step > 1:
        prev_states.append(ansatz.assign_parameters(prev_opt_parameters))

    result = minimize(
        cost_func_vqd,
        x0,
        args=(ansatz, prev_states, step, betas, estimator, sampler, observable),
        method="COBYLA",
        options={
            "maxiter": 200,
        },
    )
    print(result)

    prev_opt_parameters = result.x
    eigenvalues.append(result.fun)
message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -5.999999979545955
       x: [-5.150e-01 -5.452e-02 -1.571e+00 -2.853e-05  2.671e-01
           -2.672e-01 -8.509e-01 -8.510e-01]
    nfev: 131
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: 4.024550284767612
       x: [-3.745e-01  1.041e+00  8.637e-01  1.202e+00 -8.847e-02
            1.181e-02  7.611e-01 -3.006e-01]
    nfev: 110
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: 5.608925562838559
       x: [-2.670e-01  1.280e+00  1.070e+00 -8.031e-01 -1.524e-01
           -6.956e-02  7.018e-01  1.514e+00]
    nfev: 90
   maxcv: 0.0
Los valores que obtuvimos de la función de coste son aproximadamente -6,00, 4,02 y 5,61. Lo importante de estos resultados es que los valores de la función van aumentando. Si hubiéramos obtenido un primer estado excitado con una energía menor que el cálculo inicial sin restricciones del estado fundamental, eso habría indicado un error en algún lugar de nuestro código.
Los valores de x son los parámetros que produjeron un vector de estado correspondiente a cada uno de estos costes (energías).
Por último, observamos que las tres minimizaciones convergieron dentro de la tolerancia predeterminada del optimizador clásico (aquí COBYLA). Requirieron 131, 110 y 90 evaluaciones de función, respectivamente.
Regresión por muestreo cuántico (QSR)
Uno de los principales problemas de VQE es la gran cantidad de llamadas a un ordenador cuántico necesarias para obtener los parámetros en cada paso, por ejemplo, , , etc. Esto es especialmente problemático cuando el acceso a los dispositivos cuánticos está en cola. Aunque se puede usar una Session para agrupar múltiples llamadas iterativas, un enfoque alternativo es el muestreo. Al aprovechar más recursos clásicos, podemos completar el proceso completo de optimización en una sola llamada. Aquí es donde entra en juego la Regresión por muestreo cuántico. Dado que el acceso a los ordenadores cuánticos sigue siendo un recurso escaso con alta demanda, este intercambio nos parece tanto factible como conveniente para muchos estudios actuales. Este enfoque aprovecha toda la capacidad clásica disponible y, al mismo tiempo, captura muchos de los mecanismos internos y propiedades intrínsecas de los cálculos cuánticos que no aparecen en la simulación.
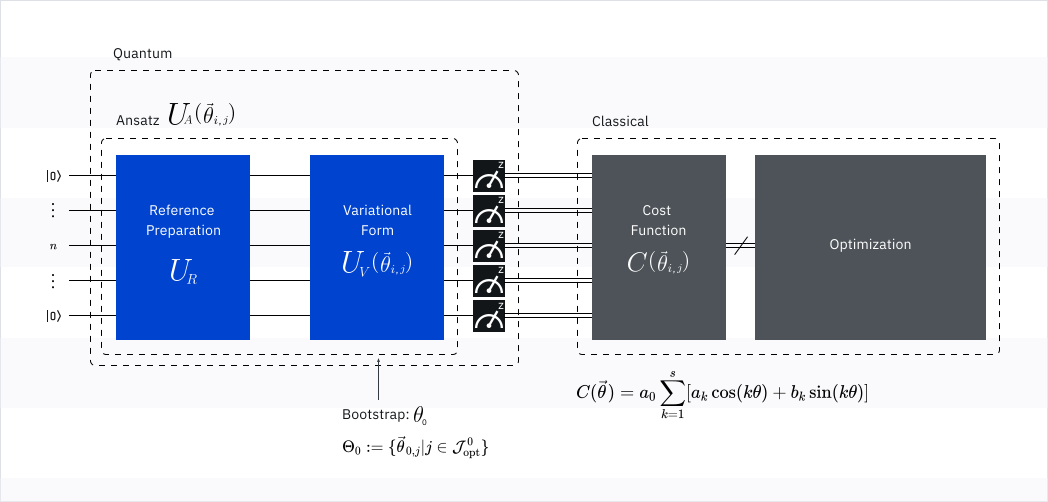
La idea detrás de QSR es que la función de coste puede expresarse como una serie de Fourier de la siguiente manera:
Dependiendo de la periodicidad y el ancho de banda de la función original, el conjunto puede ser finito o infinito. A efectos de esta discusión, asumiremos que es infinito. El siguiente paso es muestrear la función de coste múltiples veces para obtener los coeficientes de Fourier . En concreto, como tenemos incógnitas, necesitaremos muestrear la función de coste veces.
Si muestreamos la función de coste para valores de parámetro , obtenemos el siguiente sistema:
que reescribiremos como
En la práctica, este sistema generalmente no es consistente porque los valores de la función de coste no son exactos. Por ello, suele ser buena idea normalizarlos multiplicando por por la izquierda, lo que da como resultado:
Este nuevo sistema siempre es consistente, y su solución es la solución de mínimos cuadrados al problema original. Si tenemos parámetros en lugar de solo uno, y cada parámetro tiene su propio para , entonces el número total de muestras requeridas es:
donde . Además, ajustar como parámetro ajustable (en lugar de inferirlo) abre nuevas posibilidades, como:
-
Sobremuestreo para mejorar la precisión.
-
Submuestreo para aumentar el rendimiento reduciendo la sobrecarga de tiempo de ejecución o eliminando mínimos locales.
Esquema teórico
El esquema de QSR puede resumirse así:
-
Preparar operadores de referencia .
- Iremos del estado al estado de referencia
-
Aplicar la forma variacional para crear un ansatz .
- Determinar el ancho de banda asociado a cada parámetro del ansatz. Una cota superior es suficiente.
-
Iniciar en si tenemos un problema similar (normalmente encontrado mediante simulación clásica o muestreo).
-
Muestrea la función de costo al menos veces.
-
-
Decidir si realizar sobremuestreo/submuestreo para equilibrar velocidad frente a precisión ajustando .
-
-
Calcular los coeficientes de Fourier a partir de las muestras (es decir, resolver el sistema de ecuaciones lineales normalizado).
-
Resolver el mínimo global de la función de regresión resultante en una máquina clásica.
Resumen
Con esta lección, aprendiste sobre múltiples instancias variacionales disponibles:
-
Esquema general
-
Introducción de pesos y penalizaciones para ajustar una función de coste
-
Exploración del submuestreo frente al sobremuestreo para intercambiar velocidad por precisión
Estas ideas se pueden adaptar para formar un algoritmo variacional personalizado que se ajuste a tu problema. Te animamos a compartir tus resultados con la comunidad. La próxima lección explorará cómo usar un algoritmo variacional para resolver una aplicación.