Recursos de cómputo y gestión de recursos
Modelo de recursos y recursos clásicos
En esta sección, presentamos un marco para comprender los entornos de cómputo, desde una computadora portátil hasta los supercomputadores. Al final de esta sección, conocerás los componentes básicos de un entorno de cómputo y cómo se relacionan entre sí. Iskandar Sitdikov ofrece una visión general en el siguiente video.
Modelo de recursos
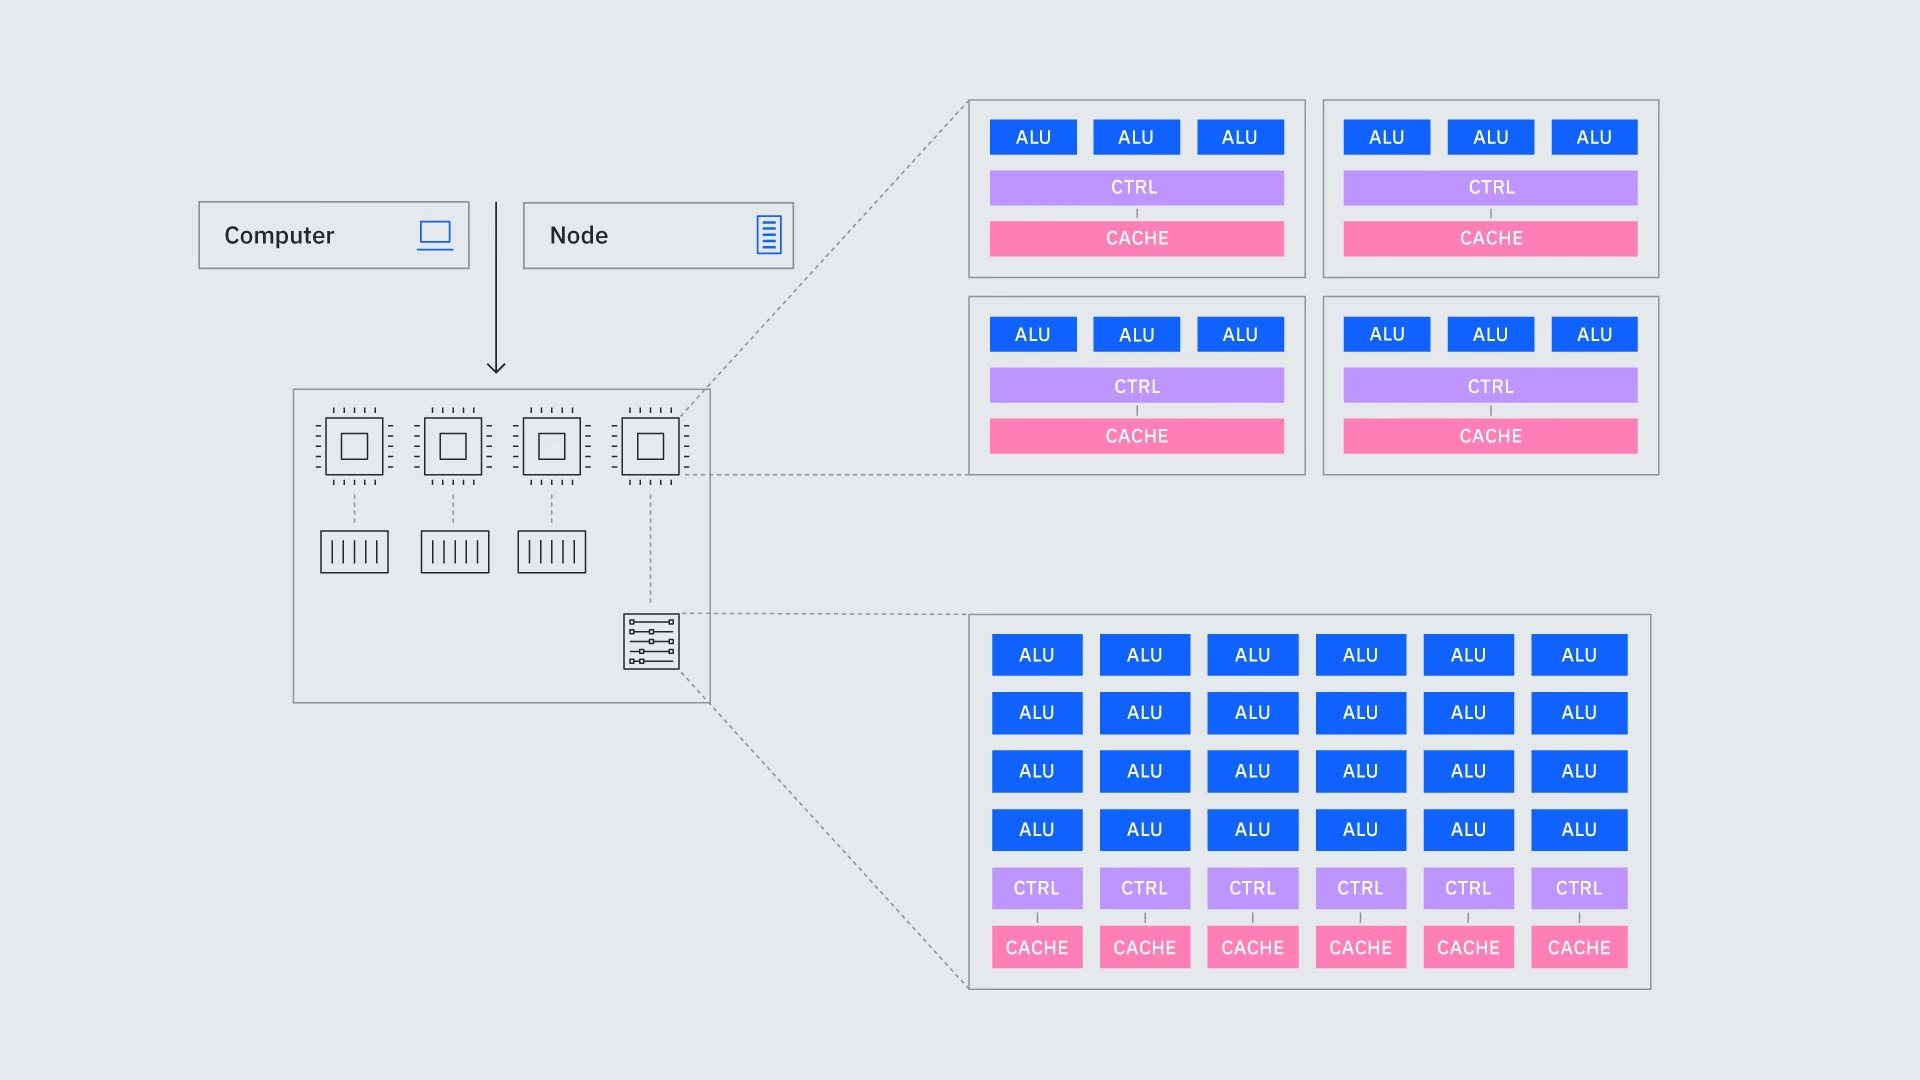
Cada entorno de cómputo clásico consta de múltiples recursos interconectados que trabajan juntos para ejecutar aplicaciones de manera eficiente. Los recursos más importantes suelen incluir:
-
CPU (Unidad Central de Procesamiento): La CPU es la unidad central de procesamiento que interpreta y ejecuta las instrucciones del programa. Realiza operaciones lógicas, aritméticas y de control, siendo esencialmente el "cerebro" del sistema.
-
Caché de CPU (L1, L2, L3): Es la memoria más rápida del sistema, integrada directamente en el núcleo de la CPU o construida muy cerca de él. Almacena pequeñas cantidades de datos e instrucciones que la CPU necesita de forma inmediata. Los diferentes niveles (L1, L2, L3) representan un compromiso: L1 es el más pequeño y rápido, L3 es el más grande y lento, pero aún así órdenes de magnitud más rápido que la RAM.
-
RAM (Memoria de Acceso Aleatorio): Memoria volátil que proporciona un gran espacio de almacenamiento temporal para instrucciones de programas y datos en uso activo. Garantiza que la CPU pueda acceder rápidamente a la información necesaria durante la ejecución, sin depender constantemente de dispositivos de almacenamiento más lentos.
-
Almacenamiento (local y en red): El almacenamiento preserva datos y software incluso cuando el sistema está apagado, proporcionando persistencia a largo plazo para grandes conjuntos de datos y aplicaciones. En centros de computación de alto rendimiento, las soluciones de almacenamiento deben procesar enormes cantidades de datos científicos o analíticos de forma rápida y fiable. El almacenamiento local incluye unidades de estado sólido (SSD) y discos duros (HDD); se prefieren los SSD por su menor latencia y mayor velocidad de transferencia. Para el procesamiento de grandes volúmenes de datos, los sistemas de archivos paralelos, el almacenamiento en red compartido y los sistemas basados en objetos permiten un acceso rápido a través de muchos nodos de cómputo, mientras que el almacenamiento en la nube y de archivo soportan la retención a largo plazo y la escalabilidad.
-
GPU (Unidad de Procesamiento Gráfico): Aunque originalmente diseñadas para la representación gráfica, las GPU modernas son potentes procesadores paralelos. Se utilizan frecuentemente para tareas que requieren muchos cálculos simultáneos, como el aprendizaje profundo, las simulaciones de física y el análisis de big data. Es importante señalar que las GPU no reemplazan a las CPU: las CPU controlan la lógica del programa a nivel superior, mientras que las GPU aceleran los pasos altamente paralelos.
-
Interconexiones/Buses: Son las vías de comunicación que conectan CPU, memoria, almacenamiento de datos y dispositivos periféricos entre sí. Los buses permiten la transferencia de datos y la coordinación entre los componentes del sistema, asegurando una comunicación fluida dentro del entorno de cómputo. En los sistemas HPC, componentes como CPU, GPU y dispositivos de almacenamiento están conectados mediante interconexiones de alta velocidad que permiten un intercambio rápido de datos. Las GPU generalmente se conectan al sistema a través de PCIe, una interfaz estándar con múltiples líneas de datos para una comunicación eficiente. Para mayor rendimiento, NVLink proporciona una conexión directa de alto ancho de banda entre GPU o entre GPU y CPU, lo que reduce la latencia y acelera las cargas de trabajo paralelas.
-
Sistema de archivos: El sistema de archivos organiza los datos en los dispositivos de almacenamiento. Crea una estructura para almacenar, recuperar y gestionar archivos, permitiendo que programas y usuarios accedan a la información de manera consistente y lógicamente organizada.
Cada tipo de recurso tiene sus propias unidades de medida de rendimiento. Por ejemplo, las CPU se miden habitualmente por "núcleos" y "frecuencia de reloj". Al comprar una computadora portátil, sus especificaciones suelen incluir el número de núcleos. Un concepto similar se aplica a los nodos de cómputo en un centro de datos, donde cada nodo tiene asociado un número específico de núcleos. Los entornos de cómputo que incluyen múltiples tipos de recursos (CPU, GPU e incluso QPU) se denominan entornos de cómputo heterogéneos. Estas configuraciones procesan diferentes cargas de trabajo de manera más eficiente al aprovechar las fortalezas de cada tipo de procesador. Por ejemplo, las CPU se usarían para tareas generales y las GPU para el procesamiento paralelo. En el contexto de la gestión de recursos y la planificación de trabajos —especialmente para entornos de cómputo heterogéneos— pueden requerirse unidades de medida adicionales además de las descritas aquí.
Para la memoria, la unidad de medida es Mega-/Giga-/Terabytes.
Para tarjetas gráficas y otros aceleradores, la unidad de medida depende del contexto. Mientras que su capacidad de cómputo real se describe mediante métricas detalladas —número de núcleos de procesamiento, tamaño de memoria y ancho de banda de memoria—, en discusiones de alto nivel sobre recursos de clúster o planificación de trabajos, las GPU y aceleradores similares se cuantifican a nivel de dispositivo, es decir, por el número de dispositivos completos asignados (por ejemplo, tres GPU).
La red/conectividad/buses son aspectos cruciales de cualquier infraestructura de cómputo, ya que determinan la velocidad con la que se transfieren datos entre los componentes de cómputo. Desde la CPU a la caché de la CPU, a la RAM, a las tarjetas PCI y hasta los dispositivos conectados en red, todo es comunicación, y un modelo mental preciso de esto es esencial para desarrollar algoritmos altamente optimizados para HPC.
Escalamiento de recursos clásicos
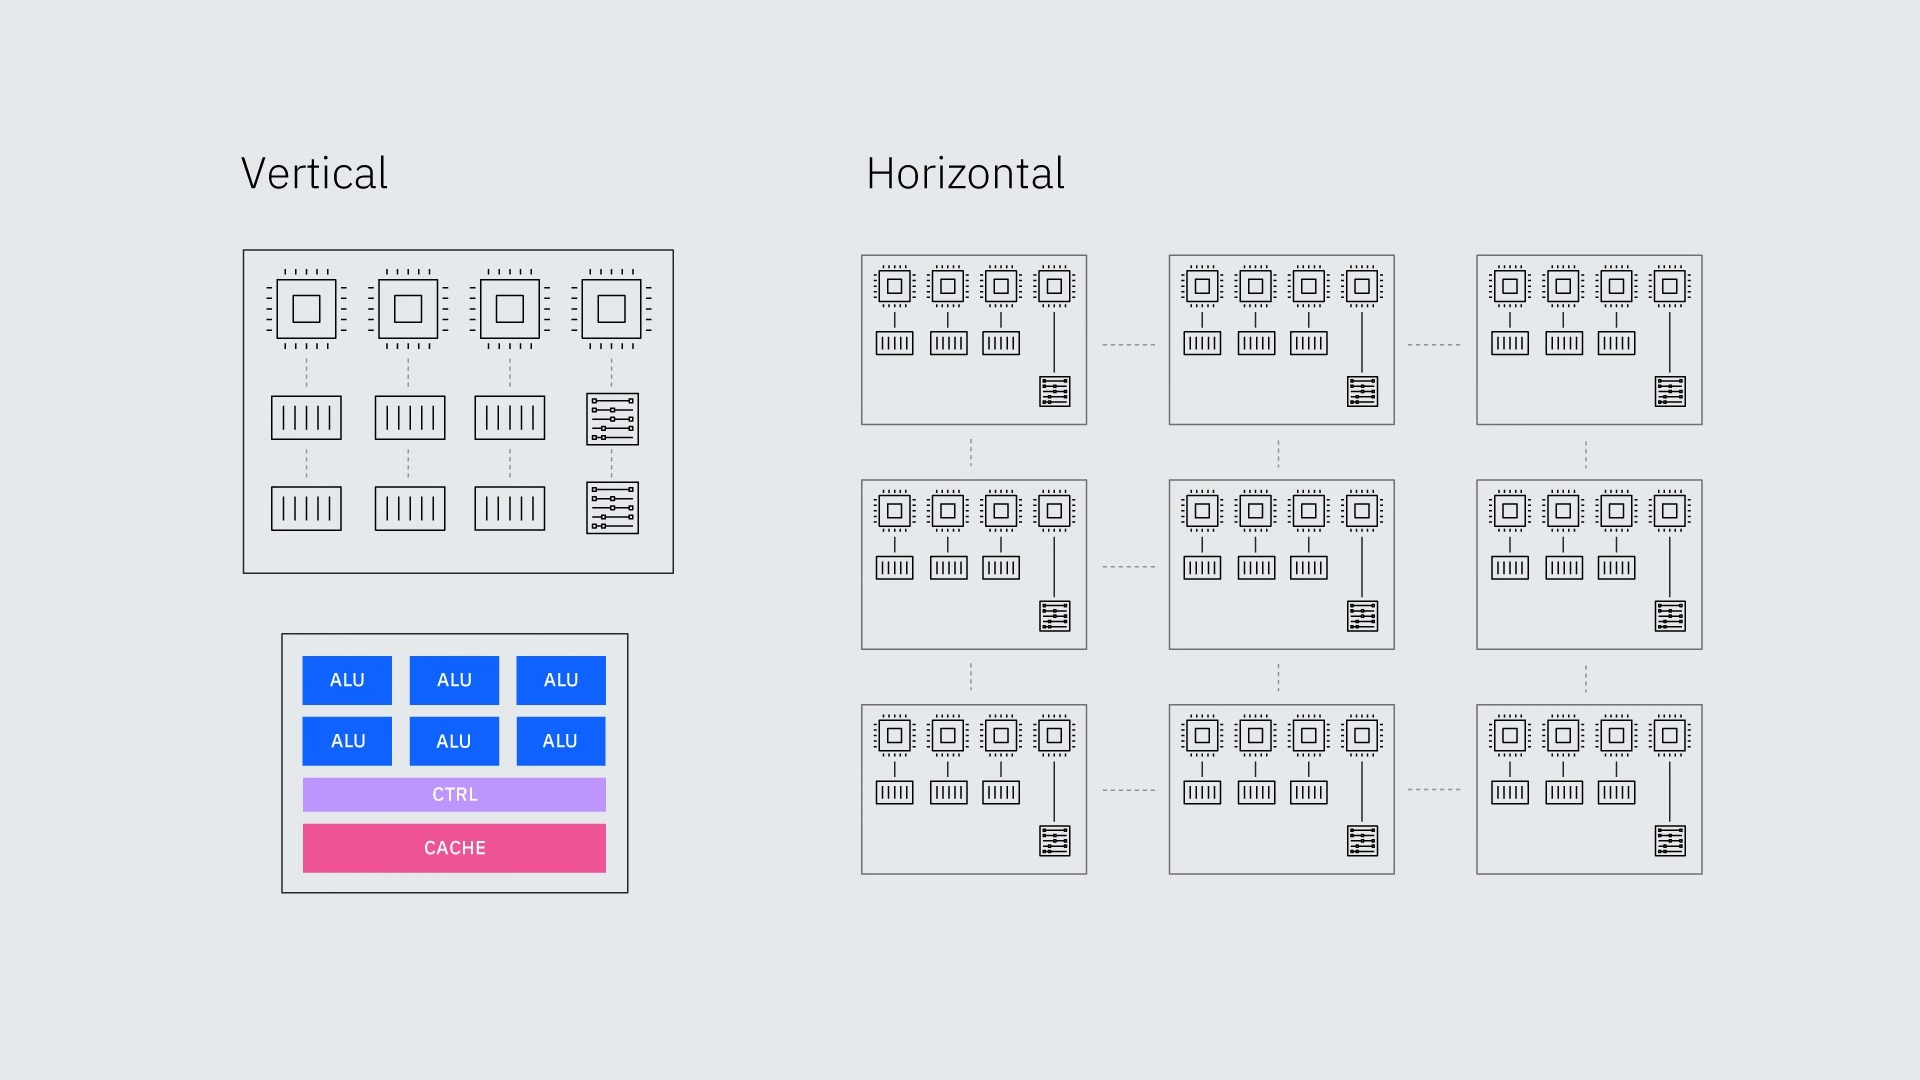
La Computación de Alto Rendimiento (HPC) implica el escalamiento de estos recursos clásicos para lograr tiempos de procesamiento más rápidos o aumentar la cantidad de datos que se pueden procesar simultáneamente (por ejemplo, para ampliar el espacio de soluciones que se puede explorar). Esto se puede lograr mediante:
-
Escalamiento vertical: Aumento del rendimiento de recursos individuales, por ejemplo, mediante una CPU más potente o memoria adicional dentro de un nodo físico, donde un nodo es una unidad de un clúster de cómputo que agrupa múltiples recursos de cómputo.
-
Escalamiento horizontal: Adición de más recursos, como múltiples CPU o GPU, que trabajan juntos en un solo nodo o, más comúnmente, en múltiples nodos para permitir la computación distribuida.
Algunos de los conceptos de escalamiento de esta sección se transfieren a la siguiente sección sobre recursos de cómputo cuántico. Otros aspectos de los recursos cuánticos se cuantifican de maneras nuevas.
Preguntas de comprensión
A partir de las descripciones anteriores, deduce algunas ventajas y desventajas de los diferentes enfoques de escalamiento: ¿escalamiento vertical y horizontal?
Respuesta
Puede haber muchas respuestas correctas. El escalamiento vertical suele ser más sencillo, especialmente si tienes cargas de trabajo predecibles con un requerimiento fijo de recursos. Sin embargo, puede ser más costoso de actualizar, ya que la unidad básica de cómputo no se puede dividir tan fácilmente como en el escalamiento horizontal. El escalamiento horizontal es más complejo de gestionar, y a veces surgen dificultades o latencias por las conexiones entre nodos. A cambio, se adapta mucho mejor a requisitos de recursos variables y es modular cuando se necesitan actualizaciones.
Nuevo tipo de recurso: QPU (Unidad de Procesamiento Cuántico)
En esta sección, presentamos un nuevo tipo de recurso —un recurso cuántico— y exploramos su definición, unidades de medida y conectividad con la infraestructura clásica.
Definición de QPU
- Unidad de Procesamiento Cuántico (QPU): Una QPU abarca todo el hardware responsable de recibir un conjunto ejecutable de instrucciones cuánticas o un circuito cuántico y devolver un resultado preciso.
Esto significa que la QPU incluye uno o más chips cuánticos (por ejemplo, Heron), los diversos componentes adicionales en el refrigerador de dilución como los amplificadores cuánticos, la electrónica de control y la capacidad de cómputo clásico necesaria para tareas como mantener instrucciones y formas de onda en memoria, acumular resultados y la futura decodificación de corrección de errores. Aunque se requiere un refrigerador de dilución para estas tareas, lo excluimos de esta definición para permitir el caso de múltiples QPU en el mismo refrigerador.
-
Computador cuántico: Un computador cuántico consiste en la QPU más la capacidad de cómputo clásico que aloja el entorno de ejecución.
-
Entorno de ejecución: La combinación de hardware y software que permite ejecutar un programa.
Capas en circuitos cuánticos
Tanto en la computación clásica como en la cuántica, los procesos pueden ejecutarse de forma secuencial o en paralelo. Dado que los qubits tienen un espacio de estados más rico que los bits clásicos, a veces tiene sentido ejecutar múltiples puertas de un solo qubit secuencialmente en un qubit (por ejemplo, una puerta R_x seguida de una puerta R_z). Como el entrelazamiento entre qubits es esencial para la computación cuántica, un circuito cuántico frecuentemente contiene un conjunto de puertas de entrelazamiento que actúan sobre muchos qubits. Estos y otros factores hacen habitual identificar procesos que pueden ejecutarse en paralelo a nivel de operaciones individuales de puertas en un circuito cuántico. En la computación clásica, el paralelismo a nivel de bits también es posible, pero se considera menos frecuentemente a nivel de puertas; es más común describir procesos paralelos y secuenciales a una escala mayor.
En computación cuántica, una "capa" de compuertas se refiere a un conjunto de compuertas que pueden todas ejecutarse simultáneamente. En muchas aplicaciones es útil realizar un conjunto de rotaciones en todos los qubits y luego compuertas de entrelazamiento entre pares de qubits. En estos contextos, se refiere a una "capa de rotación" (una capa de compuertas como R_x, R_y y/o R_z) y una "capa de entrelazamiento" (como una con compuertas CNOT). El número de capas en un circuito es la "profundidad del circuito", una medida importante ya que mayor profundidad significa más capas de ruido compuesto y errores.
Las capas de puertas son difíciles de identificar visualmente cuando no están alineadas por barreras. En Qiskit, una barrera sirve como instrucción en circuitos cuánticos que actúa tanto como separador visual como restricción de compilación. Al dibujar y ejecutar el circuito, ninguna puerta se desplaza más allá de la barrera. Esto es importante en contextos como el Dynamical Decoupling, donde se implementan intencionalmente puertas que se simplifican a la identidad para suprimir ciertos tipos de errores. Puedes encontrar más información sobre el Dynamical Decoupling en esta guía. Para el efecto visual de las barreras, compara estas dos imágenes del mismo circuito: la primera sin barreras y la segunda con barreras para forzar la alineación de las capas.


Estos son los mismos circuitos con el mismo número de capas. Sin embargo, en el segundo, la alineación facilita ver que el circuito contiene:
- Dos capas de rotación: una alrededor del eje Y por , una alrededor del eje Z por .
- Tres capas de entrelazamiento. Ten en cuenta que se puede contar cada CNOT como su propia "capa", ya que los CNOT no pueden reordenarse sin cambiar la operación lógica.
- Dos capas de rotación más: una alrededor del eje Y por , una alrededor del eje Z por .
- Dos capas de entrelazamiento más. Esta vez, la primera capa se ha paralelizado un poco más que en el primer grupo de capas de entrelazamiento.
La profundidad de cada circuito es 9.
Unidades de medida
En la computación cuántica, las capacidades de un sistema cuántico a menudo se describen utilizando tres dimensiones fundamentales: escala, calidad y velocidad. IBM Quantum caracteriza estas dimensiones utilizando tres métricas de hardware que se pueden aplicar en distintas modalidades de computación cuántica: qubits programables (escala), operaciones de qubit (calidad) y máximo de circuitos por segundo (velocidad). Estas métricas proporcionan una visión general de la capacidad y eficiencia computacional de un sistema en las distintas implementaciones de hardware.
-
La escala se mide por el número de qubits programables. Los qubits programables son los qubits que los usuarios pueden controlar, manipular, medir e incorporar directamente en algoritmos cuánticos.
-
La calidad se mide por las operaciones de qubit (QuOps), una métrica que describe cuántas de las operaciones computacionalmente más exigentes puede ejecutar de forma fiable un sistema antes de que los errores acumulados desborden el cálculo. Una mayor capacidad de QuOps generalmente permite circuitos más profundos y algoritmos cuánticos más sofisticados.
-
La velocidad se mide por el máximo de circuitos por segundo, también conocido como rendimiento de circuitos. Esta métrica captura cuántos circuitos cuánticos útiles puede ejecutar un sistema a lo largo del tiempo y ofrece una indicación de la eficiencia computacional general.
A menudo se utilizan métricas de hardware adicionales para caracterizar aspectos específicos del comportamiento del procesador. Por ejemplo, EPLG (errores por puerta en capas) y las mediciones de fidelidad de capa proporcionan información sobre la calidad de las puertas y la acumulación de errores, mientras que CLOPS (Operaciones de Circuito por Capa por Segundo) mide la velocidad de ejecución de una carga de trabajo estandarizada de benchmarking cuántico. Estas métricas siguen siendo útiles para evaluar cargas de trabajo particulares y detalles de implementación, pero los qubits programables, las operaciones de qubit y el máximo de circuitos por segundo proporcionan un marco más amplio para comparar sistemas cuánticos.
Diferencias entre métricas cuánticas y clásicas
Los sistemas de computación clásica a menudo se caracterizan utilizando métricas como FLOPS (operaciones de punto flotante por segundo), capacidad de memoria, ancho de banda de memoria y velocidades de reloj del procesador. Se pueden establecer algunas analogías vagas entre estas y las métricas para computadoras cuánticas introducidas anteriormente, pero las diferencias entre las métricas son importantes.
El máximo de circuitos por segundo puede verse como una analogía vaga de las métricas de rendimiento orientadas al throughput en la computación clásica, ya que mide cuánto trabajo útil puede realizar un sistema cuántico a lo largo del tiempo. Sin embargo, a diferencia de FLOPS, mide la ejecución de circuitos cuánticos en lugar de operaciones aritméticas.
A veces se compara CLOPS con benchmarks clásicos de throughput como FLOPS, pero se entiende mejor como un benchmark específico de carga de trabajo en lugar de una medida universal del rendimiento de la computación cuántica. EPLG y las mediciones de fidelidad relacionadas proporcionan información sobre la precisión con la que un procesador ejecuta capas de puertas cuánticas. Estas métricas son útiles para entender características específicas del hardware, mientras que el marco principal de escala-calidad-velocidad proporciona una base más general para comparar sistemas cuánticos. Se pueden encontrar muchas descripciones del rendimiento de las computadoras cuánticas en la página Recursos de cómputo en IBM Quantum Platform. Ten en cuenta que, si bien el número de qubits programables es un número fijo para una QPU dada, las métricas de velocidad y calidad pueden variar ligeramente con el tiempo debido a actualizaciones de calibración, mantenimiento, condiciones operativas y mejoras en la infraestructura de hardware y software circundante.
Juntas, estas métricas complementarias ayudan a guiar la asignación de recursos, la programación y el diseño de aplicaciones en sistemas de computación cuántica.
En muchos casos, todo el sistema cuántico se trata como una sola unidad. Sin embargo, cuando una tarea excede la capacidad de una unidad—ya sea en términos de recuento de qubits programables, profundidad de circuito, o rendimiento de circuito—se pueden usar técnicas como corte/tejido de circuitos. El corte de circuitos es el proceso de dividir tareas cuánticas grandes en subtareas más pequeñas y manejables que se pueden distribuir entre múltiples chips cuánticos, permitiendo computación cuántica escalable a pesar de limitaciones de hardware. El tejido de circuitos se refiere al proceso que viene después del corte de circuitos—el paso de posprocesamiento clásico que "teje" o combina los resultados de los subcircuitos más pequeños nuevamente.
Los computadores cuánticos no tienen memoria tradicional en el sentido de almacenamiento persistente y direccionable como la RAM o la memoria de GPU. Los recursos de cómputo clásicos tienen bits discretos almacenados en memoria, por lo que los datos pueden guardarse, recuperarse y reutilizarse durante el cálculo. Los recursos cuánticos utilizan qubits, que no almacenan memoria en el sentido clásico. En cambio, los qubits existen en estados cuánticos que representan superposiciones de 0 y 1 simultáneamente, lo que permite un paralelismo exponencial en el espacio de estados. Sin embargo, los estados de los qubits son frágiles y no pueden clonarse ni leerse de manera determinista en pasos intermedios sin colapsar el estado cuántico, por lo que no existe un comportamiento similar a la memoria persistente durante el cálculo. Los qubits deben mantenerse en un estado coherente durante toda la ejecución, y la "memoria" es esencialmente el propio estado cuántico. La memoria clásica solo puede utilizarse junto a un procesador cuántico, no como memoria cuántica interna. Esto tiene implicaciones significativas: los recursos de cómputo clásicos pueden reutilizar y almacenar libremente resultados intermedios; los recursos cuánticos no pueden hacerlo sin realizar mediciones que perturban el cálculo.
Conectividad con la infraestructura clásica
Las QPU pueden conectarse a infraestructura clásica a través de redes y diversas interfaces de programación de aplicaciones (API) que permiten a desarrolladores de software interactuar con QPU programáticamente. Estas API generalmente se ocultan detrás de kits de desarrollo de software (SDK) y bibliotecas (como Qiskit) y se exponen a científicos computacionales en forma de abstracciones de programación (como primitivos, sobre los cuales hablaremos en el Capítulo 3: modelos de programación).
Vale la pena distinguir entre la integración estrecha y la integración flexible de recursos cuánticos y clásicos. Actualmente, las QPU no se encuentran en el mismo nodo que los recursos de cómputo clásicos. De hecho, las QPU están actualmente conectadas a través de la red, no mediante PCIe. Esto podría cambiar en el futuro, pero existen desafíos técnicos relacionados con las diferentes condiciones ambientales óptimas para las QPU y los recursos de cómputo clásicos.
Escalamiento de recursos cuánticos
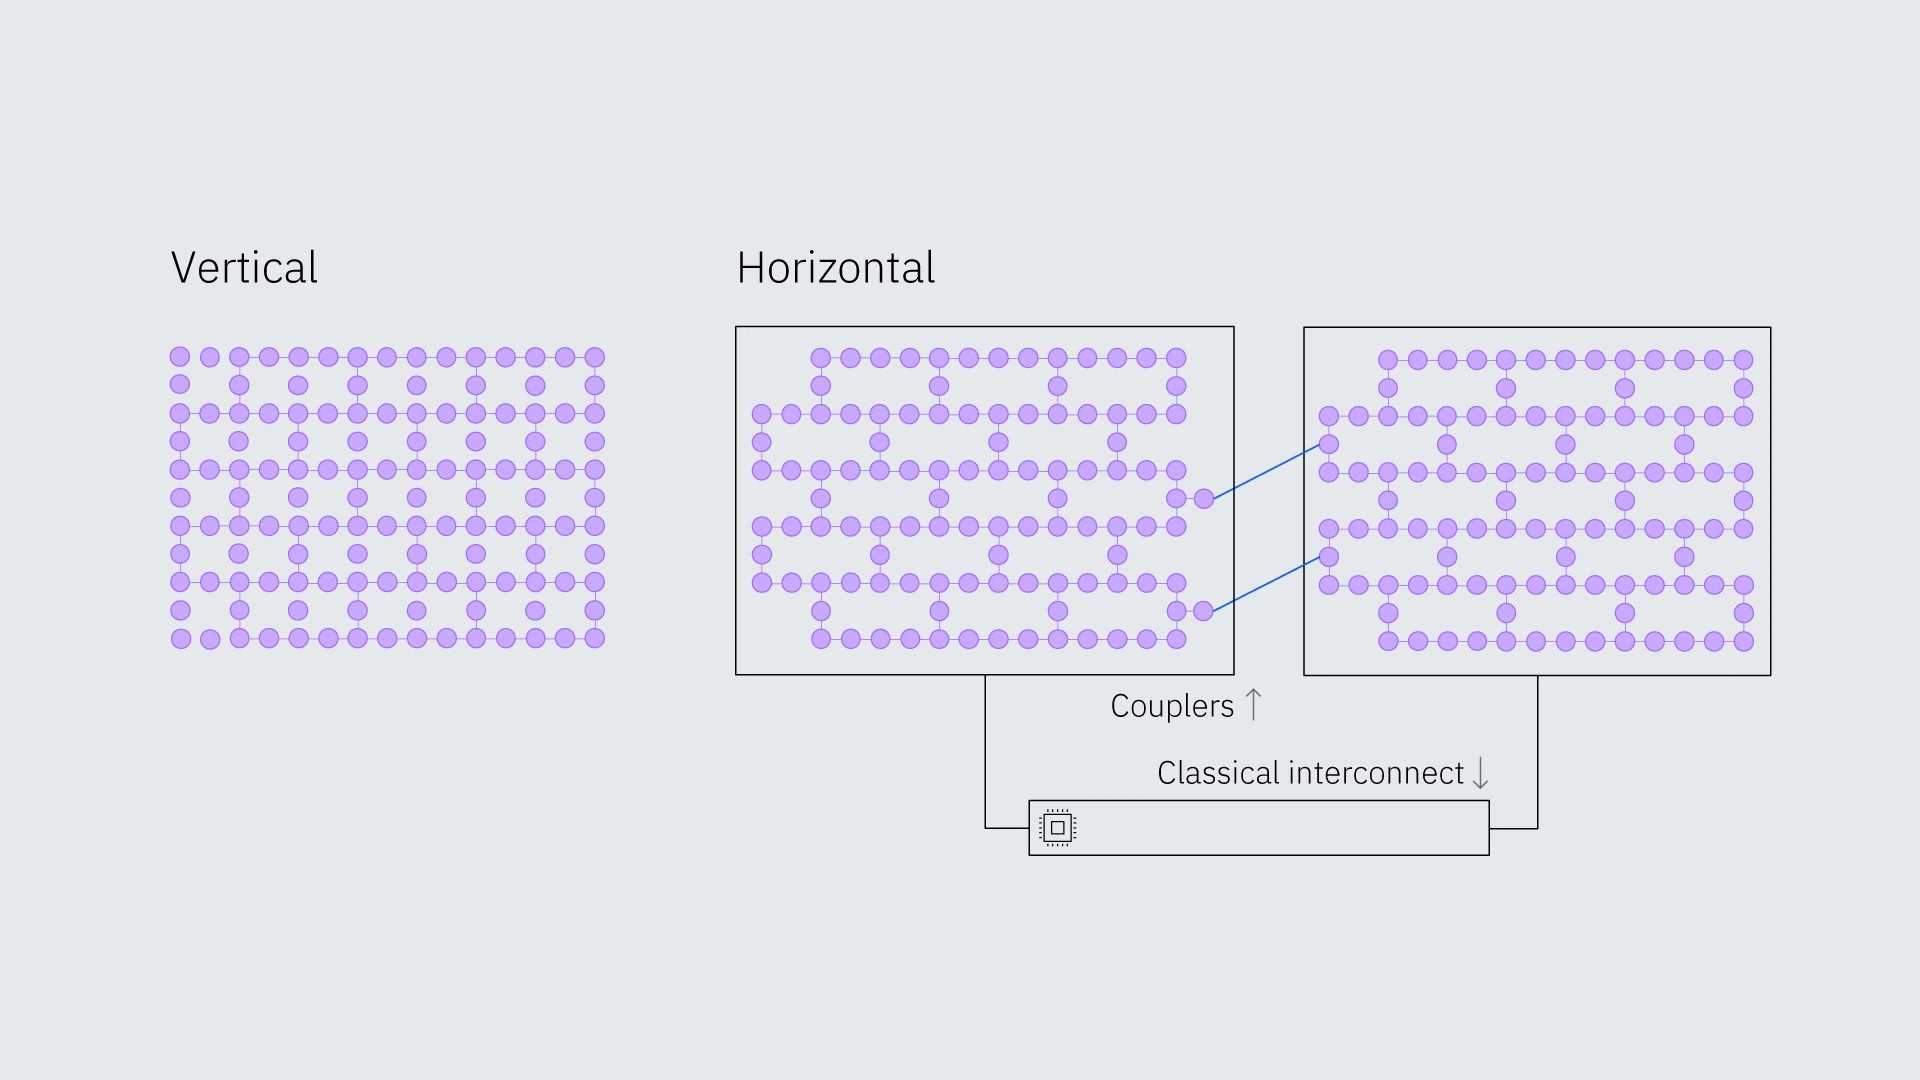
El escalamiento de recursos cuánticos también se puede clasificar en escalamiento vertical y horizontal.
-
El escalamiento vertical sería aumentar el número de qubits por chip o mejorar la fidelidad de los dispositivos.
-
El escalamiento horizontal sería conectar chips con acopladores o mediante interconexiones clásicas.
Preguntas de comprensión
¿Cuáles son los equivalentes cuánticos de (a) los bits de información clásicos y (b) la velocidad del procesador?
Respuesta
(a) Bits cuánticos o qubits: unidades de información que, a diferencia de sus contrapartes clásicas (que solo pueden tomar el estado 0 o 1), pueden estar simultáneamente en una superposición de 0 y 1. (b) Operaciones de capa de circuito por segundo o CLOPS: número de operaciones secuenciales que la QPU puede realizar cada segundo, incluyendo cierta interacción con recursos de cómputo clásico, como la carga de parámetros del circuito.
Gestión de recursos
Tanto los recursos HPC como los cuánticos son valiosos y complejos; deben gestionarse cuidadosamente. En esta sección, explicamos cómo se gestionan los recursos para los programas de los usuarios. La gestión de recursos en infraestructuras de cómputo se refiere al proceso de (1) planificación, (2) asignación y (3) control/gestión del uso de recursos de cómputo como CPU, memoria, almacenamiento de datos y ancho de banda de red, para garantizar un uso eficiente y efectivo de los recursos.
Planificación – Estimación de recursos
Cada programa consume recursos, y estimar la necesidad de recursos requeridos es crucial para una gestión eficiente de los mismos. Esto incluye la estimación de los requisitos de CPU, memoria y otros recursos para ejecutar un programa. Lo mismo aplica para los recursos cuánticos. Sin embargo, los recursos cuánticos existen en una escala completamente diferente. Los procesadores cuánticos IBM Quantum® Heron-r3 tienen 156 qubits, comparados con los miles de millones de bits clásicos en una computadora portátil común. El tiempo y el costo también deben considerarse. Actualmente, IBM Quantum ofrece un plan gratuito, el Open Plan, que permite a los usuarios explorar la computación cuántica con 10 minutos de tiempo de QPU por mes. Algunas organizaciones de investigación necesitan tanto tiempo de QPU que tienen un computador cuántico dedicado de IBM instalado en sus instalaciones.
Un paso en la estimación de recursos que es único para la computación cuántica es la profundidad del circuito. Como se menciónó anteriormente, cada puerta cuántica y cada tiempo de espera entre operaciones introduce ruido y una cierta probabilidad de error. Cuanto más profundo sea el circuito cuántico, mayor será el ruido. Hay dos sutilezas: las puertas de dos qubits tienen tasas de error mucho mayores que las puertas de un solo qubit, por lo que a menudo se puede ignorar la profundidad de un solo qubit. Además, no todos los qubits en un chip cuántico están directamente conectados entre sí. A veces es necesario intercambiar información de qubit a qubit para poder realizar los entrelazamientos requeridos, y este proceso de intercambio en sí requiere puertas de dos qubits. Este intercambio se realiza en un proceso llamado "transpilación", un proceso complejo que también sirve para otros propósitos; esto se abordará con más detalle en la próxima lección. La cantidad limitante relevante es, por lo tanto, la profundidad transpilada de dos qubits. La profundidad máxima exacta a la que se pueden obtener resultados de alta precisión depende del circuito. Sin embargo, con las técnicas modernas de mitigación de errores, se pueden lograr resultados de alta precisión con profundidades transpiladas de dos qubits de 80 o más.
Asignación – Planificación de trabajos (Scheduling)
El scheduling es el proceso de asignación de recursos a programas y la gestión de su ejecución. Esto incluye:
- Envío de trabajos: El proceso mediante el cual un usuario envía una solicitud (trabajo) al sistema HPC, especificando qué trabajo de cómputo y qué recursos se necesitan para la ejecución.
- Asignación de recursos: La asignación de recursos disponibles del sistema HPC (como nodos, CPU, memoria) a un trabajo enviado según sus requisitos.
- Ejecución de trabajos: La ejecución real de las tareas de cómputo definidas por el trabajo en los recursos HPC asignados.
Hay equivalentes de todos estos procesos para computadoras cuánticas.
- Los trabajos son presentados por el usuario, aprovechando IBM Quantum Compute Service, y típicamente usando un primitivo IBM Quantum, como
Sampler,Estimator, u otros. - El usuario selecciona de una lista de backends a los cuales tienen acceso. La lista completa de backends disponibles puede verse en la página Compute resources en IBM Quantum Platform. Es común simplemente usar la computadora cuántica menos ocupada. Pero hay casos donde podría ser importante usar una específica por consideraciones del diseño del dispositivo, replicación de cálculos anteriores, y así sucesivamente.
- La ejecución de trabajos cuánticos es similar al caso HPC. Aunque algunas diferencias ya han sido esbozadas, algunas valen la pena repetirse aquí. Las QPU generalmente no están ubicadas en el mismo nodo que recursos de cómputo clásico sino conectadas a través de una red. Esto podría tener implicaciones de scheduling. Además, computadoras cuánticas podrían tener tiempos de espera en cola sustanciales, y estos tiempos de espera varían, dificultando control preciso de timing. Esta situación podría ser diferente para sistemas dedicados; eso depende de la administración interna de la computadora cuántica.
Control/Gestión – Gestión de cargas de trabajo
La gestión de cargas de trabajo, también llamada orquestación, es el proceso de gestionar múltiples programas y sus requisitos de recursos. Esto incluye:
- Aprovisionamiento de recursos: El proceso de preparación y puesta a disposición de recursos HPC para su uso por los trabajos, incluyendo la configuración de hardware y software. Como veremos más adelante, las QPU son recursos de cómputo que pueden aprovisionarse de manera similar a los recursos HPC clásicos, con las restricciones de la sección anterior.
- Planificación de trabajos (Job Scheduling): La actividad del software de planificación que decide qué trabajos se ejecutan, cuándo y en qué recursos, gestionando prioridades y colas para utilizar el sistema HPC de manera eficiente. Aunque esta declaración de alto nivel se aplica a los recursos cuánticos, el control sobre el timing puede ser menos preciso que con otros recursos.
 Example:
Consideremos una tarea conocida como contexto para comprender la gestión de recursos: la búsqueda de los factores primos de números grandes. Supongamos además que el algoritmo utilizado se basa en la verificación bruta de cada posible divisor. Aunque a menudo este no es el método más eficiente, es fácil entender cómo podría gestionarse la carga de trabajo.
Planificación – Estimación de recursos
-
Estima cuánto tiempo de CPU y memoria podría necesitar la factorización en primos.
-
Planifica la paralelización de tu tarea: ¿cuántas CPU/núcleos vas a utilizar?
Asignación – Scheduling
-
En el envío del trabajo, el scheduler asigna núcleos de CPU y memoria a la tarea de factorización en primos. Por ejemplo, podría asignar todos los divisores potenciales que terminan en los dígitos
1, 3, 7, 9a cada uno de cuatro núcleos. -
Ejecución del trabajo: El algoritmo de factorización en primos se ejecuta, realizando divisiones u otros pasos de factorización en los recursos asignados hasta que la tarea se completa.
Control/Gestión – Gestión de cargas de trabajo
-
El sistema orquesta el orden y el timing de los trabajos de factorización en primos para optimizar el rendimiento.
-
El caso más simple imaginable es que uno de los núcleos encuentre el factor primo buscado. Esto debería detener el cálculo en los otros núcleos para que puedan utilizarse para la siguiente tarea.
Los entornos de computación de alto rendimiento utilizan software especializado para llevar a cabo estos pasos y gestionar los recursos. En la siguiente sección, conoceremos un sistema de gestión de recursos ampliamente utilizado: Slurm.
Ejemplo con recursos cuánticos:
Un flujo de trabajo que será tema de otras lecciones en este curso es la determinación de estados fundamentales y energías químicas mediante Sample-Based Quantum Diagonalization (SQD). Esto se trata con más detalle en la Lección 4; también puedes visitar este curso sobre SQD y métodos relacionados en IBM Quantum Learning. Todo lo que necesitamos saber para esta discusión es que el flujo de trabajo incluye:
- Preparación de un circuito cuántico
- Medición del circuito cuántico
- Uso de los resultados de la medición para proyectar el problema en un subespacio útil
- Diagonalización de una matriz más pequeña y proyectada con recursos de cómputo clásicos
- Iteración, ya sea para garantizar la autoconsistencia mediante consideraciones como la conservación de la carga, y posibles iteraciones del circuito cuántico si tiene parámetros variacionales.
Planificación – Estimación de recursos
-
Asigna los orbitales electrónicos a qubits para determinar el número de qubits necesarios.
-
Combina el hamiltoniano mapeado del sistema y el estado (posiblemente variacional) en un circuito cuántico y verifica la profundidad transpilada de dos qubits. Asegúrate de que tenga sentido.
-
Estima el tamaño del subespacio en el que proyectarás; a partir de esto, estima cuánto tiempo de CPU y memoria podría necesitar la diagonalización.
-
Planifica la paralelización de tu tarea: ¿cuántas CPU/núcleos vas a utilizar?
Asignación – Scheduling
-
El usuario selecciona la QPU; el proceso de transpilación asigna automáticamente los qubits de tu circuito cuántico abstracto a qubits físicos en la QPU. Esto es importante, ya que el circuito abstracto puede asumir una conectividad directa que no está presente en el chip, entre otras cosas.
-
Al presentar el trabajo vía Quantum Compute, el trabajo entra en la cola de la QPU seleccionada. El usuario no tiene control sobre el tiempo de espera en cola, aunque esto podría ser diferente para sistemas dedicados.
-
Los recursos de cómputo clásicos esperan los resultados cuánticos.
-
Se envía un trabajo de diagonalización a los recursos HPC; al enviar el trabajo, el scheduler asigna núcleos de CPU y memoria a la tarea de diagonalización.
-
Ejecución del trabajo: El algoritmo de diagonalización se ejecuta y diagonaliza la matriz proyectada más pequeña hasta que la tarea se completa.
Control/Gestión – Gestión de cargas de trabajo
-
El sistema orquesta el orden y el timing de los pasos cuánticos y clásicos de principio a fin. Por ejemplo, si la matriz proyectada se ha diagonalizado y se ha obtenido una energía del estado fundamental, el flujo de trabajo puede volver a un nuevo circuito cuántico (con un nuevo parámetro variacional) dependiendo de los criterios de convergencia.
-
Si los criterios de convergencia se cumplen con la energía del estado fundamental, el cálculo se detiene en todos los núcleos.
Los entornos de computación de alto rendimiento utilizan software especializado para llevar a cabo estos pasos y gestionar los recursos. En la siguiente sección, conoceremos un sistema de gestión de recursos ampliamente utilizado: Slurm. Es importante señalar que Slurm no proporciona herramientas para todos los pasos descritos anteriormente. Slurm no ofrece soporte para la planificación de trabajos ni para la gestión detallada de cargas de trabajo como la comunicación entre componentes de cargas de trabajo. Esto encaja bien con el estado actual de la computación cuántica en HPC, ya que las QPU típicamente son accesibles a través de la red.
Preguntas de comprensión
Supón que estás intentando buscar en una base de datos desordenada para encontrar un elemento al que llamaremos el 'objetivo'. Para cada una de las siguientes acciones, indica a qué etapa de la gestión de recursos corresponde:
(a) Estimar el tamaño de la base de datos y el tiempo necesario para verificar cada elemento
(b) Asegurarse de que encontrar el objetivo en una GPU detenga el proceso en las demás GPUs para liberarlas para el siguiente problema
(c) Dividir el espacio de búsqueda en regiones para cada una de tus (digamos 10) GPUs para buscar
Respuesta
(a) Planning
(b) Controlando/gestionando
(c) Asignando/programando
Software: Slurm
En esta sección, aplicamos los conceptos aprendidos en este capítulo para utilizar en la práctica el popular sistema de gestión de recursos Slurm.
Introducción a Slurm
Slurm es un sistema de gestión de recursos de código abierto ampliamente utilizado en entornos de computación de alto rendimiento. Proporciona un conjunto completo de herramientas para la gestión de recursos, la planificación de trabajos y la supervisión del rendimiento del sistema.
Cubriremos los conceptos básicos del uso de Slurm, incluyendo:
- Envío de trabajos
- Asignación de recursos
- Supervisión de trabajos
Dado que es realmente difícil proporcionar recursos HPC a cada estudiante de este curso, hacemos un poco de trampa y te proporcionamos un repositorio con imágenes Docker que imitan un clúster HPC real con Slurm a pequeña escala. Esto nos ayuda a practicar los conceptos aprendidos en entornos seguros y reproducibles.
Tenga en cuenta que actualmente todos los recursos cuánticos y clásicos se asignan por la duración de todo el experimento. Actualmente no hay asignación intercalada de recursos mixtos. Una advertencia final es que incluso una vez que el trabajo se inicia, el sistema cuántico no será directamente controlado como un usuario HPC frecuente podría esperar. El trabajo se inicia en un nodo x86 arbitrario, que ejecuta IBM Quantum Compute Service y ese servicio en tiempo de ejecución se conecta a otro planificador sobre el cual el usuario no tiene control directo. Este flujo de trabajo y problemas relacionados podría ser conocido por usuarios de HPC que tuvieron experiencia temprana buscando acceso exclusivo a nodos GPU (el uso original de gres).
Instrucciones de instalación y descripción general de la configuración
Para practicar la combinación de recursos cuánticos y HPC, necesitas tener acceso a un entorno HPC real o simular un entorno HPC en tu máquina local. Puedes encontrar instrucciones de instalación para la configuración local con Docker en este repositorio. Las instrucciones hacen referencia a ayuda para configurar una cuenta de IBM Cloud® e instalar el plugin SPANK para QRMI. También en este repositorio se encuentran varios archivos Python para probar tu entorno.
Después de completar la instalación, verificamos los recursos de cómputo de Slurm en tu terminal con el siguiente comando. Si la instalación fue exitosa, deberías poder confirmar un total de tres nodos virtuales.
$ sinfo

PARTITION AVAIL TIMELIMIT NODES STATE NODELIST
normal      up 5-00:00:00     2  idle c[1-2]
quantum*    up   infinite     1  idle q1
$ scontrol show node

NodeNAME=q1 Arch=x86_64 CoresPerSocket=1
CPUAlloc=0 CPUTot=1 CPULoad=0.34
AvailableFeatures=(null)
ActiveFeatures=(null)
Gres=qpu:1
NodeAddr=q1 NodeHostName=q1 Version=21.08.6
...
Tenemos dos particiones o grupos de nodos: normal y quantum. La partición normal consiste en nodos que solo tienen acceso a recursos clásicos. La partición quantum tiene acceso a recursos cuánticos. Puedes ver los detalles de cada nodo ejecutando scontrol show nodes.
Ejecuta un ejemplo sencillo "Hello World" en Slurm
Ejecutemos primero un ejemplo clásico sencillo de hello world con Slurm. Usaremos Python para los ejemplos. Creemos hello_world.py, que se explica por sí mismo.
$ vim hello_world.py

import time
time.sleep(10)
print("Hello, World!")
~
Ahora debemos indicar al gestor de recursos qué recursos necesitamos para ejecutar este programa. Slurm ofrece una forma de especificar todos los metadatos del trabajo a través de un script de envío, que es simplemente un script de shell con anotaciones específicas de Slurm. Estas anotaciones te permiten especificar requisitos de recursos, parámetros de planificación y más. Creemos un script de shell hello_world.sh para esto.
$ vim hello_world.sh

#SBATCH --job-name=hello-world
#SBATCH --output=hello-world.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=normal

srun hello_world.py
~
Veamos el archivo de envío y analicemos lo que está pasando.
Las directivas #SBATCH son anotaciones específicas que indican los requisitos que tenemos para la ejecución del programa. Aquí puedes especificar la cantidad de recursos —el número de nodos, el número de tareas por nodo, el número de tareas y CPU por nodo y tarea— y otras opciones como el nombre del archivo de salida. Una lista completa de opciones está disponible en la documentación de Slurm.
Ahora es momento de ejecutar nuestro trabajo en Slurm. sbatch es un comando que acepta un archivo de envío y pone el trabajo en cola para su ejecución en Slurm.
$ sbatch hello_world.sh

Submitted batch job 63
Verifiquemos el estado de nuestro programa con el comando squeue.
$ squeue

#             JOBID PARTITION     NAME         USER ST       TIME  NODES NODELIST(REASON)
#                 1 main          hello_world  root R        0:01      1 c1
Una vez completado el trabajo, podemos verificar el resultado en el archivo de salida.
$ cat hello_world_logs.txt
Hello, World!
Preguntas de comprensión
Dado el siguiente script de shell de Slurm: ¿Cuál es (a) el nombre del trabajo, (b) el nombre del archivo Python y (c) el nombre del archivo de salida? (d) ¿Podría este script utilizar recursos cuánticos o no?
vim hello_learner.sh

#SBATCH --job-name=hello-learner
#SBATCH --output=hello-learner.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=quantum

srun hello_learner_qm.py
Respuesta
(a) hello-learner
(b) hello-learner_qm.py
(c) hello-learner.out
(d) Sí, podría. Está utilizando la partición cuántica.
Ejecuta un ejemplo sencillo de Qiskit "Hello World" en Slurm
A continuación, intentemos utilizar también recursos cuánticos. Creemos y lancemos un programa sencillo "Hello, Qiskit" que utilice recursos cuánticos.
$ vim hello_qiskit.py
# hello_qiskit.py
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import EstimatorV2 as Estimator

# Create a new circuit with two qubits
qc = QuantumCircuit(2)

# Add a Hadamard gate to qubit 0
qc.h(0)

# Perform a controlled-X gate on qubit 1, controlled by qubit 0
qc.cx(0, 1)

observables_labels = ["IZ", "IX", "ZI", "XI", "ZZ", "XX"]
observables = [SparsePauliOp(label) for label in observables_labels]

# switch to QRMI service
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()

backend = service.backend("...")

# Convert to an ISA circuit and layout-mapped observables.
pm = generate_preset_pass_manager(backend=backend, optimization_level=1)
isa_circuit = pm.run(qc)

# Construct the Estimator instance.

estimator = Estimator(mode=backend)
estimator.options.resilience_level = 1
estimator.options.default_shots = 5000

mapped_observables = [
    observable.apply_layout(isa_circuit.layout) for observable in observables
]

# One pub, with one circuit to run against five different observables.
job = estimator.run([(isa_circuit, mapped_observables)])

job_result = job.result()

pub_result = job.result()[0]

print("Result", pub_result)
Aquí utilizamos el Quantum Resource Management Interface (QRMI), un plugin SPANK de Slurm para el soporte de recursos y trabajos cuánticos, desarrollado conjuntamente por IBM, Pasqal, el Hartree Centre y RPI. Hemos creado un circuito Pauli-2-Design sencillo con valores iniciales aleatorios y un observable simple, y lo ejecutamos con el Estimator para obtener el valor esperado. Para ejecutarlo, necesitamos nuevamente el script de envío hello_qiskit.sh, que incluye recursos cuánticos como requisito.
$ vim hello_qiskit.sh

#SBATCH --job-name=hello-qiskit
#SBATCH --output=hello_qiskit.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-nodes=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=quantum
#SBATCH --gres=qpu:1

srun python /data/ch2/hello_qiskit/hello_qiskit.py
~
Traigamos el archivo de envío y veamos qué está sucediendo allí. Tenemos una nueva opción, que es gres. gres es una opción de Slurm para definir recursos computacionales adicionales. En nuestro caso, este nuevo recurso sería nuestro recurso cuántico. Dado que especificamos los recursos y la partición de nuestro clúster donde están disponibles recursos cuánticos, nuestros primitivos IBM Quantum usarán estos recursos asignados para ejecutar el payload cuántico.
Ahora es momento de ejecutar nuestro trabajo en Slurm.
$ sbatch hello_qiskit.sh
Luego verificamos el estado de nuestro programa con el comando squeue.
$ squeue
#             JOBID PARTITION     NAME         USER ST       TIME  NODES NODELIST(REASON)
#                 1 main          hello_qiskit  root R        0:01      1 q1
Podemos explorar los registros y resultados después de completar el trabajo.
$ cat hello_qiskit.out | grep Exp
Expectation Value: 0.8372900070983516
Resumen
Hasta ahora hemos aprendido qué son los recursos de cómputo y cómo utilizarlos para ejecutar programas en entornos heterogéneos. También hemos creado y ejecutado dos programas sencillos "Hello World": uno para un recurso clásico y otro para un recurso cuántico. Además, hemos aprendido cómo crear scripts de shell para enviar tareas y visualizar resultados.
En la siguiente lección, utilizaremos este conocimiento sobre el control de recursos para aplicar modelos de programación a los recursos que hemos adquirido durante la ejecución de trabajos.
Todo el código y los scripts de este capítulo están disponibles para ti en nuestro repositorio de GitHub.