Posselección con comprobaciones de errores no markovianos
Esta guía explica qué son las comprobaciones de errores no markovianos y cómo implementarlas en software con qiskit-mitigation. Empezarás con un pequeño ejemplo de dos qubits para visualizar las comprobaciones y comentar cómo funcionan. Después de desarrollar algo de intuición, probarás un ejemplo de 20 qubits en el que implementarás comprobaciones y compararás varias estrategias de posselección.
¿Qué son las comprobaciones de errores no markovianos?
Las comprobaciones de errores no markovianos son pruebas basadas en mediciones que determinan si el estado de un qubit probablemente está dañado por una fuente de error no markoviana. Esta prueba se realiza colocando en cada qubit, al principio del circuito, una puerta de inversión de bit de duración extendida (xslow o una serie de puertas rx con ángulo ), seguida de una XGate normal y midiendo para asegurar que el estado se invirtió correctamente de . Esta prueba también puede realizarse al final del circuito, después de cada medición terminal, para asegurar que el dispositivo puede invertir con éxito el estado medido del qubit de . Las muestras asociadas a comprobaciones fallidas pueden considerarse poco fiables, y posseleccionar solo las muestras que superan todas las comprobaciones puede aumentar la fidelidad de la distribución ruidosa.
Estrategias de posselección basadas en comprobaciones de errores no markovianos
-
Posselección basada en nodos: posselecciona solo las muestras en las que cada qubit superó su(s) comprobación(es). Es la estrategia más estricta y generalmente descarta más muestras.
-
Posselección basada en aristas: para cada arista del grafo de acoplamiento de los qubits, asegura que al menos un qubit supere la(s) comprobación(es). Esta estrategia es más indulgente; si un qubit falla una comprobación, la muestra aún puede conservarse si todos sus vecinos superan sus comprobaciones.
Qubits espectadores
Se pueden especificar qubits auxiliares «espectadores» adyacentes a los qubits usados para ejecutar el circuito original. Las comprobaciones de errores no markovianos pueden colocarse en estos espectadores, lo que proporciona mayor cobertura frente al ruido no markoviano que estas comprobaciones están diseñadas para detectar.
Parte 1. Visualiza las comprobaciones de errores no markovianos
Antes de demostrar la técnica en un QPU, crearás un pequeño circuito de dos qubits y añadirás comprobaciones para visualizar cómo funciona. Empieza con un estado de Bell transpilado al QPU del backend ibm_kingston.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

Añade algunas comprobaciones de errores no markovianos al principio del circuito. Las comprobaciones solo se colocarán en los qubits que terminan con una medición. Estas comprobaciones aseguran que el dispositivo puede invertir con éxito el estado inicial del qubit de , y las mediciones de estas comprobaciones se leen en un nuevo registro clásico llamado meas_pre.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

De forma similar, puedes añadir comprobaciones al final del circuito, después de cada medición terminal. Estas comprobaciones aseguran que el dispositivo puede invertir el estado del qubit de , y sus mediciones se leen en un nuevo registro clásico llamado meas_ps.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

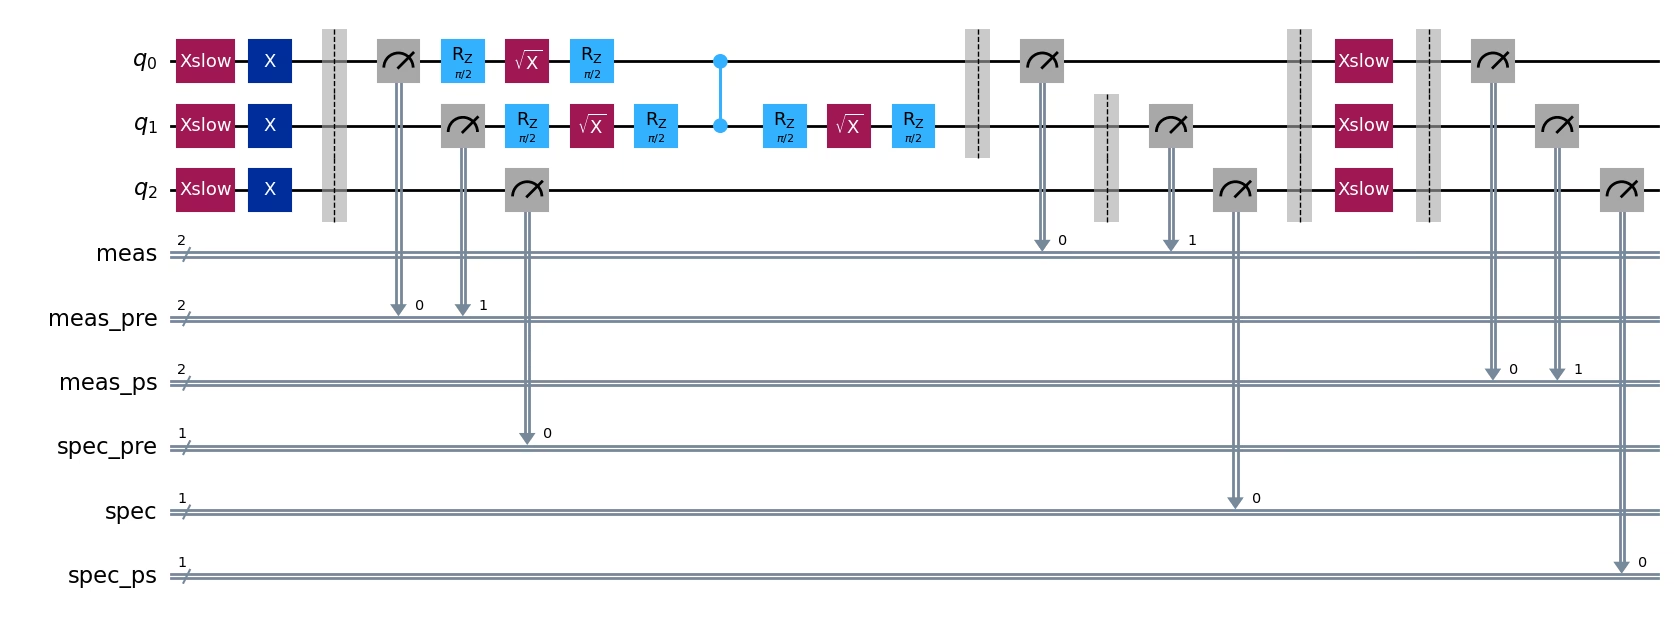
Como se mencionó en la introducción, puedes usar qubits ancilla adyacentes a los qubits de datos como "espectadores" para obtener más cobertura de errores. Agrega comprobaciones de espectador previas y posteriores al circuito. Puedes ver que, como el qubit físico 2 de ibm_kingston es adyacente al qubit de datos 1, se ha agregado como espectador, y se le han añadido comprobaciones previas y posteriores al circuito. Las mediciones de los espectadores se han agregado a nuevos registros clásicos llamados spec_pre y spec.
Un circuito como este contiene todas las posibles comprobaciones de errores no markovianos, por lo que muestrear este circuito permite a los usuarios aplicar postselección según cualquier combinación de comprobaciones [previas/posteriores] al circuito y estrategias de postselección basadas en [nodos/aristas]. Consulta la Parte 2 de esta guía para ver cómo funciona en hardware cuántico.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
Parte 2: Demostrar las comprobaciones de errores no markovianos en una QPU y comparar estrategias de postselección
Ahora que entiendes qué son las comprobaciones de errores no markovianos y cómo se implementan en software, puedes ejecutar un ejemplo más grande en una QPU y ver cómo funciona. Primero, prepara un circuito. La elección del circuito no es muy importante; solo necesitas un circuito cuyo resultado puedas verificar fácilmente. Aquí elegimos un circuito de Ising espejado 1D de 20 qubits. Este circuito no es trivial de ejecutar en hardware y debería verse afectado por errores no markovianos, lo que brinda la oportunidad de demostrar la eficacia de las comprobaciones de errores no markovianos. Además, la estructura espejada nos permite comparar de forma trivial los cálculos de valores esperados con ruido frente a los valores exactos.
En este experimento calculamos valores esperados de observables. La elección del observable tampoco es importante, así que simplemente elegimos la magnetización media por sitio .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
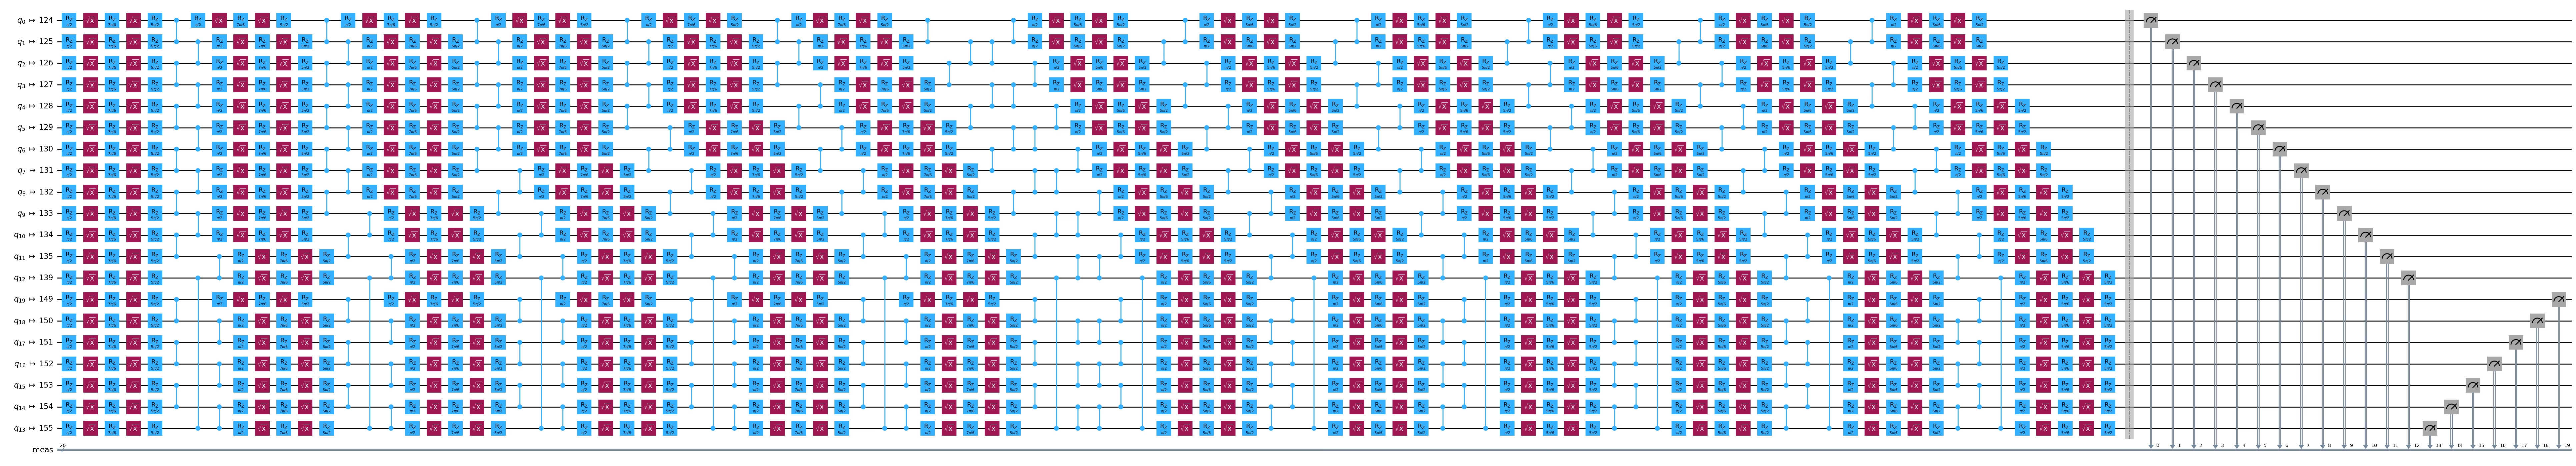
Ahora agregamos comprobaciones previas y posteriores al circuito en cada qubit, incluidos los siete qubits espectadores adyacentes. Cuando agregas todas las comprobaciones posibles a un circuito, puedes decidir qué estrategia de postselección usar durante el posprocesamiento.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
Usa la primitiva Executor para muestrear el circuito que contiene las comprobaciones.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
La clase PostSelector conoce la estructura de creg de las comprobaciones, por lo que puede asociar cada bit de las muestras con su medición de circuito correspondiente. Su método compute_mask puede usarse para crear una máscara sobre una secuencia de muestras, dados la estrategia de postselección (nodo o arista) y el tipo de comprobaciones de errores no markovianos que se deben considerar (previas o posteriores al circuito). Para combinar las estrategias previas y posteriores al circuito en una sola máscara, se pueden calcular sus máscaras de forma independiente y luego combinarlas con la operación AND. Aquí usamos PostSelector para crear máscaras para todas las estrategias y observamos los resultados con cada permutación de estrategias disponible.
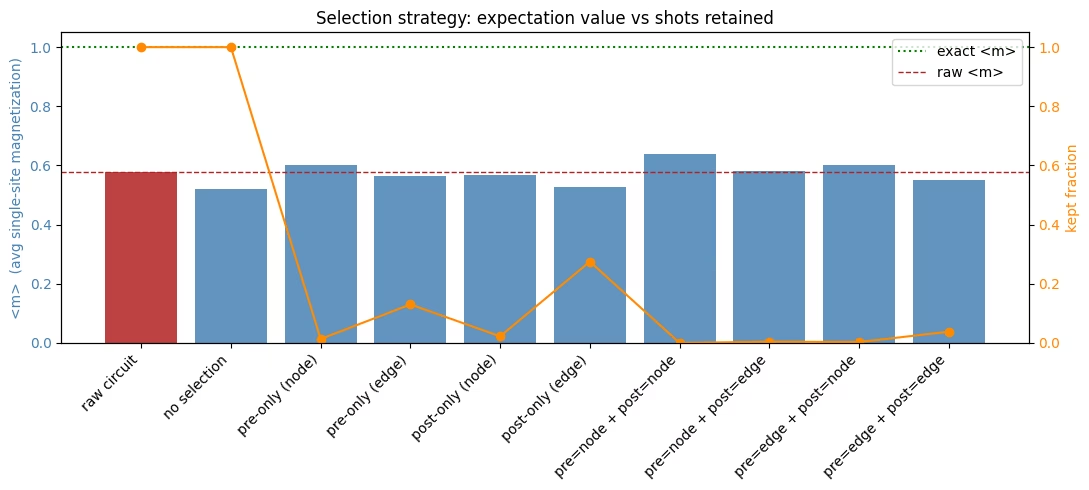
En la visualización siguiente vemos cómo la estrategia de postselección afecta a la tasa de postselección, así como a la calidad de la respuesta. Como era de esperar, las estrategias que usan postselección basada en nodos dieron las tasas de postselección más bajas. Las estrategias basadas en aristas son más permisivas y tienden a dar tasas de postselección más altas. Los usuarios deberían experimentar con las distintas estrategias en su problema para determinar el equilibrio adecuado entre la tasa de postselección y la calidad de la distribución muestreada. En este ejemplo, usar postselección basada en nodos con las comprobaciones previas y posteriores al circuito dio la mejor respuesta con una tasa de postselección de .028%. Algunas de las estrategias no superaron al circuito sin procesar. También puedes ver que agregar las comprobaciones pero no usar ninguna (barra etiquetada "no selection" en el gráfico siguiente) es lo que peor funciona.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)