PEC con SLC
La cancelación probabilística de errores (PEC) es una técnica para mitigar el ruido cuántico en el cálculo de valores esperados de observables. Te permite calcular una estimación insesgada de los valores esperados. Esta técnica funciona ejecutando un conjunto de circuitos ruidosos en los que se inyecta la inversa de un modelo de ruido aprendido. Luego, el modelo de ruido se aproxima a un canal de Pauli mediante Pauli twirling (también conocido como compilación aleatorizada). Estos modelos de ruido pueden aprenderse de forma eficiente y mitigarse mediante PEC (consulta Probabilistic error cancellation with sparse Pauli-Lindblad models on noisy quantum processors para más detalles).
PEC requiere una sobrecarga exponencial de shots para calcular una estimación insesgada. Shaded Lightcones (SLC) es una técnica que usa recursos clásicos para acotar la sensibilidad a los errores a lo largo del circuito. Con estas cotas, el usuario puede ajustar de forma controlada el sesgo en la estimación del observable.
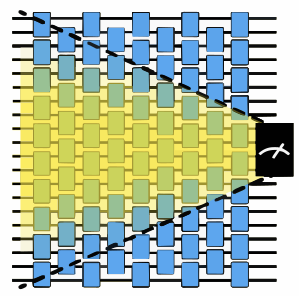
Esta guía muestra cómo usar PEC combinado con SLC para mitigar el ruido de las puertas con una sobrecarga de shots reducida en comparación con PEC estándar.
El flujo de trabajo es el siguiente:
- Especifica un circuito y un observable.
- Calcula valores esperados con ruido y sin mitigar.
- Calcula cotas hacia adelante y hacia atrás del sesgo.
- Aprende el ruido de las capas de entrelazamiento usando qiskit-noise-learning.
- Usa el ruido aprendido para fusionar las cotas calculadas en una matriz de escalas locales.
- Elige la cota de sesgo deseada según el compromiso entre sobrecarga de shots y sesgo.
- Prepara un programa PEC + SLC, ejecútalo y haz el posprocesamiento.
- Compara los valores esperados mitigados y la sobrecarga de shots.
Especifica un circuito y un observable
Prepara un circuito espejo de una evolución temporal con Trotter del hamiltoniano de una cadena de Ising 1D en ocho qubits. Refleja el circuito para cancelar su unitaria y formar un circuito identidad, de modo que el valor esperado ideal de cada observable sea 1 sin necesidad de calcularlo. Además, el espejado duplica la profundidad del circuito, lo que a su vez duplica el efecto del ruido.
Usa el ángulo para que la dinámica no sea de Clifford.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_slc": "qiskit-addon-slc", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "qiskit_noise_learning": "qiskit-noise-learning", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
from qiskit.circuit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_mitigation.utils import get_measurement_bases

warnings.filterwarnings("ignore")

def construct_ising_circuit(
    num_qubits: int,
    num_trotter_steps: int,
    rx_angle: float,
) -> QuantumCircuit:
    circuit = QuantumCircuit(num_qubits)

    for _ in range(num_trotter_steps):
        circuit.rx(rx_angle, range(num_qubits))
        for first_qubit in (1, 2):
            for idx in range(first_qubit, num_qubits, 2):
                # equivalent to Rzz(-pi/2):
                circuit.sdg([idx - 1, idx])
                circuit.cz(idx - 1, idx)

    return circuit

def prepare_basis(
    circuit: QuantumCircuit, basis: list[int]
) -> QuantumCircuit:
    # basis is a list of integer values from 0 to 3. These map to the basis measurement as:
    # 0 = I; 1 = Z; 2 = X; 3 = Y
    assert len(basis) == circuit.num_qubits

    out_circ = circuit.copy_empty_like()
    for qb, bas in enumerate(basis):
        if bas == 2:
            out_circ.h(qb)
        elif bas == 3:
            out_circ.rx(-np.pi / 2, qb)

    out_circ.barrier()
    out_circ.compose(circuit, inplace=True)
    return out_circ

def mirror_circuit(circuit: QuantumCircuit) -> QuantumCircuit:
    mirror_circ = circuit.copy_empty_like()
    mirror_circ.compose(circuit.inverse(), inplace=True)
    mirror_circ.barrier()
    mirror_circ.compose(circuit, inplace=True)
    mirror_circ.measure_active()
    return mirror_circ

# define observables
num_qubits = 8  # Width of the Ising chain
# The observable to measure: one X component (on qubit 2) and one Z component (on qubit 5)
target_obs_sparse = [("XZ", [2, 5], 1.0)]
observable = SparsePauliOp.from_sparse_list(
    target_obs_sparse, num_qubits=num_qubits
)

# Determine the measurement basis each qubit requires for this observable.
bases, _ = get_measurement_bases(observable)

# Instantiate the mirrored circuit and prepend the basis-preparation gates
num_trotter_steps = 6
rx_angle = np.pi / 4
circuit = construct_ising_circuit(num_qubits, num_trotter_steps, rx_angle)
mirrored_circuit = mirror_circuit(circuit)
mirrored_circuit = prepare_basis(mirrored_circuit, bases[0])
print("Visualization of 1 mirrored Trotter step")
prepare_basis(
    mirror_circuit(construct_ising_circuit(num_qubits, 1, rx_angle)), bases[0]
).draw("mpl", scale=0.6, fold=-1)
Visualization of 1 mirrored Trotter step

Calcula valores esperados con ruido y sin mitigar
Un QuantumProgram contiene un circuito cuántico y un samplex en un formato adecuado para la primitiva Executor. MitigationTask.prepare construye un QuantumProgram a partir del circuito, los observables y los valores de los parámetros, y agrupa el circuito en cajas con las opciones de boxing indicadas. Establece la opción de boxing measure_annotations en "change_basis" para rotar las mediciones a las bases requeridas, y añade add_tags: "unique_box" para que el simulador pueda asignar un modelo de ruido a las cajas del circuito. El programa se somete a Pauli twirling por defecto, lo que en hardware convierte el ruido coherente en el ruido de Pauli que asumen los métodos de mitigación. num_randomizations establece cuántas instancias con twirling de cada circuito se muestrean y shots_per_randomization establece cuántos shots recibe cada instancia, de modo que su producto es el límite de shots por circuito.
Si tienes acceso a QPU, puedes ejecutar el programa con un Executor creado a partir de un backend de QiskitRuntimeService. Este ejemplo usa un AerSimulator para ejecutar el programa localmente. Su opción de simulador layer_noise_model inyecta ruido a partir de un modelo de ruido de Pauli-Lindblad dado en cada capa de puertas de entrelazamiento. Aquí generamos un modelo de ruido de Pauli-Lindblad aleatorio con un error por puerta en capa (EPLG) de 0.01, casi un orden de magnitud superior al de los QPU Heron actuales típicos, para magnificar el efecto de usar SLC también en un problema de pequeña escala.
from qiskit.circuit import CircuitInstruction
from qiskit.quantum_info import PauliLindbladMap, pauli_basis
from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import Executor
from qiskit_mitigation import MitigationTask, find_combined_unique_layers
from samplomatic import Tag
from samplomatic.utils import get_annotation

def generate_random_pauli_lindblad_noise(
    layers,
    num_qubits: int,
    eplg: float = 3e-3,
    seed: int | None = None,
) -> list[tuple[CircuitInstruction, PauliLindbladMap]]:
    """Generate random Pauli-Lindblad noise over the full Pauli basis."""
    layer_noise_model = []
    for layer in layers:
        layer_instructions = layer.operation.params[0]
        contain_measurement = any(
            inst.name.startswith("measure") for inst in layer_instructions
        )
        if contain_measurement:  # do not add measurement noise
            layer_noise = PauliLindbladMap.identity(num_qubits)
        else:
            edges = [
                (inst.qubits[0]._index, inst.qubits[1]._index)
                for inst in layer_instructions
            ]  # extract the edges of the layer

            basis_paulis = [p for p in pauli_basis(2) if np.sum(p.x + p.z)]
            rng = np.random.default_rng(seed=seed)
            num_generators = len(basis_paulis)
            rates = rng.random(len(basis_paulis)) * eplg / num_generators

            layer_noise = PauliLindbladMap.from_sparse_list(
                [
                    (pauli.to_label(), edge, rate)
                    for pauli, rate in zip(basis_paulis, rates, strict=True)
                    for edge in edges
                ],
                num_qubits=num_qubits,
            )
        layer_noise_model.append((layer, layer_noise))
    return layer_noise_model

num_randomizations = 400
shots_per_randomization = 16

boxing_options = {"add_tags": "unique_box"}

# find the unique layers to generate the layered noise for
box_layers = find_combined_unique_layers(
    [mirrored_circuit], custom_boxing_options=boxing_options
)
layer_noise_model = generate_random_pauli_lindblad_noise(
    box_layers, num_qubits, eplg=1e-2, seed=42
)

# a local noisy simulator in place of a QPU backend
noisy_executor = Executor(
    AerSimulator(),
    options={"simulator": {"layer_noise_model": layer_noise_model}},
)

task = MitigationTask()
program = task.prepare(
    circuit=mirrored_circuit,
    observables=observable,
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
)

program._semantic_role = "simulation"  # flag the program for the simulator
job_unmit_res = noisy_executor.run(program).result()
unmitigated_res = task.postprocess(job_unmit_res)

print(f"unmitigated result: {unmitigated_res.data.evs[0]}")
unmitigated result: 0.63125
Calcula cotas hacia adelante y hacia atrás del sesgo
Antes de gastar tiempo de QPU en el aprendizaje del ruido, SLC usa simulación clásica para acotar la contribución de cada posible error al sesgo del observable. Esto se hace en dos pasadas complementarias:
-
Propagación hacia adelante: cada error de Pauli se propaga hacia adelante a través del resto del circuito y se evalúa su conmutador con el observable. Un error que anticonmuta con el observable es el único tipo que puede sesgar el resultado, por lo que esta pasada produce una cota superior del impacto hacia adelante de cada error.
-
Propagación hacia atrás: cada error se propaga hacia atrás hasta el inicio del circuito y se evalúa su conmutador con el estado inicial. Como el circuito empieza en el estado todo cero, los errores que conmutan con él no pueden afectar al resultado, lo que ajusta la cota desde la otra dirección.
Las dos cotas juntas forman un intervalo ajustado alrededor de la contribución del peor caso de cada error al sesgo. En el siguiente paso, estas cotas se fusionan con las tasas de ruido aprendidas para clasificar qué errores merece la pena corregir y cuáles pueden dejarse sin corregir con seguridad. Aquí es necesaria la opción de boxing inject_noise_strategy="individual_modification" para que cada anotación InjectNoise del circuito en cajas tenga una identidad única a la que puedan asociarse las cotas de SLC.
En problemas de mayor escala, estos cálculos pueden requerir recursos computacionales clásicos considerables.
from qiskit_addon_slc.bounds import (
    compute_backward_bounds,
    compute_forward_bounds,
    tighten_with_speed_limit,
)
from qiskit_mitigation import PEC

slc_boxing_options = {
    "add_tags": "unique_box",
    "inject_noise_strategy": "individual_modification",
}

slc_pec_task = PEC()

boxed_circuit, noise_model_paulis = (
    slc_pec_task.generate_slc_bounds_computation_input(
        mirrored_circuit, custom_boxing_options=slc_boxing_options
    )
)

forward_bounds = compute_forward_bounds(
    boxed_circuit, noise_model_paulis, observable
)
tighten_forward_bounds = tighten_with_speed_limit(
    forward_bounds, boxed_circuit, noise_model_paulis, observable
)
backward_bounds = compute_backward_bounds(boxed_circuit, noise_model_paulis)
Aprende el ruido de las capas de entrelazamiento
Para calcular una estimación final de cuánto afecta cada error al sesgo del valor esperado, así como de lo costoso que sería corregirlo, aprendemos las tasas de ruido y las aplicamos a las cotas de ruido predichas que calculamos antes.
PEC (así como PEC+SLC) asume un modelo de ruido con twirling de cada capa de puertas de entrelazamiento del circuito. Si asumes un modelo de ruido markoviano, se supone que la profundidad del circuito no afecta al canal de ruido de una capa de entrelazamiento dada. Por lo tanto, solo debe aprenderse el modelo de ruido de cada capa única de puertas de entrelazamiento. El circuito usado en esta guía puede dividirse en dos capas únicas. Diseñar circuitos con un conjunto mínimo de capas de entrelazamiento únicas es importante si quieres aprender un modelo de ruido, ya que las capas únicas deben aprenderse de forma independiente. Si tu circuito tiene demasiadas capas únicas, el aprendizaje del ruido puede resultar inviable debido al coste de muestreo de aprender muchas capas.
Se usa qiskit-noise-learning para aprender el ruido. El aprendiz repite cada capa fragment_depths veces en sus circuitos de aprendizaje, aplica twirling a cada circuito num_randomizations veces y ajusta el decaimiento de las fidelidades medidas a un modelo de Pauli-Lindblad. Estos parámetros pueden afectar a la precisión del modelo aprendido. Cuanto más preciso sea el modelo de ruido aprendido, más precisa será la cancelación del ruido.
El siguiente código dibuja el modelo de ruido aprendido con las dos capas fusionadas en un solo mapa. Cada qubit es un gráfico circular con sus tasas X, Y y Z de peso 1 sumadas sobre las dos capas, y cada arista muestra las tasas de peso 2 aprendidas. Por ejemplo, una tasa de 3e-4 significa que ese error ocurre aproximadamente en tres de cada 10 000 usos de la capa.
from qiskit.providers.fake_provider import GenericBackendV2
from qiskit.quantum_info import PauliList
from qiskit_ibm_runtime.results import LayerError, PauliLindbladError
from qiskit_ibm_runtime.visualization.embeddings import Embedding
from qiskit_noise_learning.aer_executor import AerExecutor
from qiskit_noise_learning.noise_learner import LearningOptions, NoiseLearner
from samplomatic import InjectNoise

line_coupling = [(i, i + 1) for i in range(num_qubits - 1)]
backend = GenericBackendV2(
    num_qubits=num_qubits,
    basis_gates=["id", "rz", "sx", "x", "cz"],
    coupling_map=line_coupling,
)

# first learn only the layers PEC will inject noise into, i.e. not the measurement layer
pec_layers = [
    layer
    for layer in slc_pec_task.find_unique_layers(
        mirrored_circuit, slc_boxing_options
    )
    if get_annotation(layer.operation, InjectNoise)
]
layers = slc_pec_task.find_unique_layers(mirrored_circuit, slc_boxing_options)

learning_options = LearningOptions(
    fragment_depths=[2, 4, 8, 16],
    num_randomizations=250,
    shots_per_randomizations=16,
)

# qiskit-noise-learning is not compatible with the Executor in local mode,
# and requires the simulator present in the package for running simulation
noise_dict = {
    get_annotation(layer.operation, Tag).ref: noise_layer
    for layer, noise_layer in layer_noise_model
}
noise_learner_simulator = AerExecutor(
    qasm_simulator=AerSimulator(), noise_dict=noise_dict
)
learner = NoiseLearner(
    backend, options=learning_options, executor=noise_learner_simulator
)
learned_noise = (
    learner.run(pec_layers).result().to_dict()
)  # keyed by InjectNoise reference

# Draw the learned model on the line, laid out as a line with the qubits in order.
# Composing the two layers' maps sums their rates, giving one map over all the edges.
embedding = Embedding(
    [(0, 0), (0, 2), (0, 4), (2, 4), (4, 4), (4, 2), (4, 0), (2, 0)],
    line_coupling,
)
first, second = learned_noise.values()
learned_model = first.compose(second).simplify()
error = PauliLindbladError(
    PauliList(
        learned_model.get_qubit_sparse_pauli_list_copy().to_pauli_list()
    ),
    learned_model.rates,
)
fig = LayerError(circuit, list(range(num_qubits)), error).draw_map(
    embedding, radius=0.4, height=460, width=620
)
fig.update_traces(
    marker={
        "cmin": 0,
        "cmax": max(learned_model.rates),
        "colorbar": {"tickformat": ".1e", "title": "rate"},
    },
    selector={"mode": "markers"},
)
fig.show()

Usa el ruido aprendido para fusionar las cotas calculadas en la matriz de escalas locales
Con las cotas clásicas (del paso anterior) y las tasas de ruido aprendidas en mano, ya podemos calcular una matriz de escalas locales: un peso por error que determina con qué intensidad debe PEC cancelar cada término de ruido individual.
La idea clave de SLC es que no todos los errores necesitan cancelarse por completo. Un error cuyas cotas hacia adelante y hacia atrás son ambas pequeñas tiene un efecto despreciable sobre el observable, sea cual sea su tasa, por lo que puede dejarse parcial o totalmente sin mitigar. merge_bounds fusiona las cotas clásicas con las tasas de Pauli-Lindblad aprendidas, y luego compute_local_scales asigna a cada error una escala entre 0 (ignorado por completo) y 1 (cancelado totalmente), sujeta a un bias_tolerance especificado por el usuario. Los errores con una gran contribución estimada al sesgo reciben una escala cercana a 1 (tratamiento PEC completo), mientras que los errores con una contribución pequeña reciben una escala menor, lo que reduce la sobrecarga de muestreo que conllevan.
SLC ofrece un control continuo entre los dos extremos: PEC estándar (sesgo cero, sobrecarga máxima) y ninguna mitigación (sobrecarga cero, sesgo de ruido completo). El parámetro bias_tolerance controla este ajuste: establecerlo en 0 recupera PEC completo, mientras que valores mayores permiten más sesgo residual a cambio de una menor sobrecarga de muestreo γ².
Este paso barre bias_tolerance en un rango de valores y calcula la sobrecarga de muestreo resultante para cada uno. Representar estos puntos frente a la sobrecarga de PEC completo te ayuda a elegir un punto de trabajo que se ajuste a tu presupuesto de shots. Por ejemplo, tolerar un 5 % de sesgo residual puede reducir la sobrecarga de muestreo en un orden de magnitud respecto a PEC completo, haciendo viable el cálculo en los QPU actuales cuando de otro modo no lo sería.
import matplotlib.pyplot as plt
from qiskit_addon_slc.bounds import compute_local_scales, merge_bounds

merged_bounds = merge_bounds(
    boxed_circuit,
    tighten_forward_bounds,
    backward_bounds,
    noise_rates=learned_noise,
)

biases = []
costs = []
for bias in [0.0, *np.arange(0.01, 0.11, 0.01).tolist()]:
    _, cost_, bias_ = compute_local_scales(
        boxed_circuit,
        merged_bounds,
        noise_rates=learned_noise,
        bias_tolerance=bias,
    )
    biases.append(bias_)
    costs.append(cost_)

# Compute tha full PEC overhead and compare it with the overhead and bias of different SLC configurations
vanilla_gamma = slc_pec_task.calculate_gamma(
    slc_pec_task.boxed_circuit, learned_noise, 1
)

xticks = np.arange(0, 11, 2)

fig, ax = plt.subplots()
ax.scatter(
    [0], [vanilla_gamma**2], marker="D", c="tab:orange", label="full PEC"
)
ax.plot(
    100 * np.array(biases),
    np.array(costs),
    "o-",
    c="tab:blue",
    label="PEC+SLC",
)
ax.set_xticks(xticks, [f"{x:.2f}" for x in xticks])

ax.set_xlabel("Remaining bias [%]")
ax.set_ylabel(r"Sampling overhead, $\gamma^2$")
ax.grid()
ax.legend()
fig.suptitle("PEC sampling overhead reduction due to SLC")
Optimal spacetime partitioning not implemented! Just partitioning list of noisy boxes.
Text(0.5, 0.98, 'PEC sampling overhead reduction due to SLC')

Elige la cota de sesgo deseada según el compromiso entre sobrecarga de shots y sesgo
En esta guía elegimos una tolerancia de sesgo del 5 %. Ten en cuenta que este cálculo del sesgo se basa en el modelo de ruido aprendido, que puede no estar perfectamente alineado con el ruido real del dispositivo.
chosen_bias_threshold = 0.05
local_scales, sampling_cost, bias = compute_local_scales(
    boxed_circuit, merged_bounds, learned_noise, bias_tolerance=bias
)
slc_pec_task.set_slc_local_scales(
    local_scales, float(np.sqrt(sampling_cost)), bias
)
Prepara un programa PEC + SLC, ejecútalo y haz el posprocesamiento
Con las escalas locales elegidas, podemos construir el programa de ejecución completo PEC+SLC. La llamada a PEC.prepare construye un QuantumProgram que codifica la estrategia de inyección de antirruido en las anotaciones de caja del circuito. Pasar noise_gain="slc_local_scales" indica al executor que use los pesos por error establecidos por set_slc_local_scales, en lugar de aplicar a todos los errores la misma ganancia de ruido inverso completa, como haría PEC estándar.
Para obtener una comparación justa, se prepara una segunda tarea PEC con noise_gain=0, que corresponde a la cancelación PEC completa sin margen de sesgo de SLC. Ambos programas se añaden al mismo QuantumProgram, de modo que comparten un único trabajo de ejecución: sus circuitos se entrelazan y se ejecutan juntos, por lo que cualquier deriva del hardware afecta a ambos por igual.
Una vez completado el trabajo, postprocess convierte las cadenas de bits de medición sin procesar en valores esperados, aplicando el factor de reescalado de PEC γ correspondiente a cada tarea.
program_pec = slc_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=slc_boxing_options,
    noise_maps=learned_noise,  # PEC option
    noise_gain="slc_local_scales",  # PEC option. Defines the usage of SLC
    max_sampling_overhead=100,  # PEC option
)

full_pec_task = PEC()
program_pec = full_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
    quantum_program=program_pec,
    noise_maps=learned_noise,  # PEC option
    noise_gain=0,  # PEC option
    max_sampling_overhead=100,  # PEC option
)

# Execute
program_pec._semantic_role = (
    "simulation"  # flag the program for the simulator
)
job_pec_results = noisy_executor.run(program_pec).result()

# post-processing
pec_slc_res = slc_pec_task.postprocess(job_pec_results)
full_pec_res = full_pec_task.postprocess(job_pec_results)
Compara los valores esperados mitigados y la sobrecarga de shots
El valor esperado ideal del circuito espejo es 1 por construcción, de modo que el sesgo de cualquier estimación es simplemente |1 - result|. Esta celda final imprime el sesgo y el número total de shots para tres escenarios en paralelo:
-
Sin mitigar: el valor esperado ruidoso en bruto, sin aplicar ninguna cancelación de errores.
-
PEC completo: cancelación de errores de sesgo cero usando el modelo de ruido inverso completo en cada capa, con la sobrecarga de muestreo γ² completa.
-
PEC+SLC: cancelación de errores guiada por las escalas locales de los shaded lightcones, tolerando el
bias_toleranceelegido a cambio de un número de shots sustancialmente menor.
Comparar las tres filas muestra el beneficio concreto de SLC: el sesgo mitigado de PEC+SLC se mantiene muy por debajo del sesgo sin mitigar, mientras que el número total de shots es significativamente menor que el que requirió PEC completo.
print(
    f"Unmitigated result bias: {np.abs(1 - unmitigated_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_unmit_res[0]['_meas'].shape[0] * job_unmit_res[0]['_meas'].shape[2]}"
)

print(
    f"Full PEC final result bias: {np.abs(1 - full_pec_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[1]['_meas'].shape[0] * job_pec_results[1]['_meas'].shape[2]}"
)

print(
    f"PEC+SLC final result bias: {np.abs(1 - pec_slc_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[0]['_meas'].shape[0] * job_pec_results[0]['_meas'].shape[2]}"
)
Unmitigated result bias: 36.88%, total shots ran: 6400
Full PEC final result bias: 0.97%, total shots ran: 48528
PEC+SLC final result bias: 1.46%, total shots ran: 24480