Simula la dinámica de Fermi-Hubbard 1D con conjuntos de flujo
Las funciones descritas en esta guía están disponibles actualmente solo en la API de Python. La funcionalidad equivalente estará disponible en la API de C en una versión futura.
Esta guía construye un circuito para la dinámica temporal del modelo de Fermi-Hubbard unidimensional, desde escribir el hamiltoniano hasta comprobar las densidades de sitio evolucionadas. Lo que hace interesante este camino es una única idea, tomada del framework de conjuntos de flujo de Gandon et al. [1], el trabajo que también motivó el TransferVertexOperator de este paquete:
En lugar de agrupar los términos del hamiltoniano después del mapeo de fermión a qubit, agrúpalos antes, en conjuntos de flujo: subconjuntos unidimensionales del grafo de interacción fermiónico dirigido cuyos operadores de transferencia conmutan entre sí.
Esa decisión lo determina todo a continuación. Requiere lo siguiente:
-
Una codificación personalizada de fermión a qubit adaptada a los conjuntos de flujo, que aquí gasta un qubit ancilla para que el número de qubits asociado a la implementación de un término dado del hamiltoniano ya no crezca con el número de modos fermiónicos (como ocurre con Jordan-Wigner (JW)).
-
Una síntesis personalizada que aprovecha la conmutatividad dentro de cada conjunto. La recompensa es un circuito cuya profundidad de dos qubits es constante en el tamaño del sistema, frente al crecimiento lineal de una trotterización término a término basada en JW.
La maquinaria que lleva una codificación propia al transpilador (CustomF2QLayout y MapperFnEvolutionSynthesis) se traslada a cualquier modelo.
La guía de transpilación para las etapas del transpilador a las que se hace referencia a lo largo del texto, y la guía de mapeadores para la receta general de escritura de un mapeador personalizado.
Operadores de transferencia y conjuntos de flujo
Un TransferVertexOperator se construye a partir de operadores de vértice y operadores de transferencia . En términos de operadores fermiónicos de creación y aniquilación,
así que mide la ocupación del modo (vale cuando está vacío y cuando está lleno), mientras que transfiere un fermión a lo largo de la arista dirigida . Ten en cuenta que los dos índices de no son intercambiables. El primer índice lleva la combinación con signo menos y el segundo la de signo más, lo que hace que sea distinto de y da a la arista su orientación.
Estos satisfacen relaciones de conmutación mixtas. Dos operadores de transferencia que actúan sobre sitios disjuntos conmutan trivialmente, ya que cada uno es un producto par de operadores fermiónicos. El caso interesante es el de un sitio compartido. Allí, los dos conmutan si las flechas fluyen a través de ese sitio (una llega, otra sale) y anticonmutan si chocan (ambas llegan, o ambas salen).
La regla se ve más fácilmente en una imagen. Dibujar los vértices como nodos y cada como una flecha de a da el grafo de interacción dirigido, aquí para la cadena de cuatro sitios que se usa a lo largo de esta guía, que incluye ambas orientaciones de cada enlace:

Sigue la regla en la figura. Fíjate en y , por ejemplo. Una flecha llega al sitio 2 y la otra sale de él, así que el fermión fluye directamente a través y los dos operadores conmutan. Fíjate en cambio en y . Ambas flechas apuntan hacia el sitio 2. Chocan, y esos dos anticonmutan.
Esto es lo que hace posibles los conjuntos de flujo. Elige un conjunto de flechas que formen un camino dirigido y cada par se encuentra cabeza con cola o no se encuentra en absoluto, de modo que todo el conjunto conmuta, aunque los operadores individuales se solapen en sitios compartidos. Evolucionar bajo un único conjunto de flujo no incurre, por tanto, en ningún error de Trotter, y como muestra el paso 7, también puede hacerse con profundidad de circuito constante.
1. El hamiltoniano de Fermi-Hubbard
El modelo de Fermi-Hubbard 1D sobre sitios (sin espín, con fronteras abiertas) es
Siguiendo la Ec. (9) de la Ref. [1], el término de salto es . La interacción es diagonal, por lo que se expresa mediante operadores de vértice usando :
Ambas partes se construyen directamente como un TransferVertexOperator. Ten en cuenta que se almacena como la entrada diagonal (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Los sitios interiores adquieren un coeficiente de en porque aparecen en dos enlaces, mientras que los sitios de frontera solo aparecen en uno. Cada término enumerado aquí aparece en el grafo dibujado arriba. Los términos T(j,k) son sus flechas, y los términos V(j) sus nodos.
2. Partición en conjuntos de flujo
A continuación, etiqueta cada término con el conjunto de flujo al que pertenece. El atributo groups existe con este fin. Una compuerta Evolution sobre un operador agrupado se descompone en una Evolution por grupo (el paso 6 lo aprovecha), de modo que la agrupación decidida aquí a nivel fermiónico sobrevive en el circuito.
Para la cadena 1D, los dos conjuntos de flujo de salto son las flechas orientadas al este () y las orientadas al oeste (). Los términos diagonales de interacción conmutan con todo lo diagonal y forman un tercer grupo:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Los grupos 0 y 1 son los dos conjuntos de flujo. Cada conjunto es un camino dirigido a lo largo de la cadena, por lo que, por la propiedad de flujo, todos los términos dentro de un grupo conmutan.
Cada grupo también tiene que ser hermítico por sí solo, ya que una fórmula de producto exponencia los grupos por separado y solo un factor hermítico tiene una evolución unitaria. groups_are_hermitian() lo confirma:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Vale la pena detenerse en esto, porque los dos grupos de salto son unidireccionales: el grupo 0 contiene solo términos orientados al este y el grupo 1 solo términos orientados al oeste. Dividir un hamiltoniano de ese modo normalmente rompería la hermiticidad, ya que necesita a su pareja conjugada a su lado. Un TransferVertexOperator evita el problema porque ya es hermítico por sí solo. Es un producto de dos operadores de Majorana (consulta su definición en el paso 1), no un simple , así que su imagen de Jordan-Wigner lleva un coeficiente real en lugar de uno imaginario. Elegir esta representación de operadores es, por tanto, lo que hace que un conjunto de flujo unidireccional sea un factor de Trotter legítimo.
Las etiquetas este/oeste usadas a lo largo de esta guía son geométricas, con la cadena dibujada de izquierda a derecha y los índices de modo aumentando en esa dirección; apunta al este y apunta al oeste. La Ref. [1] es internamente inconsistente en esta denominación (su texto y sus figuras no coinciden), así que esta guía deliberadamente no sigue el texto, y en cambio mantiene las etiquetas de la figura. Al cotejar con el artículo, haz coincidir los conjuntos de flujo por sus pesos de Pauli (1 y 3 más abajo), no por los puntos cardinales.
3. Escribe la codificación personalizada
La sección IV B de la Ref. [1] clasifica las formas que puede adoptar una codificación local de fermión a qubit cuando se restringe a un conjunto de flujo. Jordan-Wigner simple usa qubits y mapea cada término de salto a un Pauli de peso 2. La clasificación muestra que gastar qubits adicionales compra estructura en los operadores codificados.
La codificación implementada aquí es la construcción de paridad deslocalizada del Apéndice B 2 (ecuaciones B4 y B5), que usa un qubit ancilla, de modo que . La paridad fermiónica se deslocaliza sobre un par de qubits:
El índice de la última expresión obliga a usar el qubit extra. El último enlace de la cadena tiene , así que su cae en el qubit , uno más allá del último modo fermiónico . Ese qubit final es el ancilla, y por eso y no . El mismo alcance aparece en , cuyo está en el ancilla para .
La recompensa se ve de inmediato: un conjunto de flujo completo se mapea a una suma de Paulis de peso 1.
Los prefactores quedan fijados por la normalización , y el signo menos relativo entre las dos orientaciones queda fijado por la identidad de producto , que los Paulis anteriores satisfacen. Equivocarse en cualquiera de las dos da un operador que cumple las relaciones de conmutación pero que ya no representa el mismo hamiltoniano, así que debes verificar la codificación numéricamente, como se muestra en el paso 4.
Escribir la codificación significa escribir una función que mapea un único operador de transferencia generalizado a una cadena de Pauli; map_transfer_vertex_generators() se encarga de la iteración sobre los términos y de su composición:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn espera la firma (operator, num_qubits), y el tipo de retorno debe ser un SparseObservable, lo que hace que la función sea directamente utilizable como plugin del transpilador. Consulta el paso 6.
Aplicarla al hamiltoniano del paso 1 da el operador codificado sobre qubits:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Hay 14 términos, de tres formas: el salto se ha convertido en X y ZXZ, la interacción en ZZ, y el [] inicial es la identidad, que solo aporta una fase global. Ten en cuenta que los términos ZZ alcanzan a los vecinos más cercanos y a los siguientes más cercanos; abarca los qubits a , que es el coste de deslocalizar la paridad.
Agrupar por conjunto de flujo expone la asimetría que compra la construcción. Enumera los pesos de Pauli presentes en cada grupo:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
El conjunto de flujo orientado al este (grupo 0) consta enteramente de Paulis de peso 1. Su evolución temporal es, por tanto, una capa de rotaciones de un solo qubit y no necesita compuertas entrelazantes, mientras que con Jordan-Wigner cada término de salto tiene peso 2 y las requiere. Este es el compromiso espacio-tiempo de la Ref. [1] en su forma más simple: un qubit extra convierte la mitad del hamiltoniano de salto en rotaciones de un solo qubit.
El conjunto de flujo orientado al oeste (grupo 1) lo paga con peso tres, y la interacción (grupo 2) está en peso dos, donde la entrada de peso cero es la identidad. Nada de esto es todavía una afirmación sobre un circuito; lo que una síntesis hace con estos pesos es el tema de los pasos 6 y 7.
4. Verifica la codificación
Una codificación personalizada solo es útil si es fiel, y una escrita a mano debe comprobarse. Como esta codificación usa qubits, el espacio de Hilbert de qubits es el doble de grande que el fermiónico, así que el hamiltoniano codificado no puede ser igual al de Jordan-Wigner término a término. Ambos se relacionan, en cambio, mediante una isometría.
De dónde viene la isometría: Con Jordan-Wigner, un estado base es la cadena de ocupación; el qubit contiene . Esta codificación, en cambio, almacena paridades acumuladas. Define
de modo que el bit registra la paridad de todas las ocupaciones hasta el sitio inclusive. Hay bits de este tipo para ocupaciones, de ahí viene el ancilla. La ocupación se recupera como la diferencia entre bits vecinos, . Un sitio ocupado aparece, por tanto, como una pared de dominio entre dos bits adyacentes, razón por la que se llama codificación de pared de dominio (o de Kramers-Wannier). Por eso también : el producto de dos vecinas lee esa diferencia.
Escribir este mapa para unos pocos estados hace concreta la estructura (ten en cuenta que está fijado, de modo que solo la mitad de los estados de qubit están en la imagen y, por tanto, se trata de una isometría y no de una unitaria):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Un único fermión en el sitio 0 invierte todas las paridades acumuladas por encima de él, que es la deslocalización en acción. Al reunir estas columnas en una matriz se obtiene la isometría , y la codificación es fiel cuando entrelaza los dos hamiltonianos:
Es decir, mapear un estado fermiónico al espacio de qubits y luego evolucionarlo allí debe dar el mismo resultado que evolucionarlo primero en el espacio fermiónico y mapearlo después.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
La relación de entrelazamiento se cumple exactamente, y por separado para cada conjunto de flujo. Esa segunda afirmación, más fuerte, es la que usan los pasos posteriores: una fórmula de producto evoluciona los grupos de uno en uno, y un producto de factores entrelazados es en sí mismo entrelazado, de modo que cualquier aproximación construida a partir de estos grupos coincide entre las dos codificaciones aunque las codificaciones difieran. Como corolario, los espectros deben coincidir, con cada autovalor de Jordan-Wigner apareciendo dos veces en el espacio mayor, una por cada valor de la paridad global sin restricciones:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Construir el circuito fermiónico
Antes de involucrar a ningún qubit, la dinámica se expresa a nivel fermiónico. Un FermionicCircuit actúa sobre modos fermiónicos en lugar de qubits, y una compuerta Evolution sobre el hamiltoniano es todo el circuito:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Hay una caja opaca sobre los cuatro modos, y lo interesante es en qué se descompone. El argumento synthesis indica cómo: FermionicLieTrotter es la fórmula de producto de primer orden, que divide el operador según sus groups y evoluciona cada grupo por turno. Así, la partición en conjuntos de flujo del paso 2 es la trotterización, y una sola llamada a decompose() la realiza, dando una compuerta Evolution por conjunto de flujo en el orden de los grupos: este, oeste y luego la interacción diagonal, con 3, 3 y 8 términos respectivamente.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
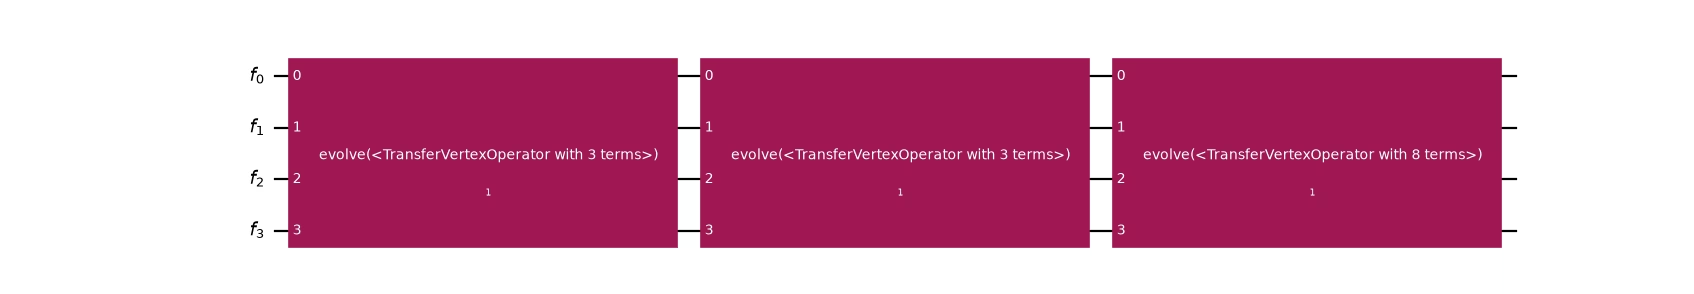
Ten en cuenta que todo esto ocurre por completo en el espacio fermiónico: todavía no se ha mencionado ningún qubit y la aproximación ya está hecha. Por lo tanto, el número de pasos de Trotter también pertenece aquí, como reps, que divide el tiempo y repite todo el barrido:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Nueve compuertas: los tres conjuntos de flujo, recorridos cíclicamente tres veces con un tercio del tiempo cada una. Ese ciclo es lo que lo convierte en una trotterización y no en una simple subdivisión de un grupo. Repetir un único grupo no lograría nada, ya que las exponenciales consecutivas del mismo operador conmutan, así que A(t/3) A(t/3) A(t/3) es simplemente A(t). Una fórmula que lee los grupos puede intercalarlos; una aplicada después del mapeo no puede, porque para entonces la agrupación ya se ha perdido.
Este es el paso que hace que la agrupación importe. Cada compuerta emitida se mapea y se sintetiza de forma independiente, así que todo lo que viene después actúa sobre la partición decidida a nivel fermiónico. Omitir la descomposición entrega todo el operador a la siguiente etapa y la agrupación se ignora.
6. Transpilar con la codificación personalizada
La codificación ya está lista para que la use el transpilador. Hacen falta dos piezas más:
-
Un layout. El
TrivialF2QLayoutpredeterminado supone un qubit por modo, lo cual es incorrecto en esta situación.CustomF2QLayoutasocia el registro fermiónico con unQuantumRegisterde distinto tamaño, que es la forma en que los qubits auxiliares entran en el flujo de trabajo. -
Un plugin de síntesis.
MapperFnEvolutionSynthesistoma directamente la función de mapeo, mapea con ella el hamiltoniano de la compuertaEvolutiony emite unaPauliEvolutionGate, preservando la convención . Suproduct_formuladecide cómo se convierte esa compuerta en rotaciones. Ten en cuenta que esta es una segunda fórmula de producto, independiente, que actúa sobre qubits después del mapeo: aquí se pasa elLieTrotterde Qiskit, y el paso 7 lo reemplaza por uno que conoce los conjuntos de flujo.
Dado que cada comparación posterior vuelve a ejecutar este flujo de trabajo, conviene encapsularlo una sola vez:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Cuatro modos fermiónicos se han convertido en un circuito de cinco qubits, con el auxiliar aportado por el layout personalizado.
Ahora veamos qué contiene realmente el circuito resultante. Al descomponer repetidamente, las compuertas de evolución se reducen hasta U y CX, de modo que el coste de dos qubits de las dos estrategias de síntesis que se comparan a continuación se mide en la misma moneda: count_ops() informa entonces del número de CX, y depth() acepta una función de filtro para medir la profundidad de dos qubits. Ten en cuenta que este reps es una profundidad de descomposición, sin relación con el número de pasos de Trotter que da una fórmula de producto, que más adelante en esta guía también se llama reps:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Veintiséis compuertas CX en veintitrés capas, es decir, casi nada se ejecuta en paralelo. Dibujar el circuito muestra por qué:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
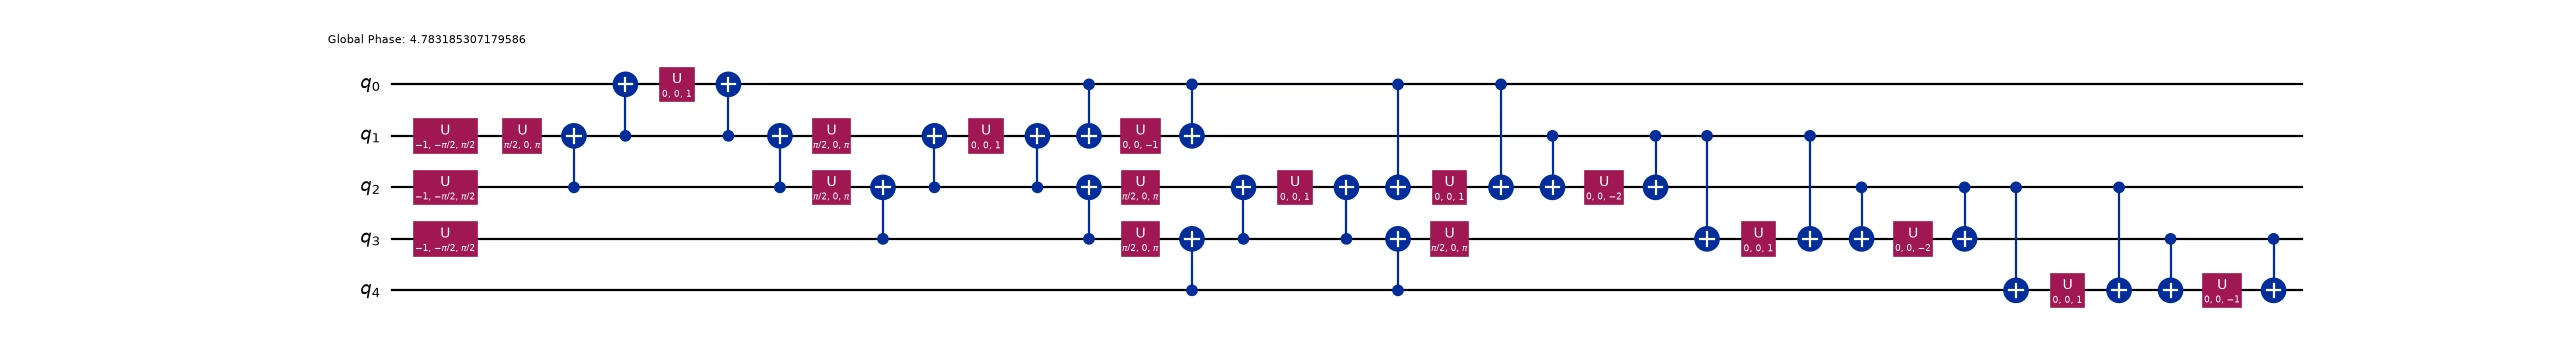
Cada término se ha compilado de forma aislada: un cambio de base, una escalera de CX hasta una única rotación y luego la escalera se deshace. El conjunto de flujo de peso 1 es gratuito; sus términos son rotaciones sueltas sin escalera alrededor, pero cada término de peso 3 cuesta cuatro compuertas CX, y como las escaleras se emiten secuencialmente, nada se solapa.
Así que la agrupación sobrevive a todo el flujo de trabajo (tres conjuntos de flujo, tres PauliEvolutionGate mapeadas) y aun así apenas aporta nada. La trotterización fermiónica del paso 5 cumplió su función; lo que la desperdicia es la fórmula del lado de los qubits. LieTrotter recibe un conjunto de términos sobre el que casualmente no se le dice nada, y compila cada uno de forma aislada. No puede saber que conmutan entre sí, así que serializa lo que podría compartir un cambio de base.
Esa es la brecha que esta codificación existe para cerrar: hay dos fórmulas de producto en juego, y hasta ahora solo la fermiónica ha recibido la estructura. El siguiente paso aporta una síntesis del lado de los qubits que también la aprovecha.
7. Una síntesis consciente de los conjuntos de flujo
Recuperar la ventaja significa informar a la síntesis del lado de los qubits sobre la estructura. Esto corresponde a la Sección IV C de la Ref. [1]: como todos los términos de un conjunto de flujo conmutan, pueden diagonalizarse simultáneamente con un único circuito de Clifford, rotarse en una base compartida y devolverse, en lugar de hacerlo una vez por término.
Para esta codificación, el Clifford es sencillo. Conjugar con una cadena de compuertas CZ entre vecinos más próximos transforma
simultáneamente para todo . Una cadena de CZ convierte todo el conjunto de flujo de peso 3 (oeste) en una capa de rotaciones independientes de un solo qubit. La interfaz EvolutionSynthesis solo exige un método synthesize(), que es lo único que implementa esta clase. No lleva ningún número de pasos de Trotter, porque recibe un conjunto de flujo cada vez y por tanto no puede subdividir la evolución entre los conjuntos. Esa subdivisión pertenece a un nivel superior, en el espacio fermiónico, donde un F2FSynthesisPlugin los ve todos a la vez (consulta el paso 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Dos detalles son fáciles de pasar por alto. Un EvolutionSynthesis personalizado debe exponer un atributo preserve_order, que lee el pase de síntesis de alto nivel.
Ambos auxiliares emiten sus compuertas en capas explícitas y no en el orden de los términos, porque depth() programa las compuertas lo antes posible, en el orden en que se añadieron. Como todas las compuertas de uno de estos conjuntos conmutan, el orden se puede elegir libremente. Una síntesis término a término elige mal el orden. Emitir la cadena de CZ solapada de forma secuencial da una profundidad que crece con el número de qubits en lugar de la constante 2 que el hardware podría lograr.
Por eso la síntesis anterior no lleva ningún número de pasos de Trotter. Recibe un conjunto de flujo por compuerta, así que una repetición dentro de ella repetiría dentro de un conjunto en lugar de alternar entre ellos:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
La primera forma no aporta nada: las exponenciales consecutivas del mismo operador conmutan, así que A(t/2) A(t/2) es simplemente A(t) y el error se mantiene en su valor de un solo paso por muchos pasos que se pidan.
Por lo tanto, el número de pasos pertenece al FermionicLieTrotter fermiónico del paso 5, que lee los groups y puede intercalarlos. Esa división del trabajo es el punto clave: la fórmula fermiónica decide cuántos pasos y en qué orden, y esta clase decide cuán barato se realiza cada conjunto resultante.
Para seleccionar el orden, pásalo a MapperFnEvolutionSynthesis.product_formula, que es el argumento que toma flow_set_pass_manager. Nada más del flujo de trabajo (ni del circuito fermiónico sobre el que se ejecuta) cambia:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
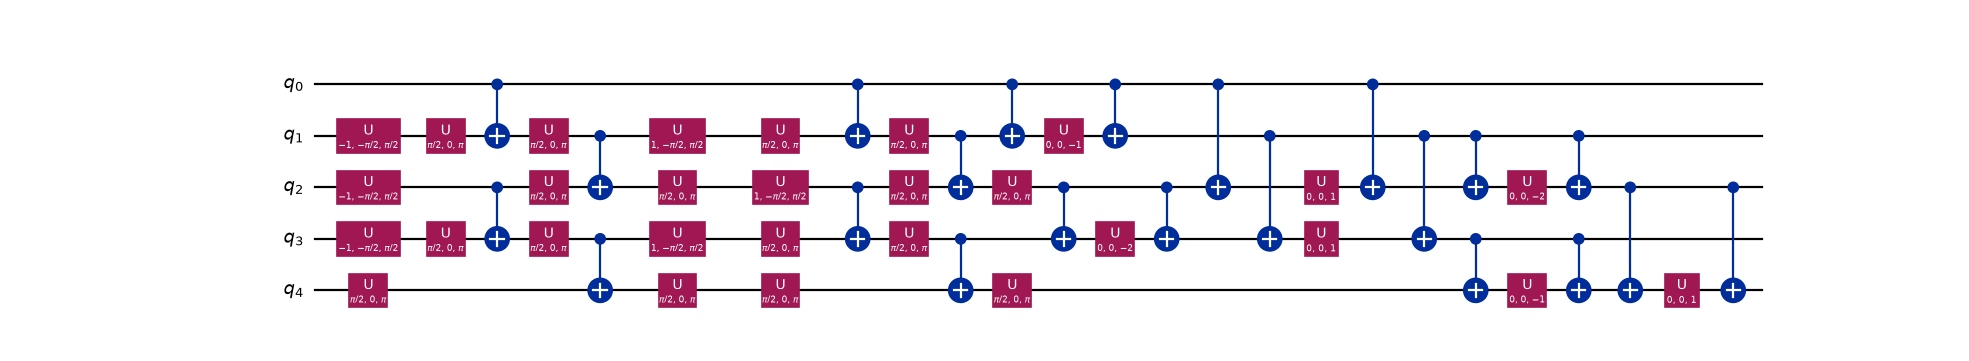
De profundidad 23 con 26 compuertas CX a profundidad 12 con 22 compuertas CX. Ten en cuenta que son menos compuertas entrelazantes y casi la mitad de profundidad. Al comparar las dos imágenes, la diferencia no es que las compuertas sean más baratas, sino que se apilan. Las escaleras en serie han desaparecido; las compuertas entrelazantes ahora se sitúan unas sobre otras en capas compartidas, porque todo el conjunto de flujo oeste se rota en una única base compartida y la interacción se emite en capas de pares disjuntos.
FlowSetSynthesis busca patrones en índices de qubit absolutos, lo cual aquí es seguro solo porque cada conjunto de flujo de este hamiltoniano abarca todo el registro. Una fórmula de producto fermiónica reduce cada factor a los modos que realmente toca, así que una agrupación cuyos conjuntos cubrieran solo parte de la cadena llegaría reetiquetada y los patrones anteriores no coincidirían.
Ambos dibujos muestran el circuito tras decompose(reps=6), que lo reescribe todo en la base U y CX, por lo que las compuertas CZ, Rx y Rzz emitidas por FlowSetSynthesis no se ven como tales. Es deliberado: coloca ambos circuitos en la misma base, que es la única forma de que los recuentos y profundidades de dos qubits anteriores sean comparables. Lo que destaca en estas figuras es la estructura de capas, no las etiquetas de las compuertas.
8. Profundidad constante a escala
La pregunta interesante no es el recuento con cuatro modos, sino cómo escala. Las dos capas de CZ en ladrillo no crecen con la longitud de la cadena, así que la profundidad de dos qubits de un paso de Trotter debería ser constante. Medirla directamente sobre el hamiltoniano completo de Fermi-Hubbard, mucho más allá de lo que podría simularse por fuerza bruta:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
La profundidad de dos qubits se mantiene en 12 desde cuatro modos hasta 100, mientras que LieTrotter crece linealmente hasta 407. Los conjuntos de flujo le permiten paralelizar un poco dentro del flujo de trabajo, pero cada conjunto sigue trotterizándose término a término, de modo que el crecimiento solo se ralentiza, no se elimina:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

El número de compuertas crece linealmente en ambos casos (hay términos que aplicar, y eso es inevitable), pero la síntesis por conjuntos de flujo las aplica en un número constante de capas paralelas. Este es el resultado de profundidad constante de la Ref. [1].
La profundidad 12 se reparte entre los tres conjuntos de flujo como 0 + 4 + 8, para cualquier longitud de cadena. El conjunto de flujo este aporta cero; son simples rotaciones Rx. El conjunto oeste cuesta 4, por las dos capas de CZ en ladrillo de entrada y las dos de salida; si se omite la interacción, queda una profundidad de dos qubits de cuatro para cualquier longitud de cadena. Los ocho restantes son la interacción, cuyos términos Rzz actúan tanto sobre vecinos próximos como sobre segundos vecinos y por tanto necesitan cuatro capas disjuntas, cada una con un coste de dos compuertas CX. Cuatro es lo óptimo aquí: cada qubit interior lleva cuatro compuertas Rzz (dos con cada vecino y dos con cada segundo vecino) y solo puede participar en una a la vez, así que ninguna programación puede mejorarlo.
Dos tercios de la profundidad corresponden a la interacción, lo que muestra que esta codificación destaca en el salto y, por tanto, en la dinámica de una cadena de fermiones libres. Sin embargo, ten en cuenta que la interacción no conmuta con el salto. Omitirla no es una aproximación de Fermi-Hubbard sino un modelo diferente. Merece la pena explorar dónde cae el equilibrio para un problema dado.
9. Comprobar la dinámica
Bajo el mapeo de pared de dominio, un patrón de ocupación se convierte en una cadena de paridades acumuladas, de modo que el estado inicial se prepara de forma distinta que con Jordan-Wigner. Esta es una consecuencia práctica fácil de pasar por alto de deslocalizar la paridad. El auxiliar del paso 4 da la etiqueta correcta:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
Con el estado preparado, quedan dos preguntas, y conviene plantearlas por separado: ¿calcula la síntesis por conjuntos de flujo lo correcto, y lo calcula de forma más barata?
Veamos primero la corrección. FlowSetSynthesis y el LieTrotter de Qiskit reciben los mismos conjuntos de flujo codificados de la misma trotterización fermiónica, así que deben realizar la misma unitaria salvo una fase global. Los Clifford personalizados reorganizan el trabajo; no cambian el resultado. Los vectores de estado aleatorios detectan cualquier discrepancia mucho más barato que construir la unitaria completa:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Ambas mitades de esa comprobación importan. Un solapamiento de módulo unitario en un solo estado es necesario pero no suficiente: una síntesis que errara una fase dependiente del estado aún lo mostraría. Exigir la misma fase en varios estados aleatorios es lo que cierra la brecha. Comprobar más de un valor de reps también importa, ya que confirma que la concordancia sobrevive al intercalado de los conjuntos de flujo y no se cumple solo para un único barrido.
Así pues, la elección de la síntesis del lado de los qubits no tiene consecuencias para la precisión, lo que hace significativa una comparación de costes. La pregunta restante es qué aporta la codificación en su conjunto frente a la alternativa obvia: Jordan-Wigner simple sobre num_sites qubits, sin auxiliar ni Cliffords personalizados. Tanto la codificación como la síntesis del lado de los qubits difieren entre las dos columnas, pero la comprobación anterior mostró que esta última no puede afectar al resultado, así que lo que las fidelidades ponen a prueba es la codificación. Además, ambos flujos de trabajo parten de la misma trotterización fermiónica, de modo que cualquier diferencia de fidelidad indicaría un error y no un compromiso. Las dos columnas son las codificaciones, conjuntos de flujo frente a Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Lee primero la columna de fidelidad: idéntica, hasta el último dígito impreso, en dos espacios de Hilbert distintos con dos codificaciones distintas. Eso es la trotterización fermiónica que se transparenta. La aproximación quedó fijada en el paso 5, antes de elegir cualquiera de las codificaciones, así que ambos circuitos arrastran exactamente el error de una fórmula de primer orden sobre tres conjuntos de flujo, y este se reduce aproximadamente cuatro veces cada vez que se duplica el número de pasos.
En lo que sí difieren las codificaciones es en el coste, y el compromiso merece enunciarse con claridad. El conjunto de flujo gasta más compuertas entrelazantes: 22 frente a 18 con un paso. El auxiliar no es la razón, ya que no lleva ninguna compuerta de dos qubits propia. La razón es la interacción, exactamente como advertía el paso 3: deslocalizar la paridad convierte tres términos ZZ entre vecinos más próximos en siete que abarcan vecinos próximos y segundos vecinos, y cada uno cuesta dos compuertas CX. Ese es el precio de abaratar el salto.
También gana solo por poco en profundidad a este tamaño (12 frente a 14), porque cuatro modos es demasiado pequeño para que se vea el comportamiento asintótico. Lo importante es la escala medida en el paso 8: esa profundidad de 12 es constante, mientras que la profundidad de Jordan-Wigner crece con la cadena. Con 14 modos ya es 12 frente a 34.
Las llamadas a decompose() anteriores son esenciales, por dos razones independientes.
evolve() y Operator usan la definición exacta de una PauliEvolutionGate, sin pasar por una síntesis personalizada del lado de los qubits. Verificar contra un circuito sin descomponer informa de una fidelidad perfecta incluso para una síntesis deliberadamente incorrecta.
Lo mismo se aplica un nivel más arriba, a la síntesis fermiónica. Una compuerta Evolution que nunca se descompone pasa entera a la etapa de fermión a qubit, que la mapea sin consultar Evolution.synthesis en absoluto, por lo que reps no tendría efecto alguno sin avisar. trotter_steps del paso 5 realiza esa descomposición; un flujo de trabajo que fija el método con F2FSynthesis obtiene la misma expansión del pase.
Como comprobación cruzada final, las densidades de sitio calculadas en el espacio codificado deben reproducir el resultado de Jordan-Wigner. Esta comprobación trata de la codificación, no del circuito, así que no interviene ninguna aproximación de Trotter. Ambas evoluciones temporales se calculan de forma exacta, mediante exponenciación matricial de los respectivos hamiltonianos. Por lo tanto, cualquier discrepancia apuntaría a la codificación y no a una fórmula de producto:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Las densidades coinciden hasta diez decimales.
Qué debes llevarte
-
Agrupa antes de mapear. Los conjuntos de flujo se definen sobre el grafo de interacción fermiónico dirigido, de modo que la agrupación se elige mientras la estructura del problema sigue disponible. El atributo
groupsla lleva hasta el circuito, donde una sola llamada adecompose()la convierte en una compuertaEvolutionpor conjunto de flujo. -
Los auxiliares compran estructura. Gastar un qubit extra convierte todo un conjunto de flujo en Paulis de peso 1, cuya evolución no necesita compuertas entrelazantes. La Ref. [1] observa este compromiso de forma general. Razones mayores de qubits por fermión admiten circuitos de evolución menos profundos.
-
Una codificación personalizada es una función. Mapea un único operador de transferencia generalizado a una cadena de Pauli;
map_transfer_vertex_generators()yMapperFnEvolutionSynthesishacen el resto. -
El mapeo y la agrupación por sí solos no bastan. Dividir la evolución por conjunto de flujo solo ralentizó el crecimiento lineal de la profundidad; una síntesis término a término de cada conjunto seguía desperdiciando el hecho de que sus términos conmutan. Solo aportar un
EvolutionSynthesisconsciente de los conjuntos de flujo hizo constante la profundidad. Las codificaciones personalizadas, la agrupación y la síntesis personalizada son complementarias: las tres son necesarias. -
Dos fórmulas de producto, dos tareas.
FermionicLieTrotterfija la aproximación en el espacio fermiónico, donde la agrupación aún es visible, así que por sí sola determina el error de Trotter y el número de pasos. ElEvolutionSynthesisdel lado de los qubits decide entonces solo cuán barato se realiza cada conjunto: el paso 9 confirma que ambas opciones dan la misma unitaria. Separar ambas cosas es lo que permite ajustar la precisión y el coste de forma independiente. Consulta Sintetizar una compuerta Evolution en el espacio fermiónico. -
Verifícalo. Una codificación que satisface las relaciones de conmutación aún podría representar un hamiltoniano distinto si un prefactor o un signo es incorrecto. Comprobar una relación de entrelazamiento (o, de forma más barata, el espectro) lo detecta.
El FlowSetSynthesis anterior está escrito deliberadamente para esta codificación en una cadena 1D. Busca patrones en las etiquetas de Pauli concretas que produce la codificación y lanza un error ante cualquier otra, en lugar de recurrir silenciosamente a una fórmula de producto genérica. Una implementación general tiene dos mitades. Leer la estructura de los conjuntos de flujo a partir de los groups del operador es lo que ya hace un F2FSynthesisPlugin para una evolución. Derivar el Clifford diagonalizador a partir del grupo estabilizador, como se describe en la Sección IV C de la Ref. [1], es la mitad que sigue dependiendo de la codificación.
Además, deslocalizar la paridad hace que el término de interacción sea de peso 2 en lugar de diagonal en qubits individuales, que es el coste complementario de los términos de salto más baratos.
Siguiente: dos dimensiones
Todo lo anterior es unidimensional, y deliberadamente. En una cadena, los conjuntos de flujo son simplemente las dos orientaciones de las flechas, y la codificación necesita un único auxiliar. Ninguna de las dos simplificaciones sobrevive en dos dimensiones, que es donde hacen falta codificaciones locales.
En una red plana, un conjunto de flujo es un camino dirigido (o una unión de caminos dirigidos disjuntos en vértices) a través del grafo de interacción, y encontrar un conjunto pequeño de tales caminos que cubra cada arista se convierte en un problema combinatorio por derecho propio, en lugar de una clasificación de dos líneas. Las codificaciones también cambian de carácter; en lugar de un único auxiliar para toda la cadena, añaden uno por sitio o celda de la red. Verstraete-Cirac empareja cada sitio fermiónico con su propio qubit auxiliar, una razón de qubits por modo de , mientras que Derby-Klassen coloca uno en el centro de cada plaqueta impar, para una razón de . La disposición del registro tiene entonces una estructura genuinamente bidimensional, y el grupo estabilizador sobre el que hay que proyectar deja de ser trivial. El hamiltoniano codificado solo es fiel en un subespacio, lo que cambia tanto la preparación del estado como la receta de verificación del paso 4.
Las piezas que construye esta guía son las que se trasladan: CustomF2QLayout para un registro cuyo tamaño difiere del número de modos, map_transfer_vertex_generators() para la codificación en sí, MapperFnEvolutionSynthesis para integrarla en el transpilador, y un EvolutionSynthesis personalizado para que la estructura de los conjuntos de flujo dé fruto. Solo cambian la codificación y la descomposición en conjuntos de flujo.
La guía de conjuntos de flujo 2D continúa desde aquí, trabajando con la codificación de Verstraete-Cirac en una red cuadrada: cuatro conjuntos de flujo, un Clifford de profundidad 2 para cada uno y la proyección estabilizadora que necesita después la verificación.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.