Simula la dinámica de Bose-Hubbard con una codificación a elegir
Esta guía construye un circuito para la dinámica temporal del modelo de Bose-Hubbard unidimensional, desde escribir el Hamiltoniano hasta comprobar las densidades de sitio evolucionadas frente a una referencia exacta. Lo que hace interesante este enfoque es una sola idea:
No elijas una codificación de bosones a qubits al construir el circuito. Construye el circuito sobre modos bosónicos y deja que el transpilador decida cómo esos modos se convierten en qubits.
Para los bosones, casi siempre necesitas diferir la codificación. Un modo bosónico admite un número arbitrario de partículas, por lo que su espacio de Fock es de dimensión infinita y no existe ninguna codificación hasta que eliges primero una truncación (el número de niveles de ocupación que conservas). En el código, la truncación se da como la mayor ocupación que puede tener un modo, max_occupation , de modo que un modo que conserva los niveles tiene max_occupation = 2 y .
Eso convierte la truncación en un parámetro de la codificación, no de la física, y es un parámetro que querrás variar: si es demasiado pequeña, la respuesta es incorrecta; si es demasiado grande, el circuito es innecesariamente ancho. Si difieres la codificación al momento de la transpilación, puedes barrer la truncación sin cambiar el circuito, el Hamiltoniano ni la agrupación.
La guía de operadores para la estructura de datos de operadores, la guía de mappers para las codificaciones y la receta para escribir un mapper personalizado, y la guía de transpilación para las etapas del transpilador a las que se hace referencia a lo largo del texto.
La truncación y lo que cuesta
Cuando truncas un modo a niveles, rompes el conmutador canónico en el nivel más alto conservado [1], por lo que ninguna codificación es un isomorfismo de álgebras: una codificación bosónica asigna estados y operadores que actúan dentro del subespacio truncado. Dos consecuencias importan para todo lo que sigue:
-
debe acotar la ocupación alcanzable por la dinámica, no solo la del estado inicial.
-
El mapeo no conmuta con el orden normal, así que decide una vez si tu Hamiltoniano está definido en forma de orden normal y mantén la coherencia.
La guía de mappers deriva el defecto y muestra ambas consecuencias con código en ejecución.
1. El Hamiltoniano
El modelo de Bose-Hubbard en una red con enlaces es
con . La interacción cuenta pares de bosones en un sitio, por lo que requiere que un sitio contenga dos partículas a la vez. En orden normal, , que es la forma que se usa a continuación.
La geometría entra solo a través de la lista de aristas, así que nada es específico de una cadena:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Merece la pena comprobar primero dos propiedades. El Hamiltoniano debe ser hermítico para que sea unitario, y conserva el número total de bosones:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Ahora la cuestión bosónica: ¿cuántos niveles exige este operador?
>>> hamiltonian.max_occupation()
2
El término de interacción aplica dos operadores de creación a un mismo modo, por lo que un modo tiene que contener dos bosones para que el término actúe. Eso es una ocupación máxima de 2, que es el número que LevelSpec toma como su max_occupation. Un modo que conserva las ocupaciones tiene niveles, así que max_occupation >= 2 es el mismo requisito que .
Esta es solo una cota inferior: proviene de una única aplicación del operador, y la aplicación repetida a lo largo de una evolución temporal puede llegar más lejos. Descarta cortes que son sin duda demasiado pequeños, y el paso 6 determina, para este modelo y este estado, qué tan grande tiene que ser el corte. mode_occupations() informa de la cota para cada modo por separado, que es con lo que se compara un corte por modo.
2. Agrupar antes de mapear
La evolución se descompone con Trotter, y la forma en que se particiona el Hamiltoniano decide lo que recibe la síntesis. Dos consideraciones apuntan en la misma dirección.
Primero, una física: el término de salto individual no es hermítico. Solo lo es el par . Si evolucionas bajo un único término no hermítico, la operación no es unitaria, y el operador mapeado tendría coeficientes complejos que PauliEvolutionGate rechaza. Por tanto, los dos términos de salto de cada enlace deben permanecer juntos.
Segundo, una de eficiencia: todos los términos de interacción en sitio son diagonales en la base de ocupación y conmutan entre sí, así que pueden compartir un único grupo y sintetizarse juntos. Lo mismo ocurre con los enlaces que no tocan ningún sitio común. En una cadena, uno de cada dos enlaces forma un conjunto así: los enlaces 0 y 2 actúan sobre pares de modos disjuntos, por lo que sus términos de salto conmutan y pueden compartir un grupo, y el enlace 1 forma un grupo propio. Si agrupas los enlaces pares e impares, necesitas por tanto tres grupos, donde un grupo por enlace necesita cuatro. Menos grupos significan menos factores y también un circuito menos profundo: con el código de Gray y max_occupation = 2, la profundidad de dos qubits es 95 frente a 139. La red decide qué enlaces pueden compartir un grupo, y por eso la partición se elige aquí.
El atributo groups lleva esa decisión al circuito: una puerta Evolution sobre un operador agrupado se descompone en una subevolución por grupo. La partición se elige en el nivel bosónico, mientras la estructura de la red aún es visible, y sobrevive intacta al mapeo. La guía de agrupación cubre las comprobaciones que debe superar una agrupación.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Cada grupo debe ser hermítico en sí mismo, que es lo que aporta el emparejamiento anterior. groups_are_hermitian() comprueba todos los grupos en una sola llamada:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Para ver qué contiene cada grupo, sepáralos:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
La agrupación en pares e impares es una elección, y la alternativa es fácil de medir. Si das a cada enlace un grupo propio, necesitas cuatro grupos, y el mismo circuito cuesta entonces más profundidad de dos qubits. La profundidad se cuenta después de reducir el circuito con el código de Gray y max_occupation = 2, lo cual explica el paso 4:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. El circuito bosónico
Observa lo que no aparece en el circuito. No hay truncación, ni codificación, ni número de qubits. Actúa sobre cuatro modos bosónicos:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Los cables son modos bosónicos, no qubits. Observa que InitializeModes toma enteros, no indicadores: un modo puede contener cualquier número de bosones, por lo que un estado de Fock es una lista de números de ocupación.
Una sola llamada a decompose() convierte la agrupación del paso 2 en una puerta por grupo:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
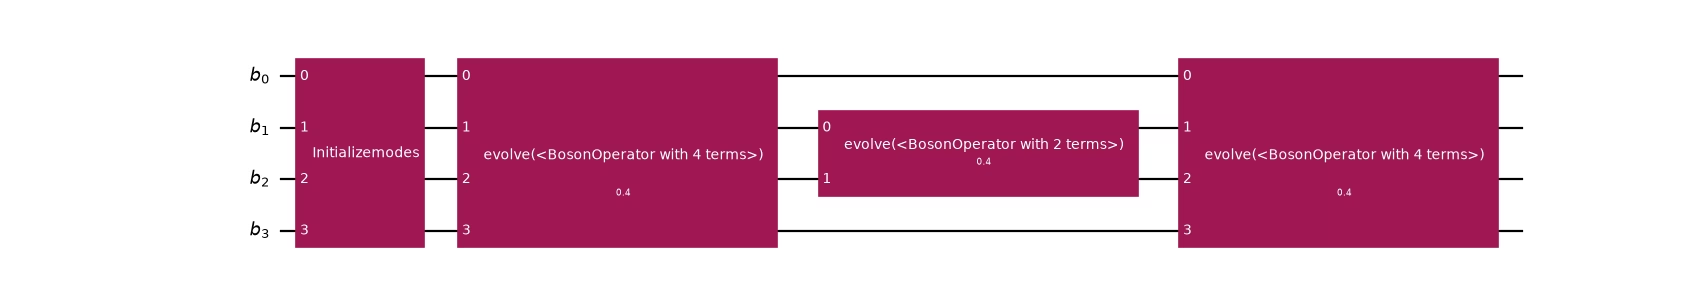
El primer grupo contiene los enlaces de los modos 0 y 1 y de los modos 2 y 3, así que su puerta abarca los cuatro modos, y lo mismo ocurre con el grupo en sitio. El enlace central tiene una puerta propia sobre los modos 1 y 2.
Si omites esa descomposición, la agrupación simplemente se ignora. El método que realiza la división es la synthesis de la puerta, con BosonicLieTrotter como valor predeterminado; Sintetizar una puerta Evolution en el espacio bosónico muestra las alternativas.
4. Elegir la codificación en el momento de la transpilación
Aquí está la recompensa. El mismo circuito se reduce cuatro veces, con cuatro valores distintos de LevelEncoding, cambiando un único argumento. Un LevelSpec empareja la codificación con la truncación de cada modo, y el siguiente preset deriva la disposición, la preparación de estados y el mapeo de operadores a partir de esa única especificación (consulta Describir la truncación con un LevelSpec). Una cadena como "gray" se acepta dondequiera que se acepte un LevelEncoding.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Estos números contradicen una suposición natural. Las codificaciones unarias usan qubits por modo frente a de los códigos compactos, y con los códigos compactos ganan en ambos aspectos a la vez: menos qubits y muchas menos puertas entrelazantes. Las dos variantes unarias difieren en el operador que emiten, no en su disposición: LevelEncoding.UNARY_PROJECTED lleva un proyector en cada otro qubit de un modo, lo que la convierte en la más costosa de evolucionar de las cuatro, y LevelEncoding.UNARY_UNPROJECTED omite los proyectores y coincide con ella en el subespacio one-hot. La guía de mappers muestra los dos operadores lado a lado y explica por qué el código de Gray supera al binario estándar (SB) en los términos de salto.
Sawaya et al. informan del mismo orden [2]:
aunque el código unario tiende a requerir más qubits pero menos operaciones, con frecuencia el SB o el código de Gray es más eficiente tanto en número de qubits como en número de operaciones
Su conclusión es que el mejor código depende del Hamiltoniano y de , lo que constituye el argumento más sólido para no fijar la elección en el circuito.
Bajo una codificación de niveles, un modo abarca varios qubits, por lo que el registro de qubits es más ancho que el registro de modos. El preset usa OccupationB2QLayout, que deriva el ancho del registro a partir del LevelSpec. La guía de transpilación recorre las etapas que ejecuta el preset.
5. Verificar frente a la dinámica exacta
Ninguno de los pasos anteriores establece que el circuito sea correcto. Para eso, compara las densidades de sitio tras la evolución con una referencia exacta calculada sobre el Hamiltoniano codificado.
La referencia debe calcularse en el mismo espacio truncado en el que trabaja el circuito, porque comparar con un cálculo sin truncar confundiría el error de Trotter con el error de truncación, que son cosas distintas y conviene separar (consulta Truncar el espacio de Fock).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Con esto en mano, la evolución exacta en el espacio truncado:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Los bosones se extienden desde el extremo ocupado de la cadena hacia el vacío, y los dos bosones se conservan:
>>> bool(np.isclose(sum(reference), 2.0))
True
Ahora el circuito. Observa que la referencia anterior se construyó directamente a partir de initial, por lo que el circuito que se compare con ella debe contener solo la evolución, porque la puerta InitializeModes volvería a preparar un estado que ya está preparado.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
El error se reduce a la mitad al duplicar el número de pasos, que es la firma de una fórmula de producto de primer orden. Esa es la prueba de que la discrepancia es error de Trotter y la codificación es fiel.
Las repeticiones provienen de la synthesis de la puerta, que aplica Trotter en el espacio bosónico donde la agrupación todavía existe: cada paso aplica cada grupo una vez, y los pasos se suceden uno tras otro. Eso es distinto de entregar un LieTrotter con reps > 1 al plugin de síntesis a nivel de qubits. Allí, cada grupo ya es su propio PauliEvolutionGate, por lo que la fórmula solo subdivide los términos dentro de un grupo y nunca intercala los grupos. Los grupos no conmutan entre sí, así que queda un único paso de Trotter externo cuyo error no se reduce por grande que sea reps. Sintetizar una puerta Evolution en el espacio bosónico compara ambos y cubre órdenes superiores.
La llamada anterior a decompose() es esencial. evolve() usa la definición exacta de un PauliEvolutionGate y omite por completo la fórmula de producto. Si verificas con un circuito sin descomponer, ves un acuerdo casi perfecto incluso con una síntesis deliberadamente errónea. El circuito sin descomponer también obliga a construir un operador denso de , mientras que un circuito descompuesto aplica las puertas una a una. Otros simuladores pueden tratar la puerta de forma distinta, por lo que esta comprobación depende del simulador, mientras que el hardware siempre necesita la forma descompuesta.
Por último, la comprobación central: la física no debe depender de qué codificación se eligió.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
El número de qubits, las estructuras de Pauli y las profundidades de circuito difieren, y la física coincide hasta diez decimales. La codificación es una elección de implementación, y por eso pertenece al transpilador. Las dos variantes unarias coinciden aquí porque el estado simulado permanece en el subespacio one-hot; fuera de él diferirían.
6. La truncación es un parámetro de convergencia
El último paso es específico de los bosones. Todo hasta ahora había fijado max_occupation = 2, es decir, . Sin embargo, la truncación no es una elección libre: es un parámetro de convergencia, y una respuesta solo es fiable cuando deja de moverse (consulta Truncar el espacio de Fock).
El circuito no lleva truncación, así que el circuito en sí no cambia cuando cambia el corte: solo se repite la transpilación. Lo que cambia es el tamaño de lo que sale, y un barrido solo es tan barato como aquí porque el sistema es diminuto. La siguiente referencia es una simulación clásica exacta de la dinámica truncada, que es posible para cuatro sitios y crece exponencialmente con el número de qubits. Para un problema fuera de ese alcance no hay una referencia exacta con la que comparar, y la convergencia debe juzgarse por otros medios.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
Con max_occupation = 1 () cada sitio contiene como máximo un bosón, por lo que el término de interacción, que necesita dos en un sitio, no puede actuar en absoluto, y las densidades se desvían unos . Al añadir el tercer nivel, el resultado captura la interacción, y a partir de max_occupation = 3 el resultado es estacionario hasta la precisión de máquina: convergido.
La razón por la que se detiene en max_occupation = 2 es el número de partículas. El Hamiltoniano conserva el número de bosones, y este estado contiene dos, por lo que ningún sitio puede contener nunca más de dos, sea cual sea el tiempo de evolución y tanto si la interacción es repulsiva como atractiva. Si evolucionas hasta en lugar de , o inviertes el signo de , las densidades con max_occupation = 2 y superior permanecen sin cambios hasta .
Lo que sí aumenta el requisito es el número de bosones. Tres bosones en la misma cadena cambian en unos entre max_occupation = 2 y 3 tras la misma evolución corta, y en unos tras . Esto es una afirmación sobre este modelo y una cantidad conservada, y es una cota solo para operadores que conservan el número de partículas; no es una regla general, así que el corte debe barrerse, no adivinarse.
El barrido también tiene un precio en el lado del circuito, que es lo que la referencia exacta no muestra. El mismo circuito bosónico, reducido con el código de Gray en cada corte:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Cada nivel adicional cuesta profundidad, y el número de qubits salta cada vez que pasa una potencia de dos. Al converger en , por tanto, cambias precisión por tamaño de circuito, así que el barrido es más que una comprobación numérica.
Ten en cuenta también que el hecho de que sea casi correcto es una coincidencia del observable: las densidades de sitio apenas se mueven, mientras que el estado subyacente es cualitativamente erróneo (no tiene componente doblemente ocupada). Que un observable converja no demuestra que otro haya convergido.
Qué debes llevarte
-
La codificación es una cuestión del transpilador. El circuito bosónico del paso 3 no menciona truncamiento, codificación ni número de qubits. Cuatro codificaciones lo redujeron entonces a cuatro circuitos distintos, todos con la misma física. Nada previo al transpilador tuvo que cambiar.
-
Para los bosones esto no es solo una comodidad. El truncamiento es un parámetro de convergencia que hay que barrer, y vive dentro de la codificación. Un circuito construido para una codificación fija tendría que reconstruirse para cada valor de .
-
Agrupa antes de mapear, y agrupa por hermiticidad. Un único término de salto no es hermítico y no se puede exponenciar; el par de enlace, en cambio, es hermítico y por tanto sí se puede exponenciar. Decide la partición a nivel bosónico, donde la red todavía es visible. Eso es físicamente necesario, y el atributo
groupsexiste para transmitir esa decisión. -
No des por hecho que la codificación de bajo peso es la barata. Con los códigos compactos superan a ambas variantes unarias tanto en qubits como en puertas a la vez, y la variante proyectada es la más costosa de todas. Mide; el punto de cruce depende de .
-
El truncamiento rompe el álgebra, de forma cuantificable. Solo en el nivel superior retenido, en . Esa es también la razón por la que el mapeo no conmuta con el orden normal.
Siguientes pasos
Dos direcciones amplían este ejemplo. Si sustituyes la lista de aristas de la cadena por los enlaces de una red cuadrada, no necesitas ningún otro cambio, porque la función bose_hubbard definida antes ya es independiente de la geometría. Una codificación personalizada propia (un código unario por bloques, por ejemplo, que interpola entre el unario y el compacto) también se integra mediante el mismo punto de extensión MapperFnEvolutionSynthesis que usa el preset.
-
Principios de diseño de las representaciones de operadores explica la estructura de datos del operador que hay detrás del hamiltoniano.
-
Mapear representaciones de operadores trata las codificaciones y cómo escribir tu propio mapeador.
-
Transpilar circuitos bosónicos recorre las etapas que ejecuta el preset.
-
Sintetizar una puerta de evolución en el espacio bosónico muestra cómo reducir el error de Trotter en el espacio bosónico.
Toda profundidad indicada corresponde a un registro abstracto y totalmente conectado. El mapeo a la conectividad real del hardware es una etapa aparte, y los bloques de qubits por modo de una codificación de ocupación dan al enrutador una estructura bastante distinta de la de un qubit por modo.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.