Detección de errores de baja sobrecarga mediante códigos espaciotemporales
En este tutorial implementaremos un flujo de trabajo para muestrear un circuito de Clifford y usar el paquete qiskit-paulice para aumentar la fidelidad de la distribución medida aplicando comprobaciones de Pauli espaciotemporales a lo largo del circuito. Las comprobaciones de Pauli espaciotemporales son similares a las comprobaciones de Pauli coherentes (CPC) en que un circuito de Clifford "carga útil" se entrelaza con algunos qubits auxiliares para "comprobar" ciertos invariantes del circuito. La medición de los auxiliares produce un síndrome que se usa para determinar si se detectó un error lógico durante la ejecución del circuito. Postseleccionar solo las muestras en las que no se detectó ningún error puede mejorar la fidelidad de las distribuciones muestreadas a costa de reducir las tasas de postselección. La diferencia clave entre las CPC y las comprobaciones espaciotemporales es que medir los síndromes de las CPC requiere medir operadores de alto peso localizados en el tiempo. En topologías de qubits con conectividad limitada, como la heavy hex, implementar estas comprobaciones requiere muchas puertas SWAP, lo que a menudo hace que el circuito sea demasiado profundo para ejecutarlo en la práctica. Implementar las comprobaciones de Pauli como códigos espaciotemporales permite distribuirlas a lo largo del circuito de carga útil, lo que permite una codificación de qubits eficiente para el hardware que sigue siendo eficaz para detectar errores lógicos durante la ejecución del circuito. La función principal del paquete qiskit-paulice es encontrar e insertar comprobaciones de Pauli espaciotemporales válidas en ubicaciones del circuito que maximicen la eficacia de detección de errores y minimicen la sobrecarga de qubits.
Este tutorial implementa un flujo de trabajo para aumentar la fidelidad de la distribución muestreada de un circuito cuántico mediante comprobaciones espaciotemporales. Como usaremos un circuito de Clifford, podemos estimar la fidelidad de forma directa a partir de los valores esperados promediados de los estabilizadores del circuito. Seguiremos estos pasos:
-
Crear un circuito: circuito de Clifford aleatorio poco profundo en forma de muro de ladrillos 1D, usado para visualizar las comprobaciones.
-
Identificar qubits como objetivos de las comprobaciones: asigna el circuito a qubits físicos de la QPU Heron
ibm_bostone identifica los qubits con auxiliares vecinos. -
Transpilar el circuito al Backend: selecciona una disposición de qubits y traduce las puertas del circuito al conjunto de puertas nativo de
ibm_boston. -
Crear un modelo de ruido a partir de los datos del Backend: genera un modelo de ruido aproximado basado en los datos de referencia del Backend. Estos datos de ruido se usarán para puntuar la eficacia de cada comprobación adicional.
-
Visualizar las comprobaciones de Pauli: añade algunas comprobaciones de Pauli al circuito poco profundo para poder visualizar cómo se añaden las comprobaciones.
-
Determinar los estabilizadores que medir: aumenta la profundidad del circuito para incrementar el impacto del ruido de las puertas. Muestrea aleatoriamente un subconjunto de estabilizadores del circuito más profundo.
-
Encontrar buenas comprobaciones para el estado completo: encuentra un conjunto de comprobaciones para los estabilizadores del estado que prepara el circuito. Tales comprobaciones son válidas sea lo que sea que se mida después, por lo que el mismo circuito con comprobaciones sirve para todos los estabilizadores muestreados.
-
Muestrear el circuito ruidoso: mide los circuitos sin comprobaciones y con comprobaciones en la base de cada estabilizador muestreado con samplomatic, y muéstralos con la primitiva
Executoren un simulador ruidoso que usa el mismo ruido despolarizante que se usó para encontrar las comprobaciones. -
Postseleccionar las muestras del circuito con comprobaciones sin errores detectados: elimina las muestras que fallan al menos una comprobación. Calcula los valores esperados del circuito ruidoso sin comprobaciones y del circuito que contiene comprobaciones.
-
Comparar las fidelidades de los estados ruidosos original y postseleccionado: muestra que postseleccionar solo las muestras sin errores detectados mejora la fidelidad estimada del estado ruidoso.
1. Crear el circuito
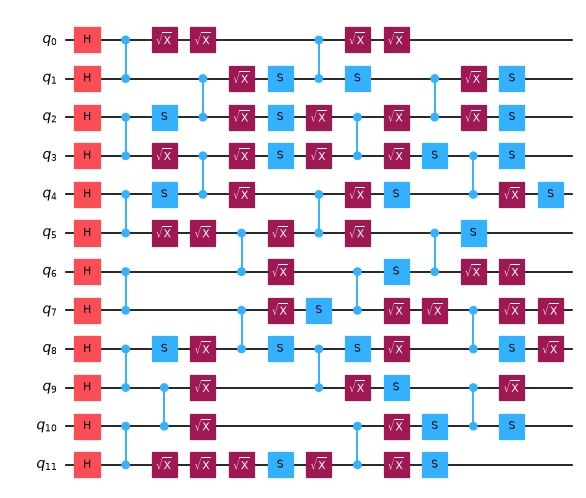
Primero, crearemos un circuito de Clifford poco profundo con sus puertas entrelazantes dispuestas en una conectividad de muro de ladrillos. Usaremos este pequeño circuito para visualizar cómo se añaden las comprobaciones al circuito.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_paulice": "qiskit-paulice", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
from qiskit import QuantumCircuit

def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)
circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.draw("mpl", fold=-1, scale=0.6)
2. Identificar qubits como objetivos de las comprobaciones
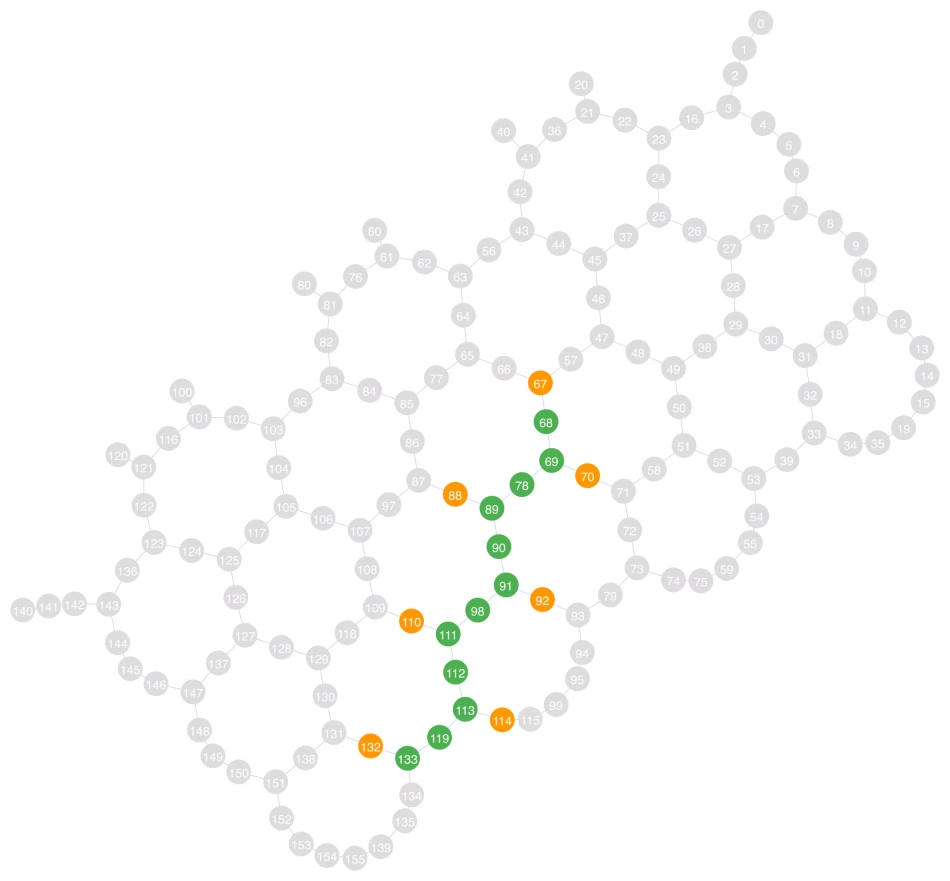
A continuación elegimos una disposición de qubits 1D en la QPU Heron r3, ibm_boston. Elegimos una disposición que zigzaguea en diagonal por el grafo de acoplamiento y maximiza el número de qubits auxiliares disponibles. Para encontrar los auxiliares disponibles, usamos la función get_check_qubits, que devuelve listas de pares qubit objetivo/auxiliar. Una comprobación de Pauli en target_qubits[i] se implementará usando ancilla_qubits[i].
En el grafo de acoplamiento siguiente, los qubits verdes son los qubits de la carga útil, y los qubits naranjas son los auxiliares que usaremos para implementar las comprobaciones. Los qubits 68, 69, 89, 91, 111, 113 y 133 tienen auxiliares adyacentes, así que usaremos esos qubits (correspondientes a los qubits virtuales 0, 1, 3, 5, 7, 9 y 11) como qubits objetivo para implementar las comprobaciones. Ten en cuenta que el qubit 134 es adyacente al qubit 133 en la carga útil pero no está resaltado como auxiliar. Esto se debe a que 133 ya fue elegido (arbitrariamente) para implementar una comprobación con el auxiliar 132.
from qiskit.visualization import plot_coupling_map
from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_paulice.layout import get_check_qubits

service = QiskitRuntimeService()
backend = service.backend("ibm_boston")

# Choose a layout and pair each available target qubit with a neighboring ancilla
layout = [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133]
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Target qubits:  [68, 69, 89, 91, 111, 113, 133]
Ancilla qubits: [67, 70, 88, 92, 110, 114, 132]
3. Transpilar el circuito al Backend
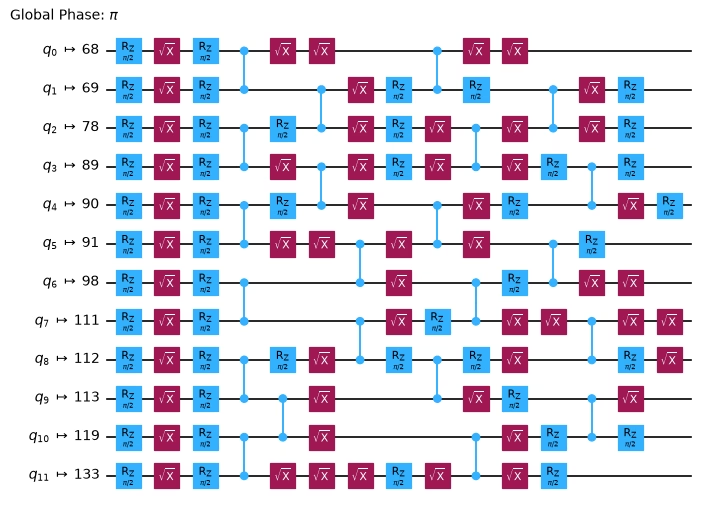
Como el Backend ya está elegido, podemos transpilar nuestro circuito virtual a un circuito ISA. Aquí solo establecemos la disposición de qubits y traducimos las puertas al conjunto de puertas nativo de ibm_boston.
from qiskit.transpiler import generate_preset_pass_manager

pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
4. Crear un modelo de ruido a partir de los datos del Backend
Ahora que sabemos cómo se dispondrá el circuito en la QPU, podemos modelar cómo afectará el ruido de las puertas y de la lectura del Backend a la ejecución del circuito. El modelo de ruido se usa para determinar los lugares óptimos del circuito donde colocar comprobaciones de Pauli. Queremos colocar las comprobaciones en posiciones donde capturen la máxima cantidad de error. Aunque un modelo de ruido más preciso puede mejorar la capacidad de detección de las comprobaciones, normalmente no es necesario aprender un modelo de ruido muestreando la QPU. Aquí inferimos un modelo uniforme de ruido de puertas despolarizante usando solo datos de referencia del Backend de qiskit-ibm-runtime, y descartamos el error de lectura que también reporta: las comprobaciones que encontramos en el paso 7 solo leen su auxiliar, por lo que los errores de lectura de la carga útil les resultan invisibles y solo reducirían la fidelidad postseleccionada en el paso 10. Consulta la documentación de qiskit_paulice.NoiseModel para más información sobre cómo especificar el ruido de puertas y de lectura. Para quienes deseen usar un modelo de ruido de Pauli-Lindblad aprendido, consulta NoiseModel.from_pauli_lindblad_maps.
from dataclasses import replace

from qiskit_paulice.noise_models import NoiseModel

# Model the gate noise as a uniform depolarizing channel based on backend benchmark data
noise_model = replace(
    NoiseModel.from_backend(backend, layout, uniform_gate_noise=True),
    readout_noise=None,
)
print(noise_model)
NoiseModel(gate_noise=0.0015808382794757693, readout_noise=None, idling_noise=None)
5. Visualizar las comprobaciones de Pauli
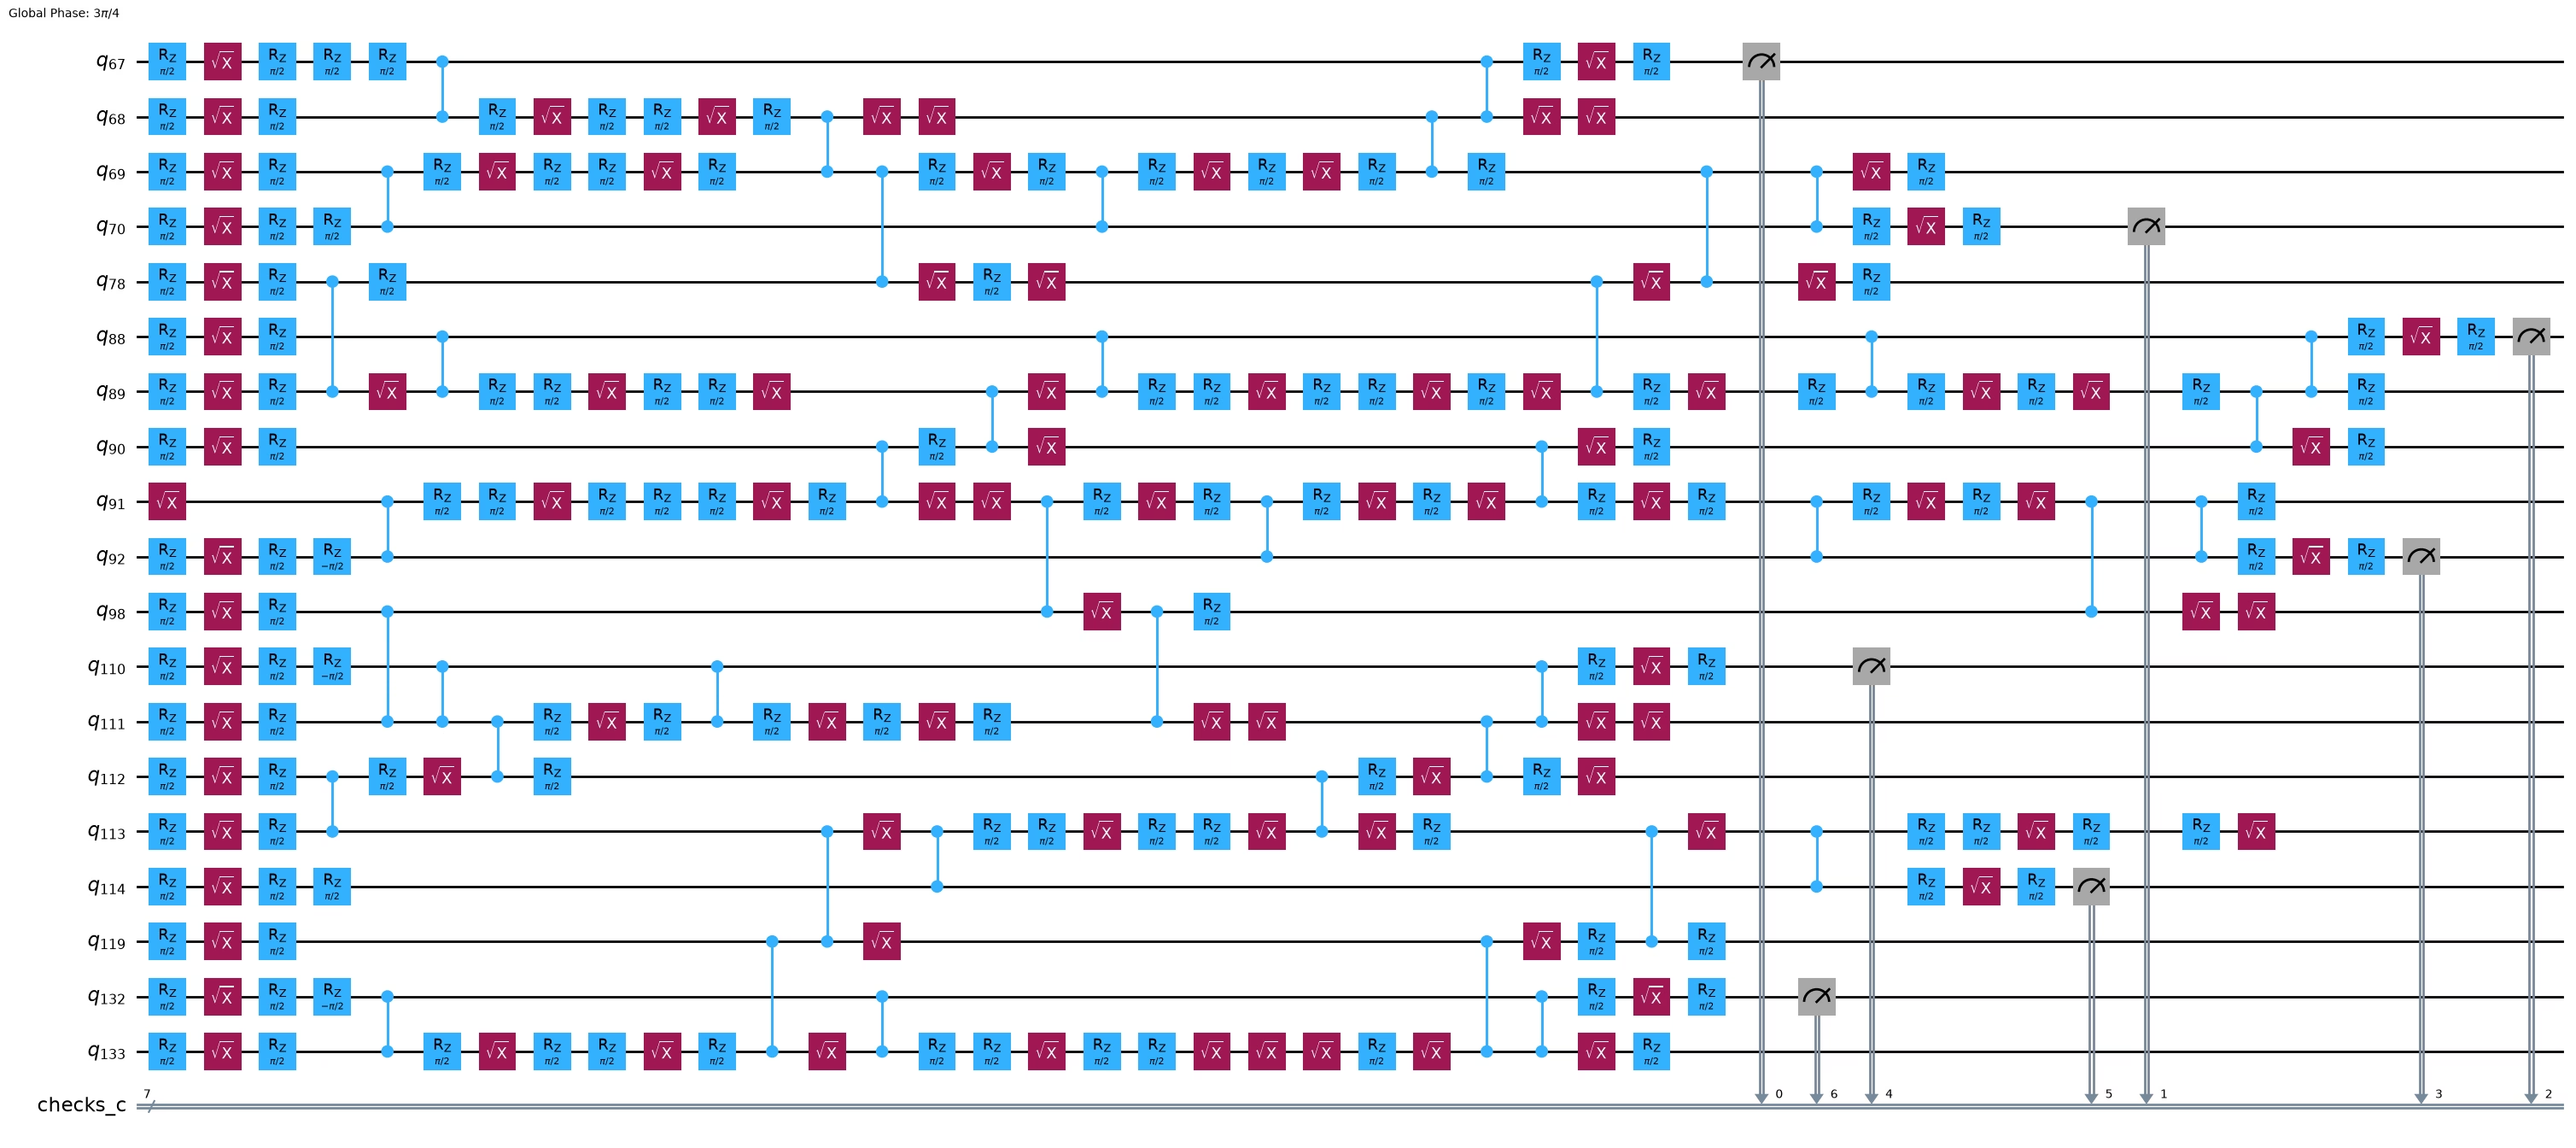
Ahora añadamos algunas comprobaciones al circuito y veamos qué aspecto tienen. Podemos usar la función qiskit_paulice.add_pauli_checks para encontrar un buen conjunto de comprobaciones válidas. Proporcionamos como entrada el circuito de Clifford de carga útil, junto con una lista de qubits de la carga útil en los que añadir comprobaciones (qubits objetivo) y el modelo de ruido que creamos en el paso anterior. En este ejemplo, añadiremos comprobaciones a los 7 qubits objetivo con auxiliares disponibles. Las comprobaciones se añaden a los qubits en el orden en que aparecen en target_qubits, lo que facilita razonar sobre la disposición final del circuito con comprobaciones: final_layout = layout + ancilla_qubits. Si un usuario decide que prefiere ejecutar uno de los circuitos de salida con menos (i) comprobaciones, la disposición final sería final_layout = layout + ancilla_qubits[:i+1].
La visualización del circuito muestra que las comprobaciones se implementaron correctamente usando los pares objetivo/auxiliar especificados.
Detalles sobre qiskit_paulice.add_pauli_checks:
- La primera entrada debe ser un circuito de Clifford. Aquí no tiene mediciones y pasamos
stabilizers="all", por lo que las comprobaciones se buscan para los estabilizadores del estado que prepara el circuito: una comprobación es válida si su producto de Pauli espaciotemporal mide uno de esos estabilizadores, su síndrome es únicamente su bit auxiliar, y sigue siendo válida sea cual sea la base en que se mida después la carga útil. Esto es lo que necesita una estimación de fidelidad, ya que cada estabilizador muestreado se mide en una base distinta. (Omitirstabilizershace que se busquen comprobaciones para las mediciones terminales de un circuito.) - El segundo argumento posicional es una lista de índices de qubits objetivo. Cada qubit objetivo compartirá puertas entrelazantes con un qubit auxiliar para formar una comprobación. Las comprobaciones se buscarán y añadirán al circuito en el orden en que se den en este argumento.
- El último argumento posicional es un modelo de ruido que representa el ruido que se espera que afecte al circuito durante la ejecución. Este modelo se usa para evaluar la eficacia de una comprobación dada.
ancilla_qubits: si el circuito de entrada tiene una disposición, este argumento con nombre indica aadd_pauli_checkscómo asignar qubits físicos a los auxiliares recién añadidos.ancilla_qubitsdebe tener la misma longitud quetarget_qubits(2.º argumento posicional), yancilla_qubits[i]debe usarse para implementar las comprobaciones entarget_qubits[i].cost: la función de coste usada para evaluar las comprobaciones. Puede sergammaoLER(tasa de error lógico), que son formas de describir cuánto del canal de ruido queda sin detectar por las comprobaciones. Constabilizers="all", un error cuenta como lógico si cambia el estado preparado, que es exactamente lo que mide la fidelidad.method: el método usado para encontrar comprobaciones válidas. Usamoswindowed, que muestrea aleatoriamente muchos subconjuntos de ventanas espaciales del soporte (hilos) de un qubit objetivo. Otros valores válidos songeneticywindowed_genetic.- La salida de
add_pauli_checkscontiene circuitos con números crecientes de comprobaciones, desde un circuito sin comprobaciones hasta un circuito con comprobaciones en cada qubit objetivo (suponiendo que se encuentren comprobaciones válidas).
Consulta las secciones II-IV de la información suplementaria para información detallada sobre cómo encontrar buenas comprobaciones de Pauli espaciotemporales
import matplotlib.pyplot as plt
from qiskit_paulice import add_pauli_checks

# Find checks on circuit
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
    stabilizers="all",
)

print(f"Physical layout of payload+ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload+ancillas: [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133, 67, 70, 88, 92, 110, 114, 132]
Checked circuit:
6. Determinar los estabilizadores que medir
Para probar el rendimiento de la detección de errores estimaremos la fidelidad del estado estabilizador, , que el circuito prepara idealmente, respecto al estado ruidoso, , que el hardware produce realmente. El proyector sobre el estado estabilizador puro, , se define como el promedio uniforme sobre los elementos de su grupo estabilizador :
Sustituyendo esto en la ecuación de la fidelidad, vemos que la fidelidad del estado ruidoso, , es equivalente al valor esperado promedio de todos los estabilizadores, , respecto a :
Para problemas más grandes, medir (o incluso enumerar) los estabilizadores es inviable, por lo que la fidelidad suele estimarse midiendo una muestra aleatoria de estabilizadores. Muestrear estabilizadores de forma uniformemente aleatoria de da un estimador insesgado de la fidelidad, ,
Para este experimento haremos el circuito mucho más profundo para realzar el efecto del ruido de las puertas, y añadiremos comprobaciones a cada qubit con un qubit auxiliar vecino. Aunque existen formas más sofisticadas de muestrear estabilizadores para estimar la fidelidad, en este ejemplo muestrearemos estabilizadores con probabilidad uniforme.
from qiskit.quantum_info import Clifford, Pauli, PauliList

num_stabilizers = 100
num_shots = 1_000
num_checks = len(target_qubits)
depth = 72

circuit = random_clifford_circuit(num_qubits, depth, rng)
# Create all 2^N stabilizers
stabilizers = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circuit).to_labels(mode="S")
):
    stabilizers = stabilizers + stabilizers.compose(generator)

# Choose some random stabilizers from the set
keep = np.where(stabilizers.x.any(axis=1) | stabilizers.z.any(axis=1))[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = stabilizers[chosen]
depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of {circuit.num_qubits}-qubit circuit with two-qubit depth of {depth}: {{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 100 stabilizers of 12-qubit circuit with two-qubit depth of 72: {-YIIYZZZIZIYY, -XIXYIIZXYIZX, ...}
7. Encontrar buenas comprobaciones para el estado completo
Encontramos un conjunto de comprobaciones para el circuito profundo exactamente igual que en el paso 5. Como las comprobaciones solo leen sus auxiliares, el mismo circuito con comprobaciones sirve para todos los estabilizadores muestreados. Los circuitos devueltos miden solo los auxiliares de las comprobaciones, así que añadiremos las mediciones de la carga útil en el siguiente paso.
import time

# Transpile the deep payload without measurements and find one set of checks for the whole state
payload_isa = pm.run(circuit)
t0 = time.time()
checked = add_pauli_checks(
    payload_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
    stabilizers="all",
)
print(
    f"Added {len(checked[-1].check_qubits)} checks in {time.time() - t0:.0f}s."
)
print(
    f"2-qubit depth increased from {payload_isa.depth(lambda x: len(x.qubits) == 2)} to "
    f"{checked[-1].circuit.depth(lambda x: len(x.qubits) == 2)} when adding {num_checks} checks."
)
Added 7 checks in 3s.
2-qubit depth increased from 72 to 85 when adding 7 checks.
8. Muestrear el circuito ruidoso
Muestreamos cada variante, desde la carga útil sin comprobaciones hasta el circuito con las 7 comprobaciones, para cada estabilizador muestreado. La variante con cero comprobaciones es la carga útil sin comprobaciones con las mismas mediciones, por lo que sirve como referencia ruidosa. En lugar de añadir la rotación de base de cada estabilizador a una copia de cada variante, dejamos que samplomatic elija la base de medición en el momento del muestreo. Para cada variante:
-
Medimos la carga útil y agrupamos las mediciones terminales en una caja con el pass manager de cajas de samplomatic. La caja lleva una anotación
ChangeBasis, por lo quebuilddevuelve un circuito plantilla cuyas puertas de cambio de base están parametrizadas, junto con un samplex que calcula los parámetros para una base solicitada. -
Añadimos la plantilla y el samplex a un
QuantumProgram. El samplex toma una base de medición por cada qubit de la caja, en orden físico ascendente, codificada como , , , . Pasar un array de bases con un eje inicial de longitud100hace que un único elemento mida los100estabilizadores: la carga útil en la base de cada estabilizador y los auxiliares en . Un qubit fuera del soporte de un estabilizador también se mide en , y su bit se ignora al calcular el valor esperado del estabilizador.
La primitiva Executor de qiskit-ibm-runtime ejecuta todo el programa en un solo job. Si se le da un AerSimulator en lugar de una QPU, se ejecuta localmente en ese simulador, así que le pasamos uno con el mismo ruido de puertas despolarizante que usamos para encontrar las comprobaciones, y usamos el método stabilizer, ya que todos los circuitos son de Clifford. Qiskit Aer solo es necesario para construir este simulador: el modo local toma la semilla de las opciones de Executor pero ignora su noise_model, por lo que el ruido debe establecerse en el propio simulador. Pasar un Backend de QPU ejecutaría el mismo programa en hardware. Una vez completadas las simulaciones, calcularemos la tasa de postselección y los valores esperados para hacernos una idea de lo bien que funcionó la detección de errores antes de visualizar los datos.
from qiskit import ClassicalRegister
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import depolarizing_error
from qiskit_ibm_runtime import Executor
from qiskit_ibm_runtime.quantum_program import QuantumProgram
from samplomatic.builders import build
from samplomatic.transpiler import generate_boxing_pass_manager

# Group the terminal measurements into a box whose measurement basis is chosen at sampling time
boxing_pm = generate_boxing_pass_manager(
    enable_gates=False, measure_annotations="change_basis"
)

# bases[i, q]: basis in which physical qubit q is measured for stabilizer i (I=0, Z=1, X=2, Y=3)
bases = np.ones((len(stabilizers), backend.num_qubits), dtype=np.uint8)
bases[:, layout] = stabilizers.z + 2 * stabilizers.x

program = QuantumProgram(shots=num_shots)
for variant in checked:
    circ = variant.circuit.copy()
    circ.add_register(meas := ClassicalRegister(num_qubits, "meas"))
    circ.measure(layout, meas)
    template, samplex = build(boxing_pm.run(circ))
    (basis_input,) = samplex.inputs().get_specs()
    measured_qubits = sorted(layout + list(variant.check_qubits))
    program.append_samplex_item(
        template,
        samplex=samplex,
        samplex_arguments={basis_input.name: bases[:, measured_qubits]},
        shape=(len(stabilizers),),
    )

# Simulate the program with the same gate noise we used to find the checks
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

# outs[k][register]: bits of the variant with k checks, shape (stabilizers, shots, bits)
t0 = time.time()
outs = (
    Executor(noisy_sim, options={"simulator": {"seed_simulator": seed}})
    .run(program)
    .result()
)
print(
    f"Sampled {len(checked)} circuits for {len(stabilizers)} stabilizers in {time.time() - t0:.0f}s."
)
Sampled 8 circuits for 100 stabilizers in 77s.
9. Postseleccionar las muestras del circuito con comprobaciones
En este paquete, una comprobación se implementa mediante puertas entrelazantes entre un qubit auxiliar y un qubit objetivo. Cada auxiliar comienza en , por lo que estabiliza su estado de entrada. Propagar hacia delante desde el inicio del auxiliar a través de todo el circuito con comprobaciones produce por un estabilizador del estado preparado, de modo que la comprobación se supera si el bit auxiliar es . Una muestra se conserva si se superan todas las comprobaciones.
Los circuitos con comprobaciones miden los auxiliares en el registro checks_c, por lo que una muestra se conserva si todos los bits de ese registro son 0. En general, el método get_postselection_method de las instancias de CheckedCircuit devueltas por add_pauli_checks asigna la cadena de bits de un shot al síndrome de todas las comprobaciones a la vez; para las comprobaciones encontradas para los estabilizadores del estado preparado, cada síndrome es simplemente su bit auxiliar, así que leemos el registro directamente.
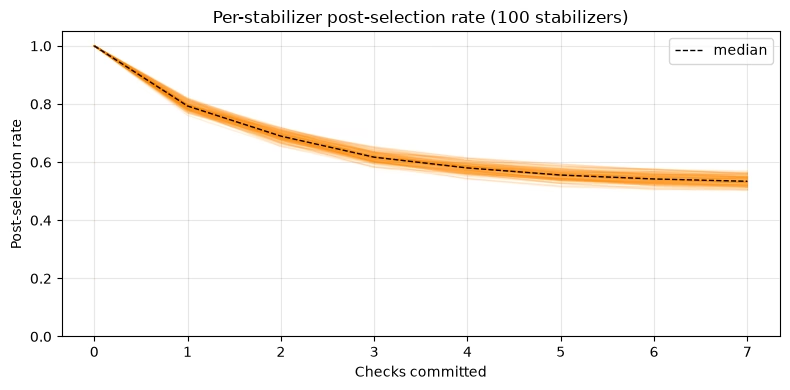
En el gráfico vemos que añadir más comprobaciones hace que la tasa de postselección disminuya. Aunque el objetivo de la detección de errores es capturar tantos errores como sea posible, a medida que baja la tasa de postselección pueden hacer falta más shots para alcanzar cierta precisión objetivo. Si la tasa de postselección baja demasiado, el número de shots necesarios para recoger una muestra lógica puede volverse prohibitivo. En este ejemplo, la tasa de postselección parece converger, lo que implica que las comprobaciones adicionales aportan cada vez menos capacidad de detección adicional. Aunque añadir más comprobaciones de Pauli generalmente ofrece mayor capacidad de detección de errores, supone un coste de mayor profundidad del circuito y un aumento del coste de muestreo.
def keep_mask(out):
    """Per-shot True/False: every ancilla read 0, so every Pauli check passed."""
    if "checks_c" not in out:  # the bare payload has no checks
        return np.ones(out["meas"].shape[:-1], dtype=bool)
    return ~out["checks_c"].any(axis=-1)

# masks[k][i]: kept shots of stabilizer i measured on the variant with k checks
masks = [keep_mask(out) for out in outs]
psrs_arr = np.array([mask.mean(axis=-1) for mask in masks]).T
ks = np.arange(psrs_arr.shape[1])

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, psrs_arr.T, color="darkorange", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.median(psrs_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set(
    xlabel="Checks committed",
    ylabel="Post-selection rate",
    ylim=(0, 1.05),
    title=f"Per-stabilizer post-selection rate ({len(psrs_arr)} stabilizers)",
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
10. Comparar las fidelidades de los estados ruidosos original y postseleccionado
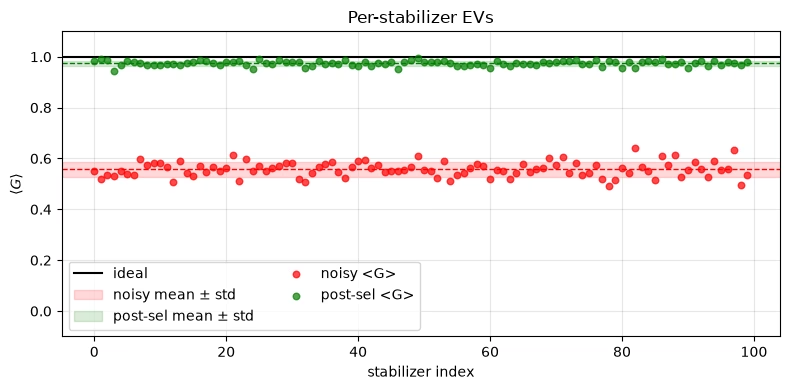
Vemos que postseleccionar solo las muestras sin errores detectados mejora enormemente el valor esperado de cada estabilizador y, por tanto, mejora la fidelidad estimada del estado estabilizador. Aunque los valores postseleccionados se calcularon usando solo las muestras que superaron todas las comprobaciones, los valores esperados son mucho más precisos y la varianza muestreada es menor. También podemos ver ahora que la tasa de postselección anterior en realidad convergía a un valor similar a la fidelidad del circuito ruidoso. La tasa de postselección convergía porque las comprobaciones capturaban la gran mayoría de los errores que realmente ocurrían durante la ejecución del circuito.
def expectation_values(out, mask):
    """EV of each stabilizer from the shots of ``out`` kept by ``mask``.

    Bit q of ``meas`` is virtual qubit q, so a stabilizer's eigenvalue in a shot is the parity of
    the bits in its support, times its sign.
    """
    support = stabilizers.x | stabilizers.z
    parity = (out["meas"] & support[:, None, :]).sum(axis=-1) % 2
    signs = np.where(stabilizers.phase == 2, -1.0, 1.0)
    eigenvalues = np.where(parity, -1.0, 1.0) * signs[:, None]
    kept = mask.sum(axis=-1)
    return np.where(
        kept > 0,
        (eigenvalues * mask).sum(axis=-1) / np.maximum(kept, 1),
        np.nan,
    )

evs_noisy = expectation_values(outs[0], masks[0])
evs_post = expectation_values(outs[-1], masks[-1])
print(
    f"ideal fidelity: 1.0\n"
    f"noisy fidelity: {np.nanmean(evs_noisy):.4f}\n"
    f"postselected fidelity: {np.nanmean(evs_post):.4f}\n"
    f"mean post-sel rate: {masks[-1].mean():.3f}\n"
)

evs_ideal = np.ones(len(stabilizers))
idx = np.arange(len(stabilizers))

def cum_mean_sem(ys):
    valid = ~np.isnan(ys)
    s = np.cumsum(np.where(valid, ys, 0.0))
    s2 = np.cumsum(np.where(valid, ys**2, 0.0))
    n = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = s / n
    sem = np.sqrt(np.maximum(s2 / n - mean**2, 0) / n)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean ± std"
    )
    ax.axhline(m, color=color, linewidth=1, linestyle="--")

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "post-sel")
ax.scatter(
    idx, evs_noisy, color="red", s=22, alpha=0.7, zorder=3, label="noisy <G>"
)
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    zorder=3,
    label="post-sel <G>",
)
ax.set(
    xlabel="stabilizer index",
    ylabel=r"$\langle G \rangle$",
    ylim=(-0.1, 1.1),
    title="Per-stabilizer EVs",
)
ax.legend(loc="lower left", ncol=2)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(stabilizers) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "post-sel"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set(
    xlabel="number of stabilizers averaged",
    ylabel="running fidelity estimate",
    title="Fidelity convergence vs. number of stabilizers",
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity: 1.0
noisy fidelity: 0.5582
postselected fidelity: 0.9747
mean post-sel rate: 0.535

Como un solo conjunto de comprobaciones sirve para todos los estabilizadores, solo hay una curva gamma que observar: el valor de la función de coste tras confirmar cada comprobación. Para otros problemas en un conjunto distinto de qubits físicos, y con un modelo de ruido imperfecto (recuerda que nuestro modelo de ruido en este tutorial modelaba exactamente el ruido que afectaba a las muestras), el orden en que se añaden las comprobaciones a los qubits objetivo puede tener un efecto más pronunciado en cómo converge la curva.
Que esta curva gamma converja a 1.0 implica que las comprobaciones adicionales no podrán detectar una cantidad importante de error adicional, ya que hay muy poco error modelado que las comprobaciones no cubran. Esto refuerza nuestra observación anterior de que la convergencia de la tasa de postselección se debe a la falta de error sin cubrir en el circuito.
costs = [variant.cost for variant in checked]

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(range(len(costs)), costs, color="steelblue", marker="o")
ax.set(
    xlabel="Checks committed",
    ylabel="Gamma",
    yscale="log",
    title="Gamma of the noise left uncovered by the checks",
)
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()
